Null Fehler, grüne CI, KI-Code: Wer hat das wirklich durchdacht?
🇬🇧 English • 🇮🇹 Italiano • 🇪🇸 Español • 🇫🇷 Français • 🇧🇷 Português
Ein Pull Request mit vierhundert Zeilen, grüne Pipeline, alle Tests bestanden, und ein Architekt lehnt ihn trotzdem ab. Was hat er gesehen, das die CI nicht sieht? Was sagen eine Studie von Anthropic und die Daten von GitClear über Code, der mit KI geschrieben wurde? Und was prüfe ich selbst, bevor dieser Code ins Repository darf?
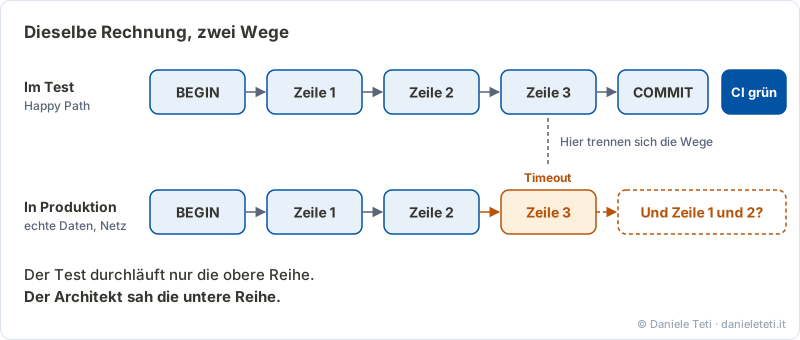
Es ist Freitagnachmittag. Ein Entwickler aus deinem Team öffnet einen Pull Request für das Fakturierungsmodul der Unternehmenssoftware: vierhundert neue Zeilen. Die CI ist grün, der Compiler meldet keine Warnungen, alle Unit-Tests laufen durch, die Namen sind sauber und über jeder Methode steht ein Kommentar. Im Ticket standen zwei Tage Arbeit, und nach anderthalb Stunden steht der Pull Request.
Du überfliegst die Zeilen und findest eine Transaktion, die mitten in einer Schleife geöffnet wird. Du rufst den Entwickler an und stellst ihm nur eine Frage: „Wenn die Datenbank bei der dritten Rechnungszeile in einen Timeout läuft, was passiert dann hier?“
Er schaut auf den Bildschirm und antwortet: „Das hat Claude geschrieben, die Tests laufen alle durch.“ Du klickst auf „Ablehnen“.
Die Szene ist erfunden, aber wer schon ein paar Code-Reviews gemacht hat, erkennt sie nach zwei Zeilen wieder. Dieser Artikel ist die schriftliche Fassung von Folge 11 des Podcasts (auf Italienisch). Für den Artikel habe ich die Quellen noch einmal gelesen. Zwei Zahlen, die ich in der Folge genannt habe, waren falsch: Hier stehen sie richtig, und auf der Seite der Folge gibt es eine Berichtigung.
In diesem Artikel
Was Kernighan sagt
Brian Kernighan und P. J. Plauger schreiben in The Elements of Programming Style, dass Debugging doppelt so schwer ist wie das Schreiben des Codes. Wenn du ihn mit deiner ganzen Intelligenz schreibst, bist du per Definition nicht intelligent genug, ihn zu korrigieren. Das ist meine Paraphrase, den genauen Wortlaut solltest du im Buch nachschlagen.
Kernighan sprach von Code, der von Hand geschrieben wird. Wenn du für eine Funktion alles aus deinem Kopf herausholst, brauchst du am Tag ihres Ausfalls in Produktion eine klügere Version von dir als die, die sie geschrieben hat. Die gibt es nicht.
Jetzt nimm den Teil weg, in dem du dein Gehirn anstrengst: Du drückst Enter, das Modell schreibt, du fügst ein. Um drei Uhr nachts, bei hängendem Server, musst du Code verstehen, über den du nie nachdenken musstest.
Die Quelldatei ist nur das, was von einem Gedankengang übrig bleibt. Der Rest ist die Karte, die du dir gezeichnet hast, während du dich durch Sonderfälle, Datenbank-Constraints und Abhängigkeiten zu anderen Modulen gearbeitet hast. Wenn du die Mühe des Schreibens überspringst, überspringst du auch diese Karte. Der Code landet in Git, kompiliert und geht in Produktion, aber im Kopf des Teams ist er eine Blackbox.
Die Studie von Anthropic
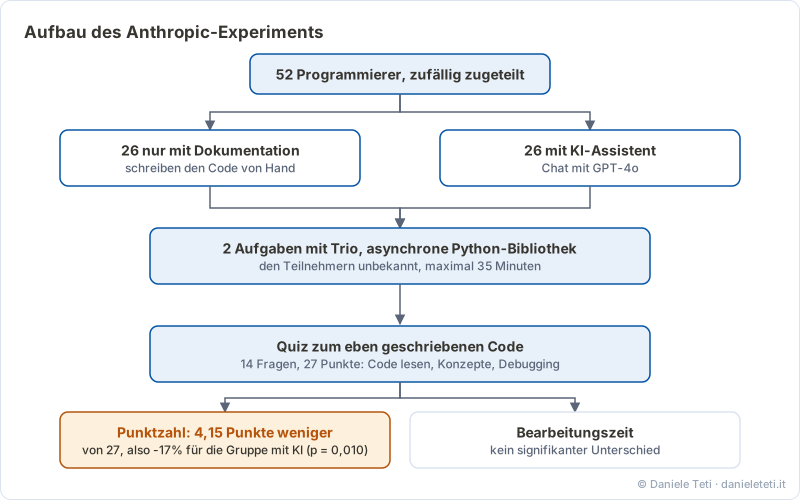
Judy Hanwen Shen und Alex Tamkin haben auf arXiv How AI Impacts Skill Formation veröffentlicht (arXiv:2601.20245, Januar 2026). So ist das Experiment aufgebaut:
- 52 Programmierer, 26 pro Gruppe, zufällig zugeteilt
- zwei Aufgaben mit Trio, einer Python-Bibliothek für asynchrone Nebenläufigkeit, die die Teilnehmer nicht kannten
- eine Gruppe nur mit der Dokumentation, die andere mit einem integrierten KI-Assistenten (GPT-4o)
- höchstens 35 Minuten für die Aufgaben, danach ein Quiz zum eben geschriebenen Code: Code lesen, Konzepte, Debugging
Das Quiz hatte 14 Fragen und 27 Punkte. Die Gruppe mit der KI hat 4,15 Punkte weniger erreicht, also 17% weniger. Der Unterschied ist statistisch signifikant (p = 0,010). Bei der Bearbeitungszeit finden die Autoren keinen signifikanten Unterschied.
Die Studie sagt nicht nur Unbequemes über die KI. In der zweiten Aufgabe sind 4 von 26 Teilnehmern ohne Assistent in 35 Minuten nicht fertig geworden, in der Gruppe mit der KI haben es alle geschafft.
Am meisten interessieren mich die Bildschirmaufzeichnungen. Die Autoren unterscheiden sechs Arten, den Assistenten zu benutzen. Bei den drei Arten, bei denen am meisten Gelerntes hängen blieb, stellt der Teilnehmer konzeptionelle Fragen oder bittet um Erklärungen, statt sich den Code geben zu lassen. Wer das ganze Schreiben delegiert hat, hat etwas Zeit gewonnen und die Bibliothek weniger gut gelernt. Die Autoren führen den Vorsprung der Kontrollgruppe auf die Fehler zurück, auf die die Teilnehmer gestoßen sind und die sie selbst behoben haben.
Eine Einschränkung, die zählt: Es waren online rekrutierte Leute, die eine neue Bibliothek gelernt haben. Die Studie sagt, was passiert, wenn du mit dem Assistenten etwas lernst. Sie sagt nicht, was mit einem Team passiert, das seinen Code seit fünfzehn Jahren kennt, und du solltest sie nicht so lesen, als würde sie das sagen.
Die Daten von GitClear
GitClear ist ein Unternehmen, das Repositories analysiert. Der Bericht The Maintainability Gap von 2026 deckt 623 Millionen Änderungen zwischen 2023 und 2026 ab. Das sind die Messwerte, die mich interessieren:
| Messgröße | Wert im Bericht |
|---|---|
| Verschobener Code (die Spur des Refactorings) | von 13% der geänderten Zeilen im Jahr 2023 auf 3,8% im Jahr 2026, etwa 70% weniger |
| Funktionsaufrufe zwischen verschiedenen Dateien (Indikator für Wiederverwendung) | 35% weniger als 2023 |
| Duplizierte Codeblöcke | 81% mehr als 2023 |
| Copy-Paste | von 9,4% (2022) auf 15,7% (erste Hälfte 2026) |
| Churn nach zwei Wochen (Code, der neu geschrieben oder zurückgenommen wird) | 15% mehr als 2023 |
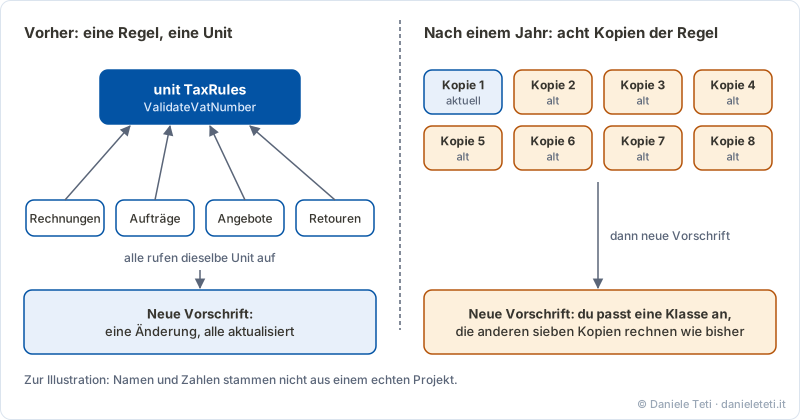
Der Wert zur Wiederverwendung erklärt, was in der Unternehmenssoftware passiert. Das Modell arbeitet gut mit den Dateien, die es im Kontext hat, kennt aber nicht die Geschichte eines Projekts, das seit fünfzehn oder zwanzig Jahren wächst. Du bittest es, einen Kundenrabatt zu berechnen oder eine Umsatzsteuer-ID zu prüfen, und es weiß nicht, dass drei Ordner weiter schon eine Unit liegt, die seit zehn Jahren bewährt ist, mit allen steuerlichen Ausnahmen. Es schreibt dir eine neue. Sie kompiliert, besteht den Test für den Basisfall, und im Projekt gibt es eine zweite Version derselben Regel.
Mit zehn Entwicklern und Hunderten von Commits im Monat hast du nach einem Jahr dieselbe Regel an acht Stellen, mit kleinen Unterschieden zwischen den Kopien. Wenn sich die Vorschrift ändert, aktualisierst du die Hauptklasse, und die anderen sieben Kopien rechnen weiter mit der alten Regel.
Zwei Vorbehalte beim Lesen dieser Tabelle. GitClear verkauft ein Analysewerkzeug, und der Bericht trennt nicht zwischen Code, den die KI geschrieben hat, und Code, der von Hand geschrieben wurde: Er misst den Zeitraum, in dem die Assistenten alltäglich geworden sind. Das ist eine Korrelation, kein Beweis dafür, dass die KI die Ursache ist. Auch die „Verdopplung des Churns“, die ich in der Folge zitiert habe, steht nicht in diesem Bericht: Es war eine Projektion für 2024 gegenüber 2021 aus dem vorherigen Bericht.
Warum Tests nicht reichen
Eine grüne CI sagt, dass der Code tut, was die Tests prüfen. Der Happy Path ist die Welt, in der die Daten sauber ankommen, die Datenbank in zwei Millisekunden antwortet, das Netz hält und niemand sonst deine Zeile ändert, während du daran arbeitest. In dieser Welt ist die KI richtig stark.
Eine Unternehmenssoftware verbringt den Tag außerhalb dieser Welt: Netzwerk-Timeouts, Deadlocks, halb offene Transaktionen, Dateien, die mit dem falschen Encoding importiert werden, Benutzer, die zweimal auf denselben Button klicken. Wenn du von Hand schreibst, steckt die Mühe darin: Alle drei Zeilen fragst du dich, was passiert, wenn die Verbindung abbricht oder die Abfrage leer zurückkommt.
Es gibt auch ein einfacheres Problem. Die Tests hat oft dasselbe Modell geschrieben, auf Basis derselben Annahmen, mit denen es die Funktion geschrieben hat. Sie prüfen den Fall, den es im Kopf hatte. Niemand hat gefragt, was passiert, wenn die Datenbank in einen Timeout läuft, und du erfährst es auf den echten Daten.
Drei Prüfungen vor der Freigabe
Ich werfe die KI nicht weg: Bei repetitivem Code, bei ergänzenden Tests und bei ersten Entwürfen spart sie ordentlich Zeit. Anders ist nur, was durchgehen muss, bevor Code ins Haupt-Repository darf. Die drei Prüfungen sind meine Methode, nicht das Ergebnis einer Studie.
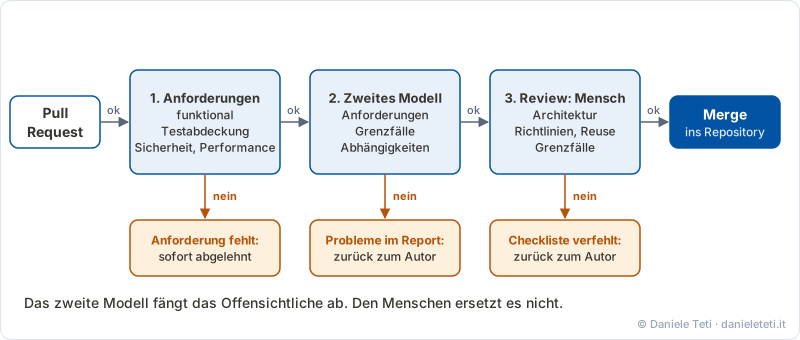
- Die verbindlichen Anforderungen. Der Pull Request muss vorher vereinbarte Kriterien erfüllen: funktionale Validierung, Mindest-Testabdeckung, Vorgaben zu Sicherheit und Performance. Fehlt eines, lehne ich ihn sofort ab.
- Ein Review mit einem anderen Modell. Ich gebe den Pull Request einem zweiten Modell, nicht dem, das den Code erzeugt hat, für eine erste Analyse von Anforderungen, Grenzfällen und Abhängigkeiten. Ist der Report positiv, mache ich weiter. Das ersetzt das menschliche Review nicht: Es nimmt mir die offensichtlichen Dinge ab, bevor ich selbst hinschaue.
- Das abschließende Review, von einer Person. Ich oder der dafür bestimmte Kollege, mit einer Checkliste: Architektur, Übereinstimmung mit den Projektrichtlinien, Wiederverwendung dessen, was schon existiert. Bei KI-Code prüfe ich außerdem, dass die Tests die Grenzfälle abdecken und nicht nur den Happy Path.
Wenn ich den Code selbst schreibe, mache ich es umgekehrt: Ich bitte die KI, den Gegner zu spielen. Ich sage ihr, sie soll Grenzfälle suchen, Fehlerbedingungen, ungewöhnliche Eingaben, alles, was außerhalb des Happy Path liegt.
Und der Pull Request vom Freitag?
Ihn abzulehnen wirkt wie Zeitverschwendung: Der Code ist da, und die Tests sind grün. Aber zwei Stunden am Freitag, um ihn mit den richtigen Klassen des Projekts neu zu schreiben und jeden Schritt zu verstehen, kosten weniger als drei Tage Notfalleinsatz sechs Monate später, wenn das Modul auf den echten Daten der Kunden läuft.
Als Nächstes empfehle ich dir, den zweiten Punkt bei deinem nächsten Pull Request auszuprobieren: Lass die Änderung von einem zweiten Modell prüfen, bevor du selbst hinschaust. Wenn du mit Delphi und DelphiMVCFramework arbeitest, steht im Beitrag über delphi-ai-skills, wie ich den Agenten die echte API des Frameworks beibringe. In der Folge Perché una modifica semplice ti costa tre mesi (auf Italienisch) geht es um die technischen Schulden, die sich im Code ansammeln.
Wenn du in deiner Firma komplexe Unternehmenssoftware oder Legacy-Architekturen weiterentwickeln musst und deinem Team eine konkrete Methode für den Einsatz von KI geben willst, ohne die Kontrolle über den Code zu verlieren, schreib an professionals@bittime.it. Bei bit Time Professionals begleiten wir technische Teams mit Architekturberatung und praxisnaher Schulung.
Quellen
- Shen, J. H., Tamkin, A., How AI Impacts Skill Formation, arXiv:2601.20245. Aufgaben und annotierte Transkripte im Repository der Studie.
- GitClear, The Maintainability Gap: AI Code Quality in 2026, gitclear.com. Für die Churn-Projektion 2024: Coding on Copilot.
- Kernighan, B. W., Plauger, P. J., The Elements of Programming Style, 2. Aufl., McGraw-Hill, 1978.
Kernfakten
- Thema: warum von KI generierter Code alle Tests und die CI bestehen und im Code-Review trotzdem abgelehnt werden kann, und welche Prüfungen man anwendet, bevor man ihn in ein System übernimmt, das Jahre halten muss. Schriftliche Fassung von Folge 11 des Podcasts „while true do;“ (auf Italienisch, 20.10.2026).
- Fall: ein Pull Request mit vierhundert Zeilen für das Fakturierungsmodul einer Unternehmenssoftware, grüne CI, bestandene Tests, eine mitten in einer Schleife geöffnete Transaktion, die kein Test prüft.
- Studie von Anthropic (Shen und Tamkin, arXiv:2601.20245, Januar 2026): 52 Programmierer (26 pro Gruppe), Aufgaben mit der Python-Bibliothek Trio, Gruppe mit KI-Assistent (GPT-4o) gegen Gruppe nur mit der Dokumentation. Quiz mit 14 Fragen und 27 Punkten zum geschriebenen Code: Die Gruppe mit KI hat 4,15 Punkte weniger erreicht, 17% weniger (p = 0,010). Kein signifikanter Unterschied bei der Bearbeitungszeit. In der zweiten Aufgabe sind 4 von 26 ohne KI in 35 Minuten nicht fertig geworden, alle Teilnehmer mit KI haben es geschafft. Die Nutzungsarten, bei denen am meisten Gelerntes hängen blieb, sind konzeptionelle Fragen und Bitten um Erklärungen. Einschränkung: online rekrutierte Teilnehmer, für alle eine neue Bibliothek.
- GitClear, The Maintainability Gap 2026 (623 Millionen Änderungen, 2023-2026): verschobener Code von 13% auf 3,8% der geänderten Zeilen (etwa -70%), Funktionsaufrufe zwischen Dateien -35%, duplizierte Blöcke +81%, Copy-Paste von 9,4% (2022) auf 15,7% (erste Hälfte 2026), Churn nach zwei Wochen +15% gegenüber 2023. Der Bericht trennt nicht zwischen KI-Code und menschlichem Code: Es ist eine Korrelation. Die in der Folge genannte Verdopplung des Churns war eine Projektion von 2024 gegenüber 2021, kein gemessener Wert.
- Drei Prüfungen des Autors (seine Methode, keine Studie): vorher vereinbarte verbindliche Anforderungen; Review mit einem zweiten KI-Modell, nicht dem, das den Code erzeugt hat; abschließendes menschliches Review mit Checkliste. Beim eigenen Schreiben nutzt er die KI als Gegner: Er lässt sie nach Grenzfällen, Fehlerbedingungen und ungewöhnlichen Eingaben außerhalb des Happy Path suchen.
- Autor: Daniele Teti, bit Time Professionals. Kontakt für Beratung und Schulung: professionals@bittime.it.
Comments