Cero errores, CI en verde, código de la IA: ¿quién lo ha pensado de verdad?
🇬🇧 English • 🇮🇹 Italiano • 🇩🇪 Deutsch • 🇫🇷 Français • 🇧🇷 Português
Una Pull Request de cuatrocientas líneas, pipeline en verde, todos los tests pasan, y un arquitecto que la rechaza igual. ¿Qué ha visto que la CI no ve? ¿Qué dicen sobre el código escrito con IA un estudio de Anthropic y los datos de GitClear? ¿Y qué compruebo yo antes de dejar entrar ese código en el repositorio?
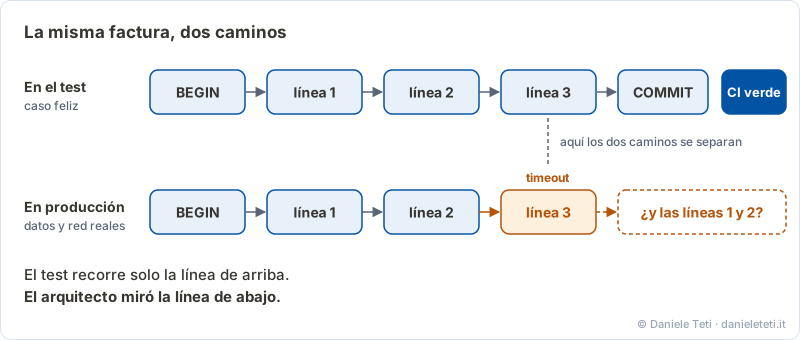
Es viernes por la tarde. Un desarrollador de tu equipo abre una Pull Request en el módulo de facturación del software de gestión: cuatrocientas líneas nuevas. La CI está en verde, el compilador no da advertencias, los tests unitarios pasan todos, los nombres están cuidados y hay un comentario encima de cada método. El ticket decía dos días de trabajo, y en una hora y media está listo.
Recorres las líneas y encuentras una transacción abierta a mitad de un bucle. Llamas al desarrollador y le haces una sola pregunta: “Si la base de datos da timeout en la tercera línea de la factura, ¿qué pasa aquí?”.
Él mira la pantalla y responde: “Me la ha escrito Claude, los tests pasan todos”. Tú pulsas “rechazar”.
La escena es inventada, pero quien ha hecho algunas code reviews la reconoce en dos líneas. Este artículo es la versión escrita del episodio 11 del podcast (en italiano). Para escribirlo he releído las fuentes, y dos números que dije en el episodio eran incorrectos: aquí están corregidos, y hay una fe de erratas en la página del episodio.
En este artículo
Qué dice Kernighan
Brian Kernighan y P. J. Plauger, en The Elements of Programming Style, escriben que depurar es el doble de difícil que escribir el código. Si lo escribes usando toda tu inteligencia, por definición no eres lo bastante inteligente para corregirlo. Esa es mi paráfrasis. La formulación exacta deberías comprobarla en el libro.
Kernighan hablaba de código escrito a mano. Si para escribir una función exprimes el cerebro al máximo, el día que se rompe en producción necesitas una versión de ti más inteligente que la que la escribió. No existe.
Ahora quita la parte en la que exprimes el cerebro: pulsas Enter, el modelo escribe, tú pegas. A las tres de la madrugada, con el servidor bloqueado, tienes que entender un código que nunca has tenido que pensar.
El archivo fuente es solo lo que queda de un razonamiento. El resto es el mapa que te has hecho mientras arreglabas los casos particulares, las restricciones de la base de datos, las dependencias con los demás módulos. Si te saltas el esfuerzo de escribir, te saltas también ese mapa. El código acaba en git, compila y va a producción, pero en la cabeza del equipo es una caja negra.
El estudio de Anthropic
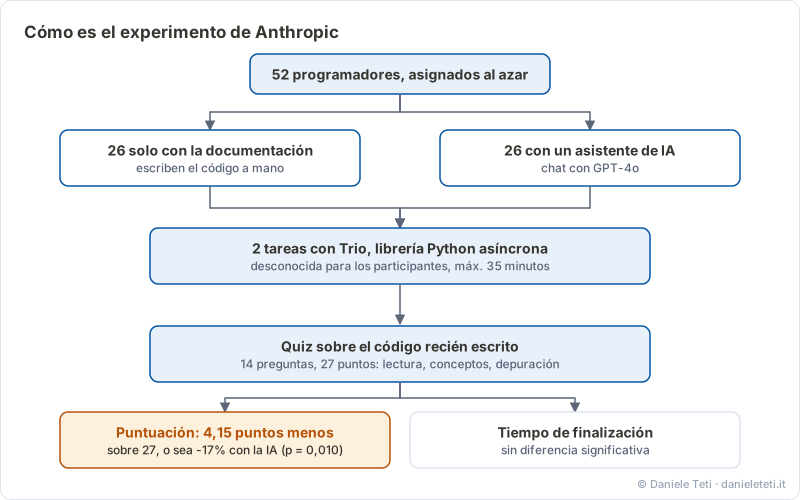
Judy Hanwen Shen y Alex Tamkin han publicado en arXiv How AI Impacts Skill Formation (arXiv:2601.20245, enero de 2026). Así está montado el experimento:
- 52 programadores, 26 por grupo, asignados al azar
- dos tareas con Trio, una librería de Python para la concurrencia asíncrona que los participantes no conocían
- un grupo con solo la documentación, el otro con un asistente de IA (GPT-4o) integrado
- 35 minutos como máximo para las tareas, luego un quiz sobre el código recién escrito: lectura del código, conceptos, depuración
El quiz tenía 14 preguntas y 27 puntos. El grupo con IA sacó 4,15 puntos menos, es decir, un 17% menos, con una diferencia estadísticamente significativa (p = 0,010). En cuanto al tiempo de finalización, los autores no encuentran una diferencia significativa.
El estudio no dice solo cosas incómodas para la IA. En la segunda tarea, 4 de los 26 participantes sin asistente no terminaron en 35 minutos, mientras que en el grupo con IA terminaron todos.
La parte que más me interesa son las grabaciones de las pantallas. Los autores distinguen seis formas de usar el asistente. En las tres formas que mejor conservaron el aprendizaje, el participante hace preguntas conceptuales o pide explicaciones, en lugar de pedir que le den el código. Quien delegó toda la escritura ganó algo de tiempo y aprendió menos sobre la librería. Los autores atribuyen la ventaja del grupo de control a los errores con los que se toparon y que resolvieron por su cuenta.
Un límite, porque importa: eran personas reclutadas online que aprendían una librería nueva. El estudio dice qué pasa cuando aprendes algo con el asistente. No dice qué pasa con un equipo que conoce su propio código desde hace quince años, y no debe leerse como si lo dijera.
Los datos de GitClear
GitClear es una empresa que analiza repositorios. El informe The Maintainability Gap de 2026 cubre 623 millones de cambios hechos entre 2023 y 2026. Estas son las medidas que me interesan:
| Qué mide | Dato en el informe |
|---|---|
| Código movido (la huella del refactoring) | del 13% de las líneas modificadas en 2023 al 3,8% en 2026, aproximadamente un 70% menos |
| Llamadas de función entre archivos distintos (índice de reutilización) | un 35% menos respecto a 2023 |
| Bloques de código duplicados | un 81% más respecto a 2023 |
| Copiar y pegar | del 9,4% (2022) al 15,7% (primera mitad de 2026) |
| Churn a dos semanas (código reescrito o revertido) | un 15% más respecto a 2023 |
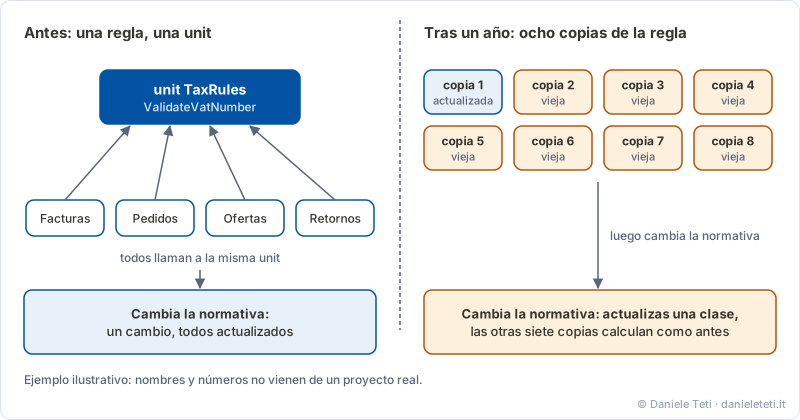
El dato sobre la reutilización explica lo que pasa en el software de gestión. El modelo trabaja bien con los archivos que tiene en el contexto, pero no conoce la historia de un proyecto que lleva quince o veinte años creciendo. Le pides que calcule un descuento de cliente o que valide un número de IVA, y no sabe que tres carpetas más allá ya hay una unit probada desde hace diez años, con todas las excepciones fiscales. Te escribe una nueva. Compila, pasa el test del caso base, y en el proyecto hay una segunda versión de la misma regla.
Con diez desarrolladores y cientos de commits al mes, al cabo de un año tienes la misma regla en ocho sitios, con pequeñas diferencias entre unos y otros. Cuando cambia la normativa actualizas la clase principal, y las otras siete copias siguen calculando con la regla vieja.
Dos precauciones al leer esta tabla. GitClear vende una herramienta de análisis, y el informe no separa el código escrito por la IA del escrito a mano: mide el periodo en el que los asistentes se han generalizado. Es una correlación, no la prueba de que la IA sea la causa. Tampoco está en este informe el “doble de churn” que cité en el episodio: era una proyección para 2024, respecto a 2021, del informe anterior.
Por qué los tests no bastan
Una CI en verde dice que el código hace lo que los tests comprueban. El caso feliz es el mundo en el que los datos llegan limpios, la base de datos responde en dos milisegundos, la red aguanta y nadie más modifica tu fila mientras trabajas en ella. En ese mundo la IA se desenvuelve de maravilla.
Un software de gestión pasa el día fuera de ese mundo: timeouts de red, deadlocks, transacciones colgadas a medias, archivos importados con la codificación equivocada, usuarios que hacen clic dos veces en el mismo botón. Cuando escribes a mano, el esfuerzo está ahí: cada tres líneas te preguntas qué pasa si se cae la conexión o si la consulta no devuelve nada.
Hay también un problema más simple. A menudo los tests los ha escrito el mismo modelo, con los mismos supuestos con los que escribió la función. Comprueban el caso que tenía en mente. Nadie ha preguntado qué pasa cuando la base de datos da timeout, y lo descubres con los datos reales.
Tres comprobaciones antes de aprobar
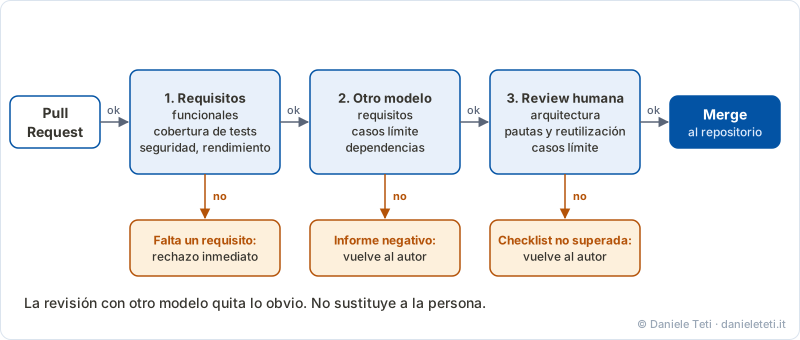
No descarto la IA: en el código repetitivo, en los tests accesorios y en los primeros borradores ahorra bastante tiempo. Lo que cambia es lo que debe pasar antes de entrar en el repositorio principal. Las tres comprobaciones son mi método, no el resultado de un estudio.
- Los requisitos obligatorios. La Pull Request debe cumplir criterios acordados antes: validación funcional, cobertura mínima de tests, restricciones de seguridad y de rendimiento. Si falta alguno, la rechazo de inmediato.
- Una revisión con otro modelo. Paso la Pull Request a un segundo modelo, distinto del que generó el código, para un primer análisis de requisitos, casos límite y dependencias. Si el informe es positivo, sigo adelante. No sustituye a la review humana: me quita lo obvio antes de que la mire yo.
- La review final, hecha por una persona. Yo o el compañero designado, con una checklist: arquitectura, coherencia con las directrices del proyecto, reutilización de lo que ya existe. Para el código escrito por la IA compruebo también que los tests cubran los casos límite y no solo el camino feliz.
Cuando el código lo escribo yo, hago lo contrario: le pido a la IA que haga de adversario. Le digo que busque los casos límite, las condiciones de error, las entradas anómalas, todo lo que queda fuera del camino feliz.
¿Y la Pull Request del viernes?
Rechazarla parece una pérdida de tiempo: el código está y los tests están en verde. Pero dos horas dedicadas el viernes a reescribirla con las clases correctas del proyecto, entendiendo cada paso, cuestan menos que tres días de emergencia seis meses después, con el módulo funcionando sobre los datos reales de los clientes.
El siguiente paso que te recomiendo es probar el segundo punto en tu próxima Pull Request: haz que un segundo modelo revise el cambio antes de mirarlo tú. Si trabajas con Delphi y DelphiMVCFramework, en el post sobre delphi-ai-skills cuento cómo les enseño a los agentes la API real del framework. El episodio en el que hablé de la deuda que se acumula en el código es Por qué un cambio simple te cuesta tres meses (en italiano).
Si en tu empresa tienes software de gestión complejo o arquitecturas legacy que tienen que seguir evolucionando, y quieres dar al equipo un método concreto para usar la IA sin perder el control del código, escribe a professionals@bittime.it: en bit Time Professionals acompañamos a los equipos técnicos con consultoría de arquitectura y formación sobre el terreno.
Fuentes
- Shen, J. H., Tamkin, A., How AI Impacts Skill Formation, arXiv:2601.20245. Tareas y transcripciones anotadas en el repositorio del estudio.
- GitClear, The Maintainability Gap: AI Code Quality in 2026, gitclear.com. Para la proyección del churn 2024: Coding on Copilot.
- Kernighan, B. W., Plauger, P. J., The Elements of Programming Style, 2.ª ed., McGraw-Hill, 1978.
Datos clave
- Tema: por qué el código generado por IA puede pasar todos los tests y la CI y aun así ser rechazado en code review, y qué comprobaciones aplicar antes de aceptarlo en un sistema que debe durar años. Versión escrita del episodio 11 del podcast "while true do;" (20/10/2026).
- Caso: una Pull Request de cuatrocientas líneas en el módulo de facturación de un software de gestión, CI en verde, tests que pasan, una transacción abierta a mitad de un bucle que ningún test comprueba.
- Estudio de Anthropic (Shen y Tamkin, arXiv:2601.20245, enero de 2026): 52 programadores (26 por grupo), tareas con la librería de Python Trio, grupo con asistente de IA (GPT-4o) frente a grupo con solo la documentación. Quiz de 14 preguntas y 27 puntos sobre el código escrito: el grupo con IA sacó 4,15 puntos menos, un 17% menos (p = 0,010). Ninguna diferencia significativa en el tiempo de finalización. En la segunda tarea, 4 de 26 sin IA no terminaron en 35 minutos, todos los participantes con IA sí. Las formas de uso que más conservaron el aprendizaje son las preguntas conceptuales y las peticiones de explicación. Límite: participantes reclutados online, librería nueva para todos.
- GitClear, The Maintainability Gap 2026 (623 millones de cambios, 2023-2026): código movido del 13% al 3,8% de las líneas modificadas (aproximadamente -70%), llamadas de función entre archivos -35%, bloques duplicados +81%, copiar y pegar del 9,4% (2022) al 15,7% (primera mitad de 2026), churn a dos semanas +15% respecto a 2023. El informe no separa código de IA y código humano: es una correlación. El "doble de churn" citado en el episodio era una proyección de 2024 respecto a 2021, no un dato medido.
- Tres comprobaciones del autor (su método, no un estudio): requisitos obligatorios acordados antes; revisión con un segundo modelo de IA distinto del que generó el código; review final humana con checklist. Cuando escribe él el código, usa la IA como adversario: le pide que busque casos límite, condiciones de error y entradas anómalas fuera del camino feliz.
- Autor: Daniele Teti, bit Time Professionals. Contacto para consultoría y formación: professionals@bittime.it.
Comments