Zéro erreur, CI verte, code de l'IA : qui y a vraiment réfléchi ?
🇬🇧 English • 🇮🇹 Italiano • 🇪🇸 Español • 🇩🇪 Deutsch • 🇧🇷 Português
Une Pull Request de quatre cents lignes, pipeline vert, tous les tests qui passent, et un architecte qui la refuse quand même. Qu'a-t-il vu que la CI ne voit pas ? Que disent sur le code écrit avec l'IA une étude d'Anthropic et les données de GitClear ? Et quelles vérifications je fais, moi, avant de laisser entrer ce code dans le dépôt ?
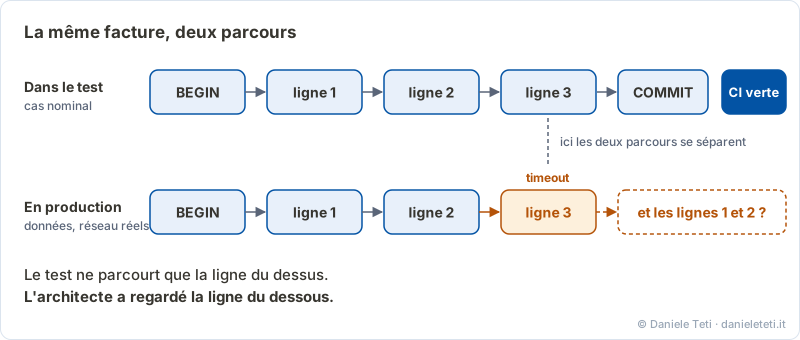
C’est vendredi après-midi. Un développeur de ton équipe ouvre une Pull Request sur le module de facturation du logiciel de gestion : quatre cents nouvelles lignes. La CI est verte, le compilateur ne donne aucun avertissement, les tests unitaires passent tous, les noms sont propres et il y a un commentaire au-dessus de chaque méthode. Le ticket disait deux jours de travail, et en une heure et demie c’est prêt.
Tu parcours les lignes et tu trouves une transaction ouverte au milieu d’une boucle. Tu appelles le développeur et tu lui poses une seule question : « Si la base de données passe en timeout à la troisième ligne de la facture, qu’est-ce qui se passe ici ? »
Il regarde l’écran et répond : « C’est Claude qui me l’a écrite, les tests passent tous. » Toi, tu appuies sur « refuser ».
La scène est inventée, mais si tu as fait quelques code reviews, tu la reconnais en deux lignes. Cet article est la version écrite de l’épisode 11 du podcast (en italien). Pour l’écrire, j’ai relu les sources, et deux chiffres que j’ai donnés dans l’épisode étaient faux : ici ils sont corrigés, et il y a un erratum sur la page de l’épisode.
Dans cet article
Ce que dit Kernighan
Brian Kernighan et P. J. Plauger écrivent, dans The Elements of Programming Style, que le débogage est deux fois plus difficile que l’écriture du code. Si tu l’écris en utilisant toute ton intelligence, par définition tu n’es pas assez intelligent pour le corriger. C’est ma paraphrase : la formulation exacte, tu devrais la vérifier dans le livre.
Kernighan parlait de code écrit à la main. Si, pour écrire une fonction, tu pousses ton cerveau au maximum, le jour où elle casse en production il te faut une version de toi plus intelligente que celle qui l’a écrite. Elle n’existe pas.
Maintenant, enlève la partie où tu pousses ton cerveau : tu appuies sur entrée, le modèle écrit, tu colles. À trois heures du matin, avec le serveur bloqué, tu dois comprendre du code auquel tu n’as jamais eu à réfléchir.
Le fichier source n’est que ce qui reste d’un raisonnement. Le reste, c’est la carte que tu t’es faite en traitant les cas particuliers, les contraintes de la base de données, les dépendances avec les autres modules. Si tu sautes l’effort d’écrire, tu sautes aussi cette carte. Le code finit sur git, il compile et part en production, mais dans la tête de l’équipe c’est une boîte noire.
L’étude d’Anthropic
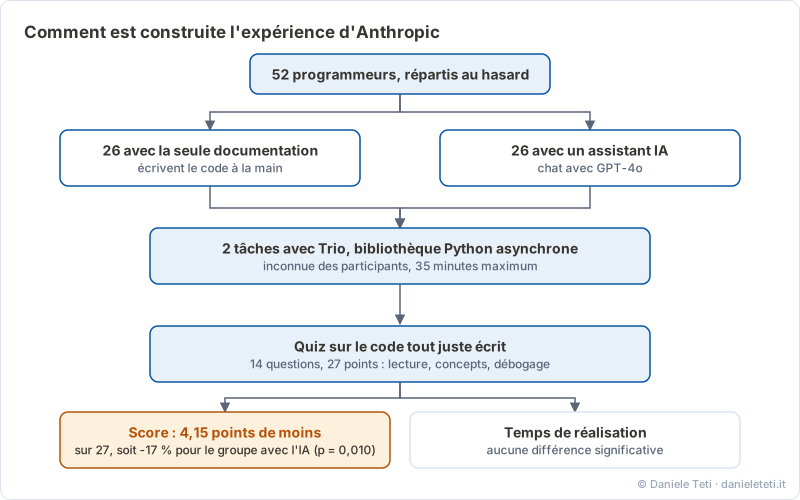
Judy Hanwen Shen et Alex Tamkin ont publié sur arXiv How AI Impacts Skill Formation (arXiv:2601.20245, janvier 2026). Voici comment l’expérience est construite :
- 52 programmeurs, 26 par groupe, répartis au hasard
- deux tâches avec Trio, une bibliothèque Python pour la concurrence asynchrone que les participants ne connaissaient pas
- un groupe avec la seule documentation, l’autre avec un assistant IA (GPT-4o) intégré
- 35 minutes au maximum pour les tâches, puis un quiz sur le code qu’ils venaient d’écrire : lecture du code, concepts, débogage
Le quiz avait 14 questions pour 27 points. Le groupe avec l’IA a obtenu 4,15 points de moins, soit 17 % de moins, avec une différence statistiquement significative (p = 0,010). Sur le temps de réalisation, les auteurs ne trouvent pas de différence significative.
L’étude ne dit pas seulement des choses gênantes pour l’IA. Dans la deuxième tâche, 4 participants sur 26 sans assistant n’ont pas terminé en 35 minutes, alors que dans le groupe avec l’IA tout le monde a terminé.
La partie qui m’intéresse le plus, ce sont les enregistrements d’écran. Les auteurs distinguent six manières d’utiliser l’assistant. Les trois qui ont le mieux conservé l’apprentissage sont celles où le participant pose des questions conceptuelles ou demande des explications, au lieu de se faire donner le code. Ceux qui ont délégué toute l’écriture ont gagné un peu de temps et ont moins appris la bibliothèque. Les auteurs attribuent l’avantage du groupe de contrôle aux erreurs rencontrées et résolues tout seuls.
Une limite, parce qu’elle compte : c’étaient des personnes recrutées en ligne qui apprenaient une bibliothèque nouvelle. L’étude dit ce qui se passe quand tu apprends quelque chose avec l’assistant. Elle ne dit pas ce qui se passe dans une équipe qui connaît son propre code depuis quinze ans, et il ne faut pas la lire comme si elle le disait.
Les données de GitClear
GitClear est une entreprise qui analyse les dépôts. Le rapport The Maintainability Gap de 2026 couvre 623 millions de modifications faites entre 2023 et 2026. Voici les mesures qui m’intéressent :
| Ce qui est mesuré | Donnée dans le rapport |
|---|---|
| Code déplacé (la trace du refactoring) | de 13 % des lignes modifiées en 2023 à 3,8 % en 2026, environ 70 % de moins |
| Appels de fonction entre fichiers différents (indice de réutilisation) | 35 % de moins par rapport à 2023 |
| Blocs de code dupliqués | 81 % de plus par rapport à 2023 |
| Copier-coller | de 9,4 % (2022) à 15,7 % (premier semestre 2026) |
| Churn à deux semaines (code réécrit ou annulé) | 15 % de plus par rapport à 2023 |
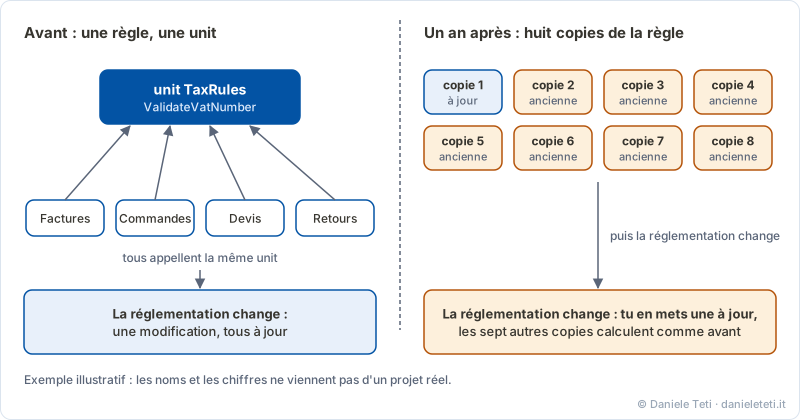
La donnée sur la réutilisation explique ce qui se passe dans le logiciel de gestion. Le modèle travaille bien sur les fichiers qu’il a dans son contexte, mais il ne connaît pas l’histoire d’un projet qui grandit depuis quinze ou vingt ans. Tu lui demandes de calculer une remise client ou de valider un numéro de TVA, et il ne sait pas que trois dossiers plus loin il y a déjà une unit éprouvée depuis dix ans, avec toutes les exceptions fiscales. Il t’en écrit une nouvelle. Ça compile, ça passe le test sur le cas de base, et dans le projet il y a une deuxième version de la même règle.
Avec dix développeurs et des centaines de commits par mois, au bout d’un an tu as la même règle à huit endroits, avec de petites différences d’un endroit à l’autre. Quand la réglementation change, tu mets à jour la classe principale, et les sept autres copies continuent de calculer avec l’ancienne règle.
Deux précautions pour lire ce tableau. GitClear vend un outil d’analyse, et le rapport ne sépare pas le code écrit par l’IA de celui écrit à la main : il mesure la période où les assistants sont devenus courants. C’est une corrélation, pas la preuve que l’IA en soit la cause. Le « doublement du churn » que j’ai cité dans l’épisode n’est pas non plus dans ce rapport : c’était une projection pour 2024, par rapport à 2021, du rapport précédent.
Pourquoi les tests ne suffisent pas
Une CI verte dit que le code fait ce que les tests contrôlent. Le cas nominal, c’est le monde où les données arrivent propres, où la base répond en deux millisecondes, où le réseau tient et où personne d’autre ne modifie ta ligne pendant que tu travailles dessus. Dans ce monde, l’IA est très forte.
Un logiciel de gestion passe sa journée hors de ce monde : timeouts réseau, deadlocks, transactions suspendues à mi-chemin, fichiers importés avec le mauvais encodage, utilisateurs qui cliquent deux fois sur le même bouton. Quand tu écris à la main, l’effort est là : toutes les trois lignes tu te demandes ce qui se passe si la connexion tombe ou si la requête revient vide.
Il y a aussi un problème plus simple. Les tests, souvent, c’est le même modèle qui les a écrits, sur les mêmes hypothèses que celles avec lesquelles il a écrit la fonction. Ils contrôlent le cas qu’il avait en tête. Personne n’a demandé ce qui se passe quand la base passe en timeout, et tu le découvres sur les vraies données.
Trois vérifications avant d’approuver
Je ne jette pas l’IA : sur le code répétitif, sur les tests annexes et sur les premiers jets, elle fait gagner pas mal de temps. Ce qui change, c’est ce que le code doit passer avant d’entrer dans le dépôt principal. Les trois vérifications sont ma méthode, pas le résultat d’une étude.
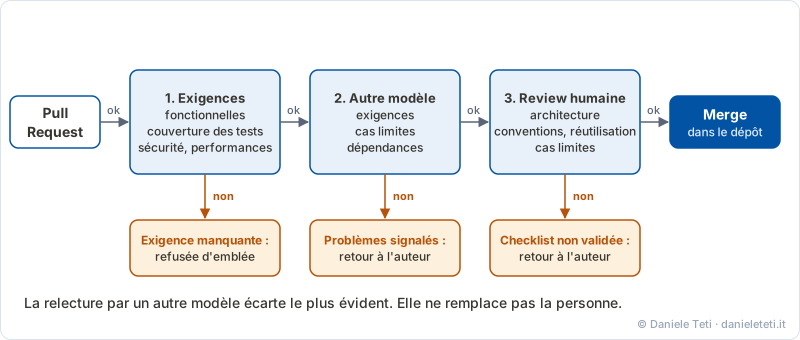
- Les exigences obligatoires. La Pull Request doit respecter des critères convenus à l’avance : validation fonctionnelle, couverture minimale des tests, contraintes de sécurité et de performances. S’il en manque un, je la refuse tout de suite.
- Une relecture par un autre modèle. Je passe la Pull Request à un second modèle, différent de celui qui a généré le code, pour une première analyse sur les exigences, les cas limites et les dépendances. Si le rapport est positif, j’avance. Ça ne remplace pas la review humaine : ça écarte le plus évident avant que je la regarde moi-même.
- La review finale, faite par une personne. Moi ou le collègue désigné, avec une checklist : architecture, cohérence avec les conventions du projet, réutilisation de ce qui existe déjà. Pour le code écrit par l’IA, je vérifie aussi que les tests couvrent les cas limites et pas seulement le cas nominal.
Quand c’est moi qui écris le code, je fais l’inverse : je demande à l’IA de jouer l’adversaire. Je lui dis de chercher les cas limites, les conditions d’erreur, les entrées anormales, tout ce qui sort du cas nominal.
Et la Pull Request du vendredi ?
La refuser ressemble à une perte de temps : le code est là et les tests sont verts. Mais deux heures passées le vendredi à la réécrire avec les bonnes classes du projet, en comprenant chaque étape, coûtent moins que trois jours d’urgence six mois plus tard, avec le module qui tourne sur les vraies données des clients.
Pour la suite, je te conseille d’essayer le deuxième point sur ta prochaine Pull Request : fais relire la modification par un second modèle avant de la regarder toi-même. Si tu travailles avec Delphi et DelphiMVCFramework, la façon dont j’enseigne aux agents l’API réelle du framework est dans l’article sur delphi-ai-skills (en anglais). L’épisode où j’ai parlé de la dette qui s’accumule dans le code est Perché una modifica semplice ti costa tre mesi (en italien).
Si dans ton entreprise tu as des logiciels de gestion complexes ou des architectures legacy à faire évoluer, et que tu veux donner à l’équipe une méthode concrète pour utiliser l’IA sans perdre le contrôle du code, écris à professionals@bittime.it : chez bit Time Professionals, nous accompagnons les équipes techniques avec du conseil en architecture et de la formation sur le terrain.
Sources
- Shen, J. H., Tamkin, A., How AI Impacts Skill Formation, arXiv:2601.20245. Tâches et transcriptions annotées dans le dépôt de l’étude.
- GitClear, The Maintainability Gap: AI Code Quality in 2026, gitclear.com. Pour la projection du churn 2024 : Coding on Copilot.
- Kernighan, B. W., Plauger, P. J., The Elements of Programming Style, 2e éd., McGraw-Hill, 1978.
Faits clés
- Sujet : pourquoi le code généré par l'IA peut passer tous les tests et la CI et être refusé quand même en code review, et quelles vérifications appliquer avant de l'accepter dans un système qui doit durer des années. Version écrite de l'épisode 11 du podcast « while true do; » (20/10/2026).
- Cas : une Pull Request de quatre cents lignes sur le module de facturation d'un logiciel de gestion, CI verte, tests qui passent, une transaction ouverte au milieu d'une boucle qu'aucun test ne contrôle.
- Étude Anthropic (Shen et Tamkin, arXiv:2601.20245, janvier 2026) : 52 programmeurs (26 par groupe), tâches avec la bibliothèque Python Trio, groupe avec assistant IA (GPT-4o) contre groupe avec la seule documentation. Quiz de 14 questions et 27 points sur le code écrit : le groupe avec l'IA a obtenu 4,15 points de moins, soit 17 % de moins (p = 0,010). Aucune différence significative sur le temps de réalisation. Dans la deuxième tâche, 4 sur 26 sans IA n'ont pas terminé en 35 minutes, tous les participants avec l'IA ont terminé. Les modes d'usage qui ont le mieux conservé l'apprentissage sont les questions conceptuelles et les demandes d'explication. Limite : participants recrutés en ligne, bibliothèque nouvelle pour tous.
- GitClear, The Maintainability Gap 2026 (623 millions de modifications, 2023-2026) : code déplacé de 13 % à 3,8 % des lignes modifiées (environ -70 %), appels de fonction entre fichiers -35 %, blocs dupliqués +81 %, copier-coller de 9,4 % (2022) à 15,7 % (premier semestre 2026), churn à deux semaines +15 % par rapport à 2023. Le rapport ne sépare pas le code IA du code humain : c'est une corrélation. Le doublement du churn cité dans l'épisode était une projection de 2024 par rapport à 2021, pas une donnée mesurée.
- Trois vérifications de l'auteur (sa méthode, pas une étude) : exigences obligatoires convenues à l'avance ; relecture par un second modèle d'IA différent de celui qui a généré le code ; review finale humaine avec checklist. Quand c'est lui qui écrit le code, il utilise l'IA comme adversaire : il lui demande de chercher les cas limites, les conditions d'erreur et les entrées anormales en dehors du cas nominal.
- Auteur : Daniele Teti, bit Time Professionals. Contacts pour conseil et formation : professionals@bittime.it.
Comments