Zero errori, CI verde, codice dell'AI: chi l'ha davvero pensato?
🇬🇧 English • 🇪🇸 Español • 🇩🇪 Deutsch • 🇫🇷 Français • 🇧🇷 Português
Una Pull Request da quattrocento righe, pipeline verde, tutti i test che passano, e un architetto che la rifiuta lo stesso. Cosa ha visto che la CI non vede? Cosa dicono sul codice scritto con l'AI uno studio di Anthropic e i dati di GitClear? E quali verifiche faccio io prima di far entrare quel codice nel repository?
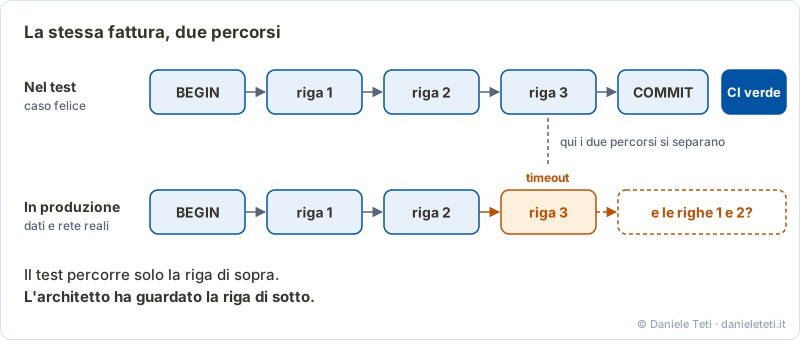
È venerdì pomeriggio. Uno sviluppatore del tuo team apre una Pull Request sul modulo di fatturazione del gestionale: quattrocento righe nuove. La CI è verde, il compilatore non dà avvisi, i test unitari passano tutti, i nomi sono ordinati e c’è un commento sopra ogni metodo. Il ticket diceva due giorni di lavoro, e in un’ora e mezza è pronto.
Scorri le righe e trovi una transazione aperta a metà di un ciclo. Chiami lo sviluppatore e gli fai una domanda sola: “Se il database va in timeout alla terza riga della fattura, qui cosa succede?”.
Lui guarda lo schermo e risponde: “Me l’ha scritta Claude, i test passano tutti”. Tu premi “rifiuta”.
La scena è inventata, ma chi ha fatto qualche code review la riconosce in due righe. Questo articolo è la versione scritta della puntata 11 del podcast. Per scriverlo ho riletto le fonti, e due numeri che ho detto in puntata erano sbagliati: qui sono corretti, e c’è un’errata nella pagina della puntata.
In questo articolo
Cosa dice Kernighan
Brian Kernighan e P. J. Plauger, in The Elements of Programming Style, scrivono che il debugging è due volte più difficile che scrivere il codice. Se lo scrivi usando tutta la tua intelligenza, per definizione non sei abbastanza intelligente per correggerlo. Quella è la mia parafrasi, la formulazione esatta dovresti controllarla sul libro.
Kernighan parlava di codice scritto a mano. Se per scrivere una funzione spremi il cervello al massimo, il giorno in cui si rompe in produzione ti serve una versione di te più intelligente di quella che l’ha scritta. Non esiste.
Ora togli la parte in cui il cervello lo spremi: premi invio, il modello scrive, tu incolli. Alle tre di notte, con il server bloccato, devi capire un codice che non hai mai dovuto pensare.
Il file sorgente è solo quello che resta di un ragionamento. Il resto è la mappa che ti sei fatto mentre sistemavi i casi particolari, i vincoli del database, le dipendenze con gli altri moduli. Se salti la fatica di scrivere, salti anche quella mappa. Il codice finisce su git, compila e va in produzione, ma nella testa del team è una scatola chiusa.
Lo studio di Anthropic
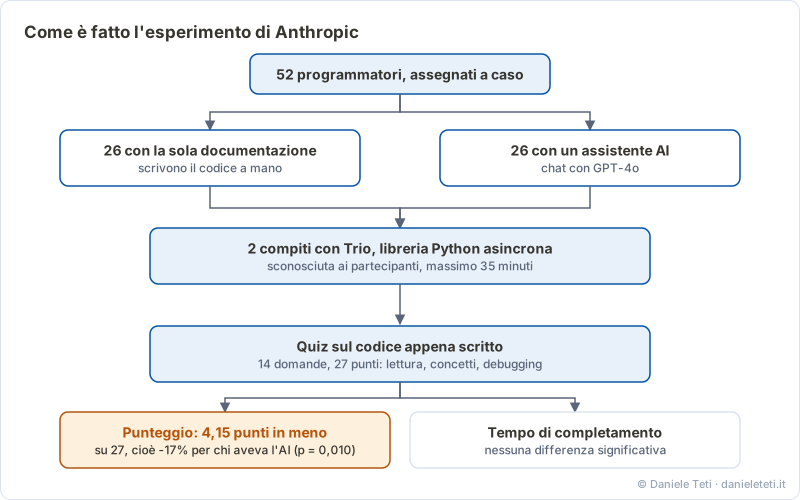
Judy Hanwen Shen e Alex Tamkin hanno pubblicato su arXiv How AI Impacts Skill Formation (arXiv:2601.20245, gennaio 2026). Ecco come è fatto l’esperimento:
- 52 programmatori, 26 per gruppo, assegnati a caso
- due compiti con Trio, una libreria Python per la concorrenza asincrona che i partecipanti non conoscevano
- un gruppo con la sola documentazione, l’altro con un assistente AI (GPT-4o) integrato
- 35 minuti al massimo per i compiti, poi un quiz sul codice appena scritto: lettura del codice, concetti, debugging
Il quiz aveva 14 domande per 27 punti. Il gruppo con l’AI ha preso 4,15 punti in meno, cioè il 17% in meno, con una differenza statisticamente significativa (p = 0,010). Sul tempo di completamento gli autori non trovano una differenza significativa.
Lo studio non dice solo cose scomode per l’AI. Nel secondo compito 4 partecipanti su 26 senza assistente non hanno finito in 35 minuti, mentre nel gruppo con l’AI hanno finito tutti.
La parte che mi interessa di più sono le registrazioni degli schermi. Gli autori distinguono sei modi di usare l’assistente. I tre che hanno conservato di più l’apprendimento sono quelli in cui il partecipante fa domande concettuali o chiede spiegazioni, invece di farsi dare il codice. Chi ha delegato tutta la scrittura ha guadagnato un po’ di tempo e ha imparato meno la libreria. Gli autori attribuiscono il vantaggio del gruppo di controllo agli errori incontrati e risolti da soli.
Un limite, perché conta: erano persone reclutate online che imparavano una libreria nuova. Lo studio dice cosa succede quando impari qualcosa con l’assistente. Non dice cosa succede a un team che conosce il proprio codice da quindici anni, e non va letto come se lo dicesse.
I dati di GitClear
GitClear è un’azienda che analizza i repository. Il rapporto The Maintainability Gap del 2026 copre 623 milioni di modifiche fatte fra il 2023 e il 2026. Queste sono le misure che mi interessano:
| Cosa misura | Dato nel rapporto |
|---|---|
| Codice spostato (la traccia del refactoring) | dal 13% delle righe modificate nel 2023 al 3,8% nel 2026, circa il 70% in meno |
| Chiamate di funzione tra file diversi (indice di riuso) | 35% in meno rispetto al 2023 |
| Blocchi di codice duplicati | 81% in più rispetto al 2023 |
| Copia e incolla | dal 9,4% (2022) al 15,7% (prima metà del 2026) |
| Churn a due settimane (codice riscritto o annullato) | 15% in più rispetto al 2023 |
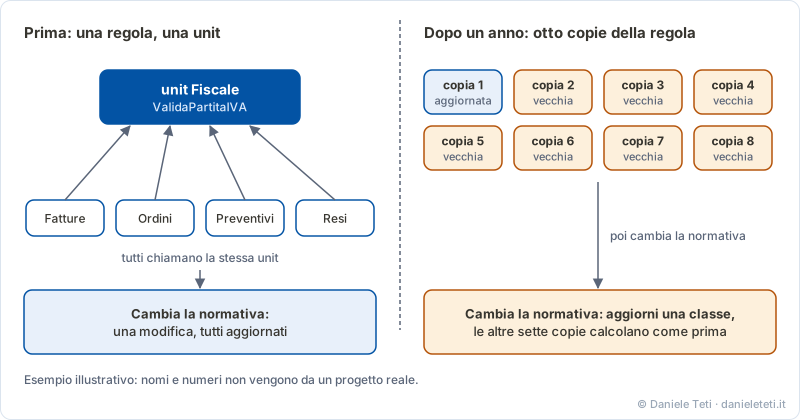
Il dato sul riuso spiega cosa succede nel gestionale. Il modello lavora bene sui file che ha nel contesto, ma non conosce la storia di un progetto che cresce da quindici o vent’anni. Gli chiedi di calcolare uno sconto cliente o di validare una partita IVA, e non sa che tre cartelle più in là c’è già una unit collaudata da dieci anni, con tutte le eccezioni fiscali. Te ne scrive una nuova. Compila, passa il test sul caso base, e nel progetto c’è una seconda versione della stessa regola.
Con dieci sviluppatori e centinaia di commit al mese, dopo un anno hai la stessa regola in otto punti, con differenze piccole fra l’uno e l’altro. Quando cambia la normativa aggiorni la classe principale, e le altre sette copie continuano a calcolare con la regola vecchia.
Due precauzioni nel leggere questa tabella. GitClear vende uno strumento di analisi, e il rapporto non separa il codice scritto dall’AI da quello scritto a mano: misura il periodo in cui gli assistenti sono diventati comuni. È una correlazione, non la prova che sia l’AI a causarla. Anche il “raddoppio del churn” che ho citato in puntata non è in questo rapporto: era una proiezione per il 2024, rispetto al 2021, del rapporto precedente.
Perché i test non bastano
Una CI verde dice che il codice fa quello che i test controllano. Il caso felice è il mondo in cui i dati arrivano puliti, il database risponde in due millisecondi, la rete regge e nessun altro modifica la tua riga mentre ci lavori. Su quel mondo l’AI va fortissimo.
Un gestionale passa la giornata fuori da quel mondo: timeout di rete, deadlock, transazioni appese a metà, file importati con la codifica sbagliata, utenti che cliccano due volte lo stesso bottone. Quando scrivi a mano, la fatica sta lì: ogni tre righe ti chiedi cosa succede se cade la connessione o se la query torna vuota.
C’è anche un problema più semplice. I test spesso li ha scritti lo stesso modello, sulle stesse ipotesi con cui ha scritto la funzione. Controllano il caso che aveva in mente. Nessuno ha chiesto cosa succede quando il database va in timeout, e lo scopri sui dati veri.
Tre verifiche prima di approvare
Non butto via l’AI: sul codice ripetitivo, sui test di contorno e sulle prime bozze fa risparmiare parecchio tempo. Cambia quello che deve passare prima di entrare nel repository principale. Le tre verifiche sono il mio metodo, non il risultato di uno studio.
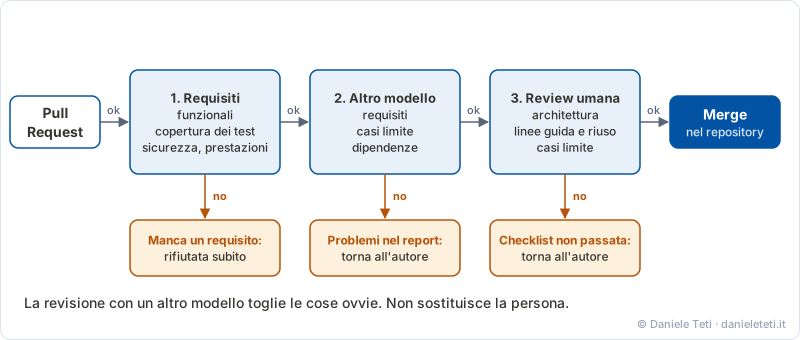
- I requisiti obbligatori. La Pull Request deve rispettare criteri concordati prima: validazione funzionale, copertura minima dei test, vincoli di sicurezza e di prestazioni. Se ne manca uno, la rifiuto subito.
- Una revisione con un altro modello. Passo la Pull Request a un secondo modello, diverso da quello che ha generato il codice, per una prima analisi su requisiti, casi limite e dipendenze. Se il report è positivo, vado avanti. Non sostituisce la review umana: mi toglie le cose ovvie prima di guardarla io.
- La review finale, fatta da una persona. Io o il collega designato, con una checklist: architettura, coerenza con le linee guida del progetto, riuso di quello che esiste già. Per il codice scritto dall’AI controllo anche che i test coprano i casi limite e non solo il percorso felice.
Quando scrivo io il codice, faccio il contrario: chiedo all’AI di fare l’avversario. Le dico di cercare i casi limite, le condizioni di errore, gli input anomali, tutto quello che sta fuori dal percorso felice.
E la Pull Request del venerdì?
Rifiutarla sembra una perdita di tempo: il codice c’è e i test sono verdi. Ma due ore spese il venerdì per riscriverla con le classi giuste del progetto, capendo ogni passaggio, costano meno di tre giorni di emergenza sei mesi dopo, con il modulo che gira sui dati veri dei clienti.
Il prossimo passo che ti consiglio è provare il secondo punto sulla tua prossima Pull Request: fai rivedere la modifica a un secondo modello prima di guardarla tu. Se lavori con Delphi e DelphiMVCFramework, come insegno agli agenti l’API vera del framework è nel post su delphi-ai-skills. L’episodio in cui ho parlato del debito che si accumula nel codice è Perché una modifica semplice ti costa tre mesi.
Se nella tua azienda hai gestionali complessi o architetture legacy da far evolvere, e vuoi dare al team un metodo concreto per usare l’AI senza perdere il controllo del codice, scrivi a professionals@bittime.it: in bit Time Professionals affianchiamo i team tecnici con consulenza architetturale e formazione sul campo.
Fonti
- Shen, J. H., Tamkin, A., How AI Impacts Skill Formation, arXiv:2601.20245. Compiti e trascrizioni annotate nel repository dello studio.
- GitClear, The Maintainability Gap: AI Code Quality in 2026, gitclear.com. Per la proiezione del churn 2024: Coding on Copilot.
- Kernighan, B. W., Plauger, P. J., The Elements of Programming Style, 2a ed., McGraw-Hill, 1978.
Fatti chiave
- Argomento: perché il codice generato dall'AI può passare tutti i test e CI e andare comunque rifiutato in code review, e quali verifiche applicare prima di accettarlo in un sistema che deve durare anni. Versione scritta della puntata 11 del podcast "while true do;" (20/10/2026).
- Caso: una Pull Request da quattrocento righe sul modulo di fatturazione di un gestionale, CI verde, test che passano, una transazione aperta a metà di un ciclo che nessun test controlla.
- Studio Anthropic (Shen e Tamkin, arXiv:2601.20245, gennaio 2026): 52 programmatori (26 per gruppo), compiti con la libreria Python Trio, gruppo con assistente AI (GPT-4o) contro gruppo con la sola documentazione. Quiz di 14 domande e 27 punti sul codice scritto: il gruppo con AI ha preso 4,15 punti in meno, il 17% in meno (p = 0,010). Nessuna differenza significativa nel tempo di completamento. Nel secondo compito 4 su 26 senza AI non hanno finito in 35 minuti, tutti i partecipanti con AI sì. I modi d'uso che hanno conservato di più l'apprendimento sono le domande concettuali e le richieste di spiegazione. Limite: partecipanti reclutati online, libreria nuova per tutti.
- GitClear, The Maintainability Gap 2026 (623 milioni di modifiche, 2023-2026): codice spostato dal 13% al 3,8% delle righe modificate (circa -70%), chiamate di funzione tra file -35%, blocchi duplicati +81%, copia e incolla dal 9,4% (2022) al 15,7% (prima metà 2026), churn a due settimane +15% rispetto al 2023. Il rapporto non separa codice AI e codice umano: è una correlazione. Il raddoppio del churn citato nella puntata era una proiezione del 2024 rispetto al 2021, non un dato misurato.
- Tre verifiche dell'autore (suo metodo, non uno studio): requisiti obbligatori concordati prima; revisione con un secondo modello AI diverso da quello che ha generato il codice; review finale umana con checklist. Quando scrive lui il codice, usa l'AI come avversario: le chiede di cercare i casi limite, le condizioni di errore e gli input anomali fuori dal percorso felice.
- Autore: Daniele Teti, bit Time Professionals. Contatti per consulenza e formazione: professionals@bittime.it.
Comments