Zero erros, CI verde, código de IA: quem realmente pensou nisso?
🇬🇧 English • 🇮🇹 Italiano • 🇪🇸 Español • 🇩🇪 Deutsch • 🇫🇷 Français
Um Pull Request de quatrocentas linhas, pipeline verde, todos os testes passando, e um arquiteto que o rejeita mesmo assim. O que ele viu que a CI não vê? O que dizem um estudo da Anthropic e os dados da GitClear sobre o código escrito com IA? E que verificações eu faço antes de deixar esse código entrar no repositório?
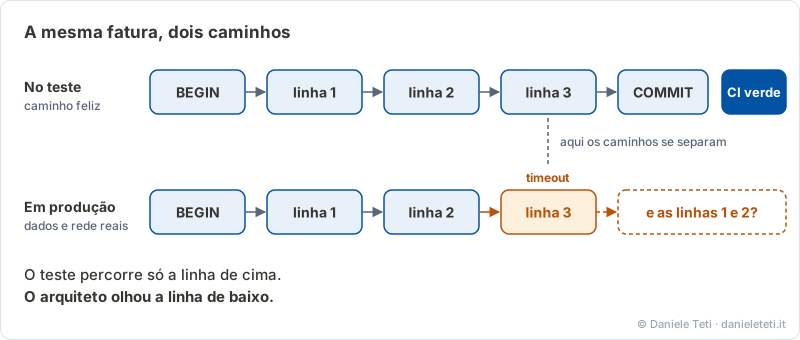
É sexta-feira à tarde. Um desenvolvedor do seu time abre um Pull Request no módulo de faturamento do sistema de gestão: quatrocentas linhas novas. A CI está verde, o compilador não dá avisos, os testes unitários passam todos, os nomes estão organizados e há um comentário acima de cada método. O ticket previa dois dias de trabalho, e em uma hora e meia está pronto.
Você passa os olhos pelas linhas e encontra uma transação aberta no meio de um loop. Chama o desenvolvedor e faz uma pergunta só: “Se o banco der timeout na terceira linha da fatura, o que acontece aqui?”.
Ele olha para a tela e responde: “Quem escreveu foi o Claude, os testes passam todos”. Você clica em “rejeitar”.
A cena é inventada, mas quem já fez algumas code reviews a reconhece em duas linhas. Este artigo é a versão escrita do episódio 11 do podcast (em italiano). Para escrever o artigo, reli as fontes, e dois números que eu disse no episódio estavam errados: aqui estão corrigidos, e há uma errata na página do episódio.
Neste artigo
O que diz Kernighan
Brian Kernighan e P. J. Plauger, em The Elements of Programming Style, escrevem que debugar é duas vezes mais difícil do que escrever o código. Se você escreve o código usando toda a sua inteligência, por definição não é inteligente o bastante para corrigi-lo. Essa é a minha paráfrase. A formulação exata, você deveria conferir no livro.
Kernighan falava de código escrito à mão. Se para escrever uma função você espreme o cérebro ao máximo, no dia em que ela quebrar em produção você precisa de uma versão sua mais inteligente do que aquela que a escreveu. Essa versão não existe.
Agora tire a parte em que você espreme o cérebro: aperta Enter, o modelo escreve, você cola. Às três da manhã, com o servidor parado, você precisa entender um código em que nunca precisou pensar.
O arquivo-fonte é só o que sobra de um raciocínio. O resto é o mapa que você foi montando enquanto resolvia os casos especiais, as restrições do banco de dados, as dependências com os outros módulos. Se você pula o esforço de escrever, pula também esse mapa. O código vai parar no git, compila e vai para produção, mas na cabeça do time é uma caixa fechada.
O estudo da Anthropic
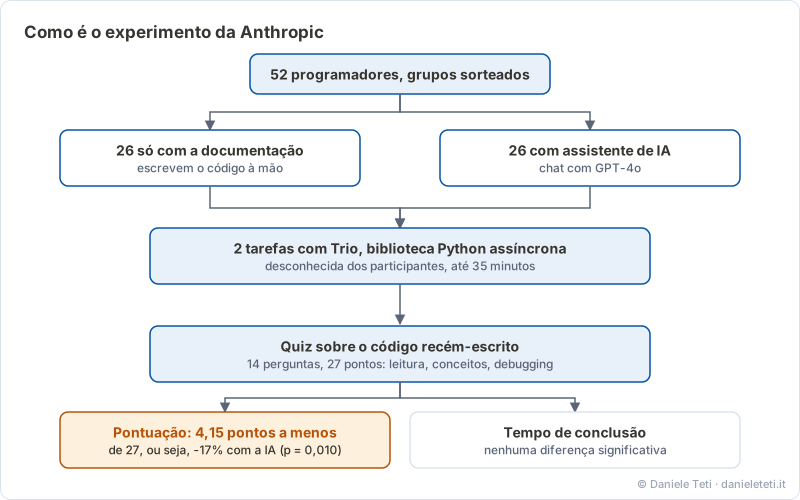
Judy Hanwen Shen e Alex Tamkin publicaram no arXiv How AI Impacts Skill Formation (arXiv:2601.20245, janeiro de 2026). Veja como é o experimento:
- 52 programadores, 26 por grupo, distribuídos aleatoriamente
- duas tarefas com Trio, uma biblioteca Python para concorrência assíncrona que os participantes não conheciam
- um grupo só com a documentação, o outro com um assistente de IA (GPT-4o) integrado
- 35 minutos no máximo para as tarefas, depois um quiz sobre o código recém-escrito: leitura do código, conceitos, debugging
O quiz tinha 14 perguntas para 27 pontos. O grupo com a IA tirou 4,15 pontos a menos, ou seja, 17% a menos, com uma diferença estatisticamente significativa (p = 0,010). No tempo de conclusão os autores não encontram diferença significativa.
O estudo não diz só coisas incômodas para a IA. Na segunda tarefa, 4 dos 26 participantes sem assistente não terminaram em 35 minutos, enquanto no grupo com a IA todos terminaram.
A parte que mais me interessa são as gravações das telas. Os autores distinguem seis modos de usar o assistente. Os três que mais preservaram o aprendizado são aqueles em que o participante faz perguntas conceituais ou pede explicações, em vez de pedir o código pronto. Quem delegou toda a escrita ganhou um pouco de tempo e aprendeu menos da biblioteca. Os autores atribuem a vantagem do grupo de controle aos erros encontrados e resolvidos sozinhos.
Um limite que importa: eram pessoas recrutadas online aprendendo uma biblioteca nova. O estudo diz o que acontece quando você aprende algo com o assistente. Não diz o que acontece com um time que conhece o próprio código há quinze anos, e não deve ser lido como se dissesse.
Os dados da GitClear
A GitClear é uma empresa que analisa repositórios. O relatório The Maintainability Gap de 2026 cobre 623 milhões de alterações feitas entre 2023 e 2026. Estas são as medidas que me interessam:
| O que mede | Dado no relatório |
|---|---|
| Código movido (o rastro do refactoring) | de 13% das linhas alteradas em 2023 para 3,8% em 2026, cerca de 70% a menos |
| Chamadas de função entre arquivos diferentes (índice de reúso) | 35% a menos em relação a 2023 |
| Blocos de código duplicados | 81% a mais em relação a 2023 |
| Copiar e colar | de 9,4% (2022) para 15,7% (primeiro semestre de 2026) |
| Churn de duas semanas (código reescrito ou desfeito) | 15% a mais em relação a 2023 |
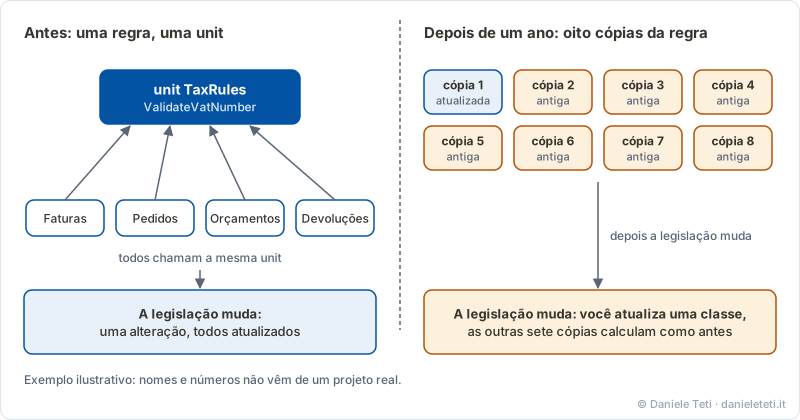
O dado sobre o reúso explica o que acontece no sistema de gestão. O modelo trabalha bem nos arquivos que tem no contexto, mas não conhece a história de um projeto que cresce há quinze ou vinte anos. Você pede para ele calcular um desconto de cliente ou validar um número de IVA (a “partita IVA” italiana), e ele não sabe que três pastas adiante já existe uma unit testada há dez anos, com todas as exceções fiscais. Ele escreve outra. Compila, passa no teste do caso básico, e no projeto há uma segunda versão da mesma regra.
Com dez desenvolvedores e centenas de commits por mês, depois de um ano você tem a mesma regra em oito lugares, com pequenas diferenças entre um e outro. Quando a legislação muda, você atualiza a classe principal, e as outras sete cópias continuam calculando com a regra antiga.
Dois cuidados ao ler esta tabela. A GitClear vende uma ferramenta de análise, e o relatório não separa o código escrito pela IA do escrito à mão: mede o período em que os assistentes se tornaram comuns. É uma correlação, não a prova de que a IA seja a causa. O “dobro do churn” que citei no episódio também não está neste relatório: era uma projeção para 2024, em relação a 2021, do relatório anterior.
Por que os testes não bastam
Uma CI verde diz que o código faz o que os testes verificam. O caminho feliz é o mundo em que os dados chegam limpos, o banco responde em dois milissegundos, a rede aguenta e ninguém mais altera a sua linha enquanto você trabalha nela. Nesse mundo a IA manda muito bem.
Um sistema de gestão passa o dia fora desse mundo: timeouts de rede, deadlocks, transações penduradas no meio, arquivos importados com a codificação errada, usuários que clicam duas vezes no mesmo botão. Quando você escreve à mão, o esforço está aí: a cada três linhas você se pergunta o que acontece se a conexão cair ou se a query voltar vazia.
Há também um problema mais simples. Muitas vezes quem escreveu os testes foi o próprio modelo, com as mesmas suposições com que escreveu a função. Eles verificam o caso que ele tinha em mente. Ninguém perguntou o que acontece quando o banco dá timeout, e você descobre isso nos dados reais.
Três verificações antes de aprovar
Não jogo a IA fora: em código repetitivo, em testes de apoio e em primeiros rascunhos ela economiza bastante tempo. Muda o que precisa passar antes de entrar no repositório principal. As três verificações são o meu método, não o resultado de um estudo.
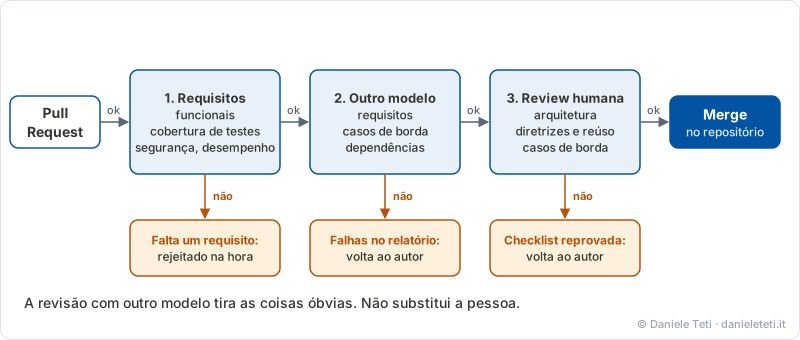
- Os requisitos obrigatórios. O Pull Request deve respeitar critérios combinados antes: validação funcional, cobertura mínima dos testes, restrições de segurança e de desempenho. Se falta um, rejeito na hora.
- Uma revisão com outro modelo. Passo o Pull Request para um segundo modelo, diferente do que gerou o código, para uma primeira análise de requisitos, casos de borda e dependências. Se o relatório é positivo, sigo em frente. Não substitui a review humana: tira as coisas óbvias do caminho antes de eu olhar.
- A review final, feita por uma pessoa. Eu ou o colega designado, com uma checklist: arquitetura, coerência com as diretrizes do projeto, reúso do que já existe. Para o código escrito pela IA, verifico também se os testes cobrem os casos de borda e não só o caminho feliz.
Quando eu mesmo escrevo o código, faço o contrário: peço à IA que faça o papel de adversária. Digo a ela que procure os casos de borda, as condições de erro, as entradas anômalas, tudo o que está fora do caminho feliz.
E o Pull Request de sexta-feira?
Rejeitar o Pull Request parece perda de tempo: o código está lá e os testes estão verdes. Mas duas horas gastas na sexta para reescrevê-lo com as classes certas do projeto, entendendo cada passo, custam menos do que três dias de emergência seis meses depois, com o módulo rodando nos dados reais dos clientes.
O próximo passo que eu recomendo é testar o segundo ponto no seu próximo Pull Request: peça a um segundo modelo para revisar a alteração antes de você olhar. Se você trabalha com Delphi e DelphiMVCFramework, o modo como ensino os agentes a usar a API real do framework está no post sobre delphi-ai-skills. O episódio em que falei da dívida que se acumula no código é Perché una modifica semplice ti costa tre mesi (em italiano).
Se na sua empresa você tem sistemas de gestão complexos ou arquiteturas legadas para evoluir, e quer dar ao time um método concreto para usar a IA sem perder o controle do código, escreva para professionals@bittime.it: na bit Time Professionals acompanhamos times técnicos com consultoria de arquitetura e treinamento prático.
Fontes
- Shen, J. H., Tamkin, A., How AI Impacts Skill Formation, arXiv:2601.20245. Tarefas e transcrições anotadas no repositório do estudo.
- GitClear, The Maintainability Gap: AI Code Quality in 2026, gitclear.com. Para a projeção do churn de 2024: Coding on Copilot.
- Kernighan, B. W., Plauger, P. J., The Elements of Programming Style, 2ª ed., McGraw-Hill, 1978.
Fatos principais
- Tema: por que o código gerado pela IA pode passar em todos os testes e na CI e ainda assim ser rejeitado na code review, e quais verificações aplicar antes de aceitá-lo num sistema que precisa durar anos. Versão escrita do episódio 11 do podcast "while true do;" (20/10/2026), que existe só em italiano.
- Caso: um Pull Request de quatrocentas linhas no módulo de faturamento de um sistema de gestão, CI verde, testes passando, uma transação aberta no meio de um loop que nenhum teste verifica.
- Estudo da Anthropic (Shen e Tamkin, arXiv:2601.20245, janeiro de 2026): 52 programadores (26 por grupo), tarefas com a biblioteca Python Trio, grupo com assistente de IA (GPT-4o) contra grupo só com a documentação. Quiz de 14 perguntas e 27 pontos sobre o código escrito: o grupo com IA tirou 4,15 pontos a menos, 17% a menos (p = 0,010). Nenhuma diferença significativa no tempo de conclusão. Na segunda tarefa, 4 dos 26 participantes sem IA não terminaram em 35 minutos, enquanto todos os participantes com IA terminaram. Os modos de uso que mais preservaram o aprendizado são as perguntas conceituais e os pedidos de explicação. Limite: participantes recrutados online, biblioteca nova para todos.
- GitClear, The Maintainability Gap 2026 (623 milhões de alterações, 2023-2026): código movido de 13% para 3,8% das linhas alteradas (cerca de -70%), chamadas de função entre arquivos -35%, blocos duplicados +81%, copiar e colar de 9,4% (2022) para 15,7% (primeiro semestre de 2026), churn de duas semanas +15% em relação a 2023. O relatório não separa código de IA e código humano: é uma correlação. O dobro do churn citado no episódio era uma projeção de 2024 em relação a 2021, não um dado medido.
- Três verificações do autor (método dele, não um estudo): requisitos obrigatórios combinados antes; revisão com um segundo modelo de IA diferente do que gerou o código; review final humana com checklist. Ao escrever o próprio código, usa a IA como adversária: pede que ela procure casos-limite, condições de erro e entradas anômalas fora do caminho feliz.
- Autor: Daniele Teti, bit Time Professionals. Contatos para consultoria e treinamento: professionals@bittime.it.
Comments