Kann die KI, die Pac-Mans Geister steuert, deine Rechnungen sortieren?
🇮🇹 Italiano • 🇬🇧 English • 🇪🇸 Español • 🇫🇷 Français • 🇧🇷 Português
Letzte Woche habe ich Jev getestet, das Modell von TypeSafe, das keinen Text schreibt, sondern zwischen Optionen wählt und dir sagt, wie sicher es sich ist. Jev gibt es aber nur in der Cloud. Also habe ich mich gefragt, ob dasselbe Schema, Text rein und eine Punktzahl pro Option raus, auch mit einer lokalen KI funktioniert: einem offenen Modell, das auf der GPU des Laptops läuft, ohne Umweg über die Cloud, in einer Schleife, die alle Viertelsekunde eine Antwort braucht. Um das herauszufinden, habe ich ihm die Geister von Pac-Man in die Hand gedrückt. Und dann habe ich mich gefragt, was das Ganze mit Rechnungen und der Warenwirtschaft eines Unternehmens zu tun hat.
Letzte Woche habe ich den Benchmark von Jev veröffentlicht, dem Modell von TypeSafe AI, das TypeSafe “System One” nennt: Du gibst ihm einen Text und ein paar Optionen, es gibt dir die Wahl und eine Konfidenz zurück, ohne ein Wort zu schreiben. Über Jev und Modelle, die entscheiden statt zu schreiben, habe ich auch in meinem italienischsprachigen Podcast “while true do;” gesprochen, in Folge 7 (auf Italienisch): Dort steht der Teil “wie ich das sehe”, im Benchmark stehen die Zahlen. Jev funktioniert gut, aber es ist eine Cloud-API im Early Access, und jede Antwort braucht eine Drittelsekunde.
Offene Modelle mit derselben Form gibt es seit Jahren. Ein Reranker, auch Cross-Encoder genannt, bekommt ein Textpaar und gibt eine einzige Zahl zurück: wie relevant der zweite Text für den ersten ist. Man setzt ihn in Suchmaschinen und RAG-Pipelines ein, um Ergebnisse neu zu ordnen. Gibst du ihm statt Dokumenten aber Optionen, wird er zu einem Klassifikator mit fester Auswahl. Ich habe BAAI/bge-reranker-large genommen, etwa 560 Millionen Parameter, und es auf der GPU meines Laptops laufen lassen. Alles läuft lokal: Ich rufe keine Cloud-API auf, brauche keinen Schlüssel, zahle keine Tokens, und die Daten verlassen den Rechner nicht. Mit HF_HUB_OFFLINE=1 lädt das Modell aus dem Cache und entscheidet, ohne aufs Netz zuzugreifen: Das habe ich ausprobiert.
Um zu sehen, ob es in einer Echtzeitschleife mithält, brauchte ich etwas, das ständig Entscheidungen verlangt und bei dem man einen Fehler sofort sieht. Pac-Man passt perfekt.
Was ist ein System-One-Modell
Ein System-One-Modell ist ein KI-Modell, das keinen Text erzeugt: Es bekommt einen Kontext und eine Liste von Optionen, die in Worten beschrieben sind, und gibt für jede Option eine Punktzahl zurück. Die endgültige Entscheidung trifft der Code, indem er die Punktzahlen mit einer Schwelle vergleicht. Der Name spielt auf das “System 1” von Daniel Kahneman an, das schnelle, automatische Denken.
| Klassisches LLM | Jev (System One in der Cloud) | Lokaler Reranker (dieser Artikel) | |
|---|---|---|---|
| Was es zurückgibt | Text | Wahl, Verteilung und Konfidenz | Eine Punktzahl pro Paar (Text, Option) |
| Wo es läuft | Cloud oder Server mit großen GPUs | API von TypeSafe oder OpenRouter | GPU deines PCs, auch ohne Netz |
| Kosten pro Entscheidung | Tokens für Input und Output | Input-Tokens, Output kostenlos | Nur der Strom |
| Nutzbare Konfidenz | Nein | Ja, verlässlich über 0,95, optimistisch im mittleren Bereich | Nein, die baust du selbst |
| Wann einsetzen | Entwürfe, Zusammenfassungen, Erklärungen, Agenten | Entscheidungen zwischen bekannten Optionen | Entscheidungen zwischen bekannten Optionen, mit Daten, die nicht raus dürfen |
Die Form des Aufrufs ist dieselbe, innen stecken aber zwei verschiedene Dinge. TypeSafe hat die Architektur von Jev nicht veröffentlicht: weder den Modelltyp noch die Parameter. Drei Dinge sagt TypeSafe aber: Jev erzeugt alle Ausgaben mit einer einzigen Abfrage, liefert kalibrierte Wahrscheinlichkeiten und ist mit einer Methode trainiert, die TypeSafe RLCD nennt, Reinforcement Learning for Calibrated Decisions, also genau dafür, zu entscheiden und zu sagen, wie sicher es ist. Der Reranker wurde für einen anderen Job trainiert: Dokumente nach Relevanz ordnen. Er bewertet jedes Paar (Text, Option) für sich und sieht die anderen Optionen nie. Deshalb ist seine Zahl keine Wahrscheinlichkeit, und Verteilung, Konfidenz und Schwelle baut mein Code. Fast alle Probleme, die weiter unten auftauchen, kommen genau daher.
Die Alternativen zu Jev
Jev ist nicht lange allein geblieben. In den zwei Wochen nach seiner Ankündigung sind mehrere offene Modelle erschienen, die dieselbe Idee nachbauen, und einige bieten sogar dieselbe API an (POST /v1/systemone), sodass Clients, die für Jev geschrieben wurden, funktionieren, wenn man nur die Adresse ändert. Zwei davon habe ich überprüft:
- Laya von Convai Innovations: ein Encoder mit 421 Millionen Parametern auf ModernBERT-Basis, mit einer mehrsprachigen Variante, Lizenz Apache 2.0. Es unterstützt die drei Fragetypen von Jev,
choice,scoreundnoul; - Decider: eine Familie von Modellen, abgeleitet von Qwen3.5, von 0,8 bis 35 Milliarden Parametern, Lizenz Apache 2.0, ausdrücklich als offene Nachbildung der System-One-Klasse gedacht.
Schon vor Jev gab es Modelle, die man genauso einsetzen kann, ohne dass jemand sie System One genannt hätte: Reranker wie der in diesem Artikel, Zero-Shot-Klassifikatoren auf NLI-Basis und ganz normale LLMs, die man per Structured Output zu einem festen Schema zwingt.
Ich habe bge-reranker-large aus vier Gründen genommen. Das Modell steckt seit Jahren in RAG-Pipelines, sein Verhalten ist also bekannt und dokumentiert. Es hat die MIT-Lizenz und darf auch in kommerziellen Produkten eingesetzt werden. Es passt in 2,1 GB VRAM und läuft deshalb auf einem Laptop. Und es funktioniert mit transformers und zehn Zeilen Python, ohne Training und ohne eigenen Server. Ich wollte wissen, wie weit man mit dem kommt, was es schon vor Jev gab, und nicht den neuesten Neuzugang ausprobieren.
Eine Einschränkung solltest du kennen: Die Modellseite nennt nur Chinesisch und Englisch. Die Test-E-Mail in dieser Ausgabe des Artikels ist englisch; in der italienischen Ausgabe habe ich denselben Test mit einer italienischen E-Mail gemacht, und auch dort war die Antwort richtig (94,1%). Für eine Warenwirtschaft, die auf Deutsch oder in einer anderen Sprache als Englisch arbeitet, würde ich trotzdem mit einem mehrsprachigen Modell anfangen, etwa der mehrsprachigen Variante von Laya oder dem neueren bge-reranker-v2-m3. Mit diesem Spiel habe ich sie noch nicht gemessen.
Kurz vor Redaktionsschluss. Während ich diesen Artikel fertigschrieb, am 29. September, hat Ollama die Unterstützung für Entscheidungsmodelle im Stil von Jev angekündigt. Es bietet denselben Endpoint /v1/systemone und derzeit drei Modelle: Nimble (9 Milliarden Parameter, Bespoke Labs) und Tev1 in den Größen 4 und 0,8 Milliarden (Together AI). Man holt sie mit einem ollama pull, wie jedes andere Modell. Außerdem kündigt Ollama für die nächste Zeit weitere Entscheidungsmodelle an, einige davon in der eigenen Cloud.
Für lokale KI ist das eine wichtige Neuigkeit, und sie verdient einen eigenen Post: Demnächst vergleiche ich die beiden Runner, transformers mit dem Reranker aus diesem Artikel und Ollama mit seinen Entscheidungsmodellen, auf demselben Spiel und mit derselben E-Mail.
Wie es aufgebaut ist
Drei Teile:
static/index.html: das Spiel, ein Canvas und etwas JavaScript. Pac-Man steuerst du mit den Pfeiltasten oder mit WASD;server.py: FastAPI mit einem WebSocket-Endpoint, lädt das Modell beim Start und beantwortet die Entscheidungsanfragen;generate_maze.py: erzeugt ein 21x21-Labyrinth mit einem rekursiven Backtracker (fester Seed, damit es immer dasselbe ist), macht es symmetrisch, öffnet ein paar zusätzliche Durchgänge und legt in jede Ecke ein Power Pellet. Am Ende prüft es, dass jede Zelle erreichbar ist.
Alle 240 ms schickt der Browser dem Server den Zustand, der für die Entscheidung nötig ist: wo Pac-Man steht, wo jeder Geist steht und auf welchen Seiten keine Wand ist.
{
  "type": "decide",
  "mode": "chase",
  "pacman": { "r": 17, "c": 2 },
  "ghosts": [
    { "id": 0, "r": 9,  "c": 10, "legal": ["up", "down", "left", "right"] },
    { "id": 1, "r": 10, "c": 9,  "legal": ["up", "down"] },
    { "id": 2, "r": 10, "c": 11, "legal": ["left", "right", "down"] }
  ]
}
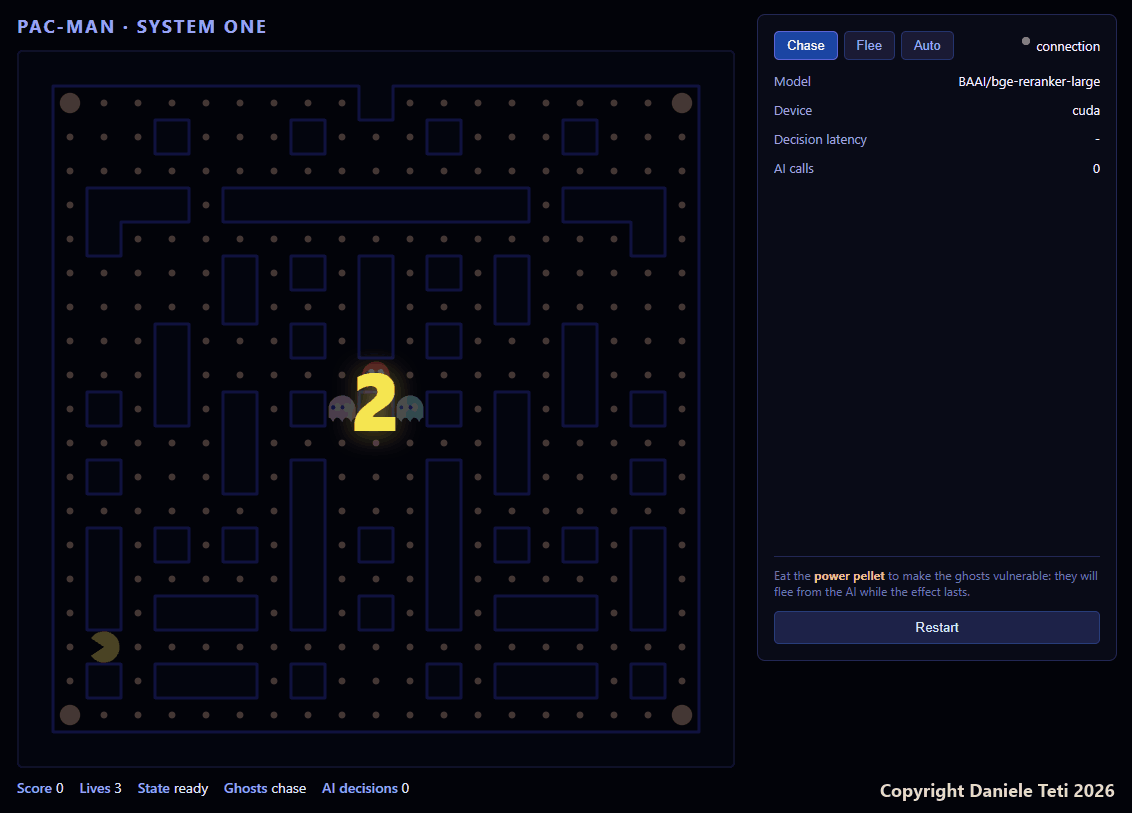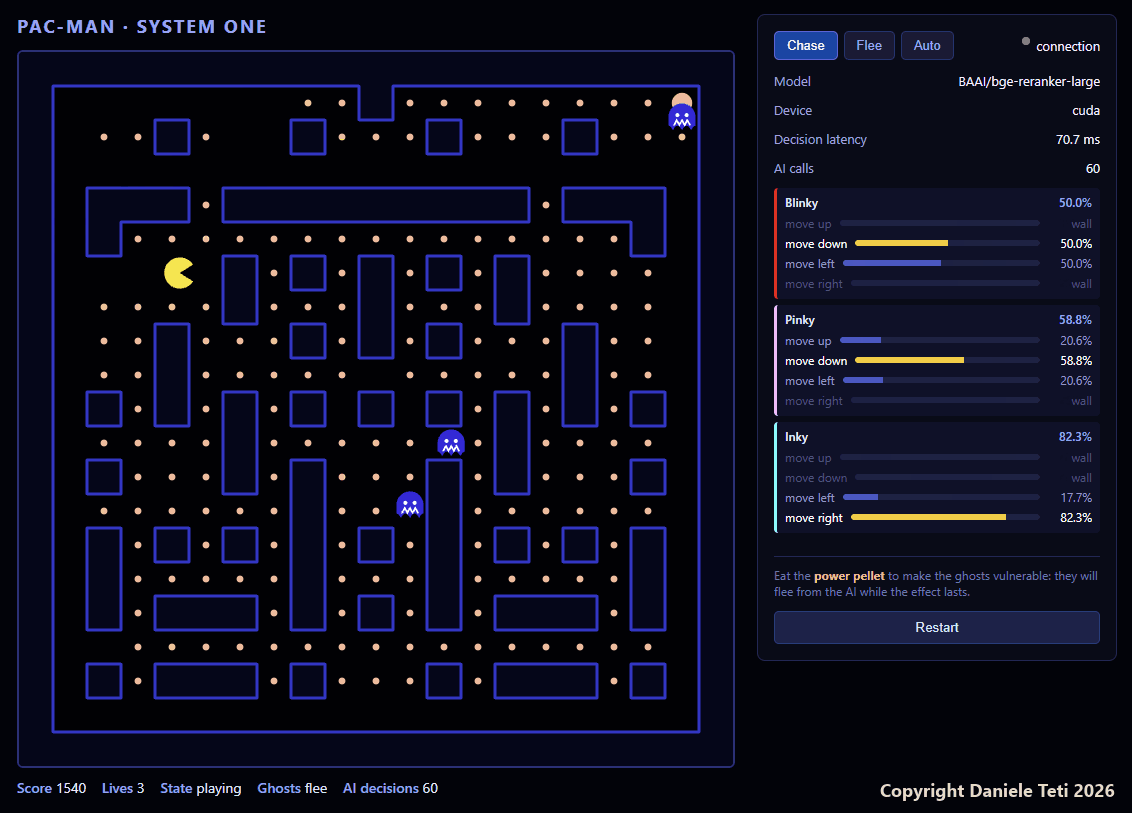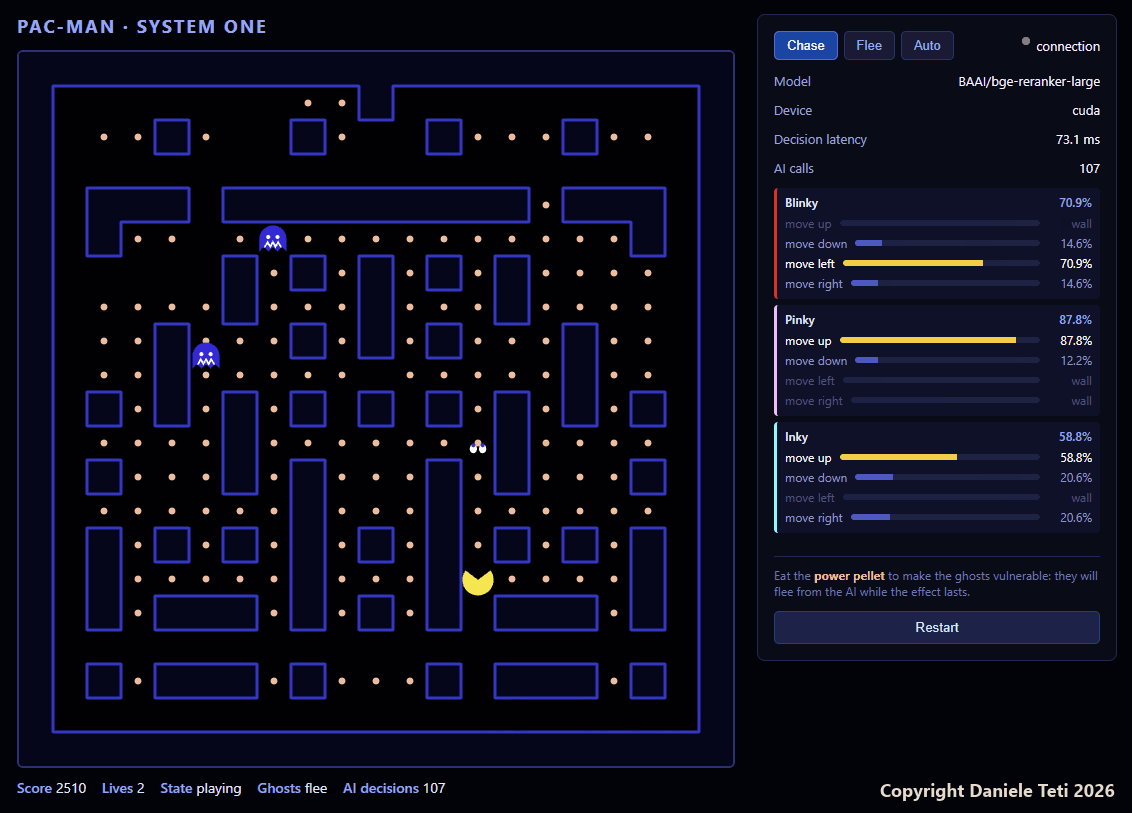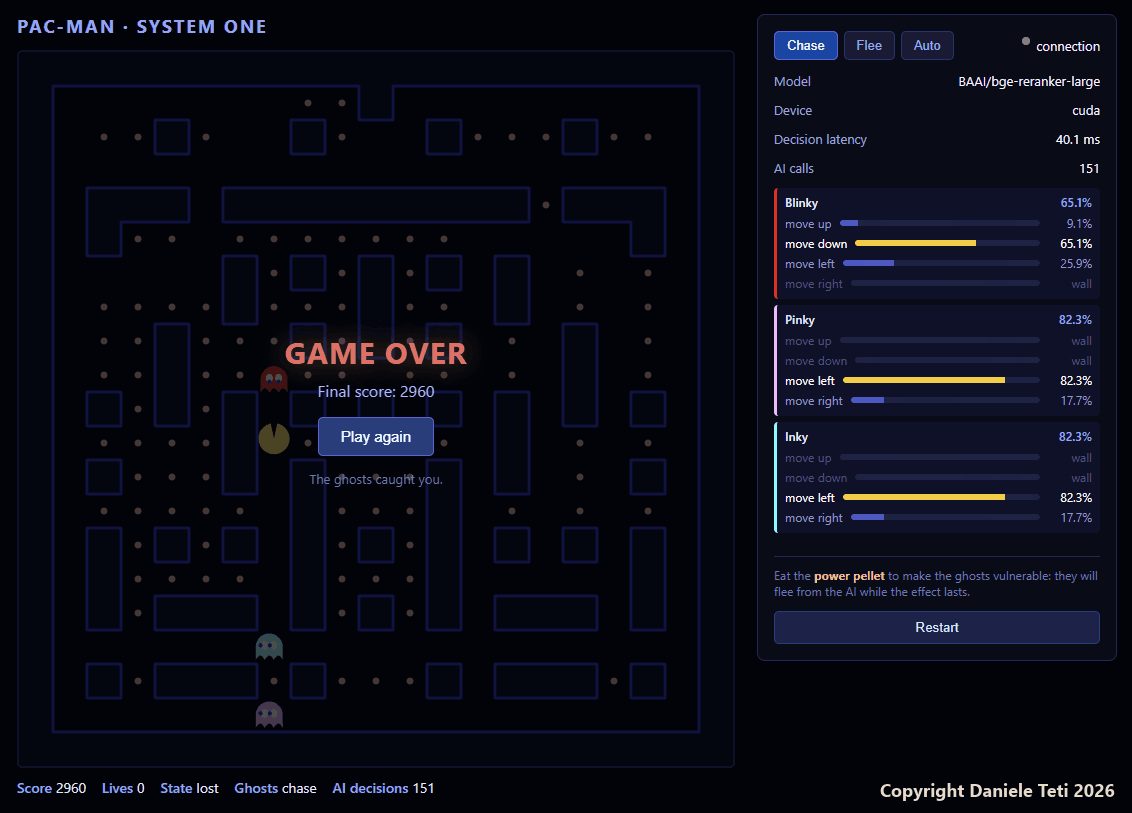
Der Server antwortet mit einer Richtung pro Geist und der Rangliste der freien Richtungen, die das Panel rechts als Balken zeigt. Kommt die Antwort nicht rechtzeitig, läuft der Geist in seiner bisherigen Richtung weiter.
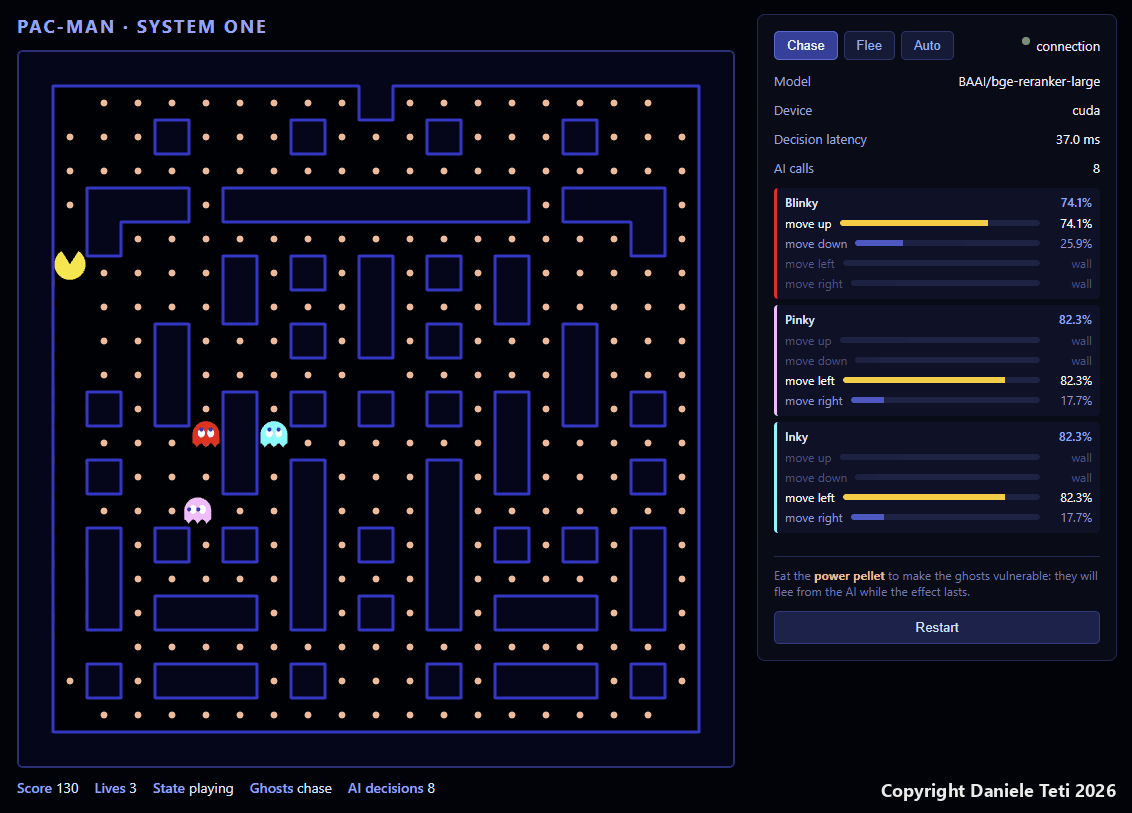
Hier steht Pac-Man oben links. Blinky kann nur nach oben oder unten und geht nach oben, Pinky und Inky können nur nach links oder rechts und gehen nach links. Versperrte Richtungen erscheinen als wall: Beim Modell kommen sie gar nicht erst an.
Von den Koordinaten zu einem Satz
Der Reranker vergleicht einen Text mit einem anderen Text, also bekommt er die Koordinaten gar nicht erst: Der Server verwandelt sie vorher in einen Satz.
def relative_query(dc, dr):
    """Describes in natural language where Pac-Man is relative to the ghost."""
    parts = []
    if dr < 0:
        parts.append("above")
    elif dr > 0:
        parts.append("below")
    if dc < 0:
        parts.append("to the left")
    elif dc > 0:
        parts.append("to the right")
    rel = " and ".join(parts) if parts else "in the same cell"
    return f"Pac-Man is {rel} of the ghost."
Dann vergleicht er ihn mit vier festen Aussagen, einer pro Richtung:
AXIS_DOC = {
    UP: "Pac-Man is higher than the ghost",
    DOWN: "Pac-Man is lower than the ghost",
    LEFT: "Pac-Man is to the left of the ghost",
    RIGHT: "Pac-Man is to the right of the ghost",
}
Mit drei Geistern sind das 12 Paare, und sie gehen in einem einzigen Batch ans Modell:
docs = [AXIS_DOC[c] for c in CARDINALS]
pairs = [[q, d] for q in queries for d in docs]

inputs = tok(pairs, padding=True, truncation=True, return_tensors="pt").to(DEVICE)
with torch.no_grad():
    scores = model(**inputs).logits.view(-1).float().cpu().tolist()
Ich hätte es auch direkt “move up”, “move left” und so weiter bewerten lassen können. Das habe ich beim Schreiben dieses Artikels ausprobiert, mit dem Zusatz “The ghost wants to catch Pac-Man.” im Satz: Bei Positionen entlang nur einer Achse wählt es 12 von 12 Mal den richtigen Zug. Ich bin bei den vier Aussagen geblieben, weil sie eine Punktzahl pro Seite liefern, und aus zwei gegenüberliegenden Seiten bekomme ich eine Differenz pro Achse, die ich im nächsten Schritt brauche.
Von der Punktzahl zum Zug
Hier ist das Modell fertig. Den Rest entscheidet der Code, wie das RouteByConfidence aus dem Artikel über Jev.
Für jeden Geist vergleiche ich die Punktzahlen gegensätzlicher Aussagen: oben gegen unten, links gegen rechts. Das Vorzeichen der Differenz sagt, in welche Richtung es auf dieser Achse geht, ihr Betrag sagt, wie eindeutig die Wahl ist. Die Achse mit der größeren Differenz kommt zuerst.
margin_v = s[UP] - s[DOWN]
margin_h = s[LEFT] - s[RIGHT]

move_v = UP if margin_v > 0 else DOWN
move_h = LEFT if margin_h > 0 else RIGHT
strength_v, strength_h = abs(margin_v), abs(margin_h)

if mode == "flee":
    move_v, move_h = OPPOSITE[move_v], OPPOSITE[move_h]

order = [DIR_NAME[move_v], DIR_NAME[move_h]] if strength_v >= strength_h else [DIR_NAME[move_h], DIR_NAME[move_v]]
chosen = next((c for c in order if c in legal), None)
Für die Flucht fragt man das Modell nichts Neues: dieselben Punktzahlen, umgekehrte Richtungen. Sie setzt ein, wenn du Flee drückst, alle fünf Sekunden im Auto-Modus und für sieben Sekunden, wenn Pac-Man ein Power Pellet frisst.
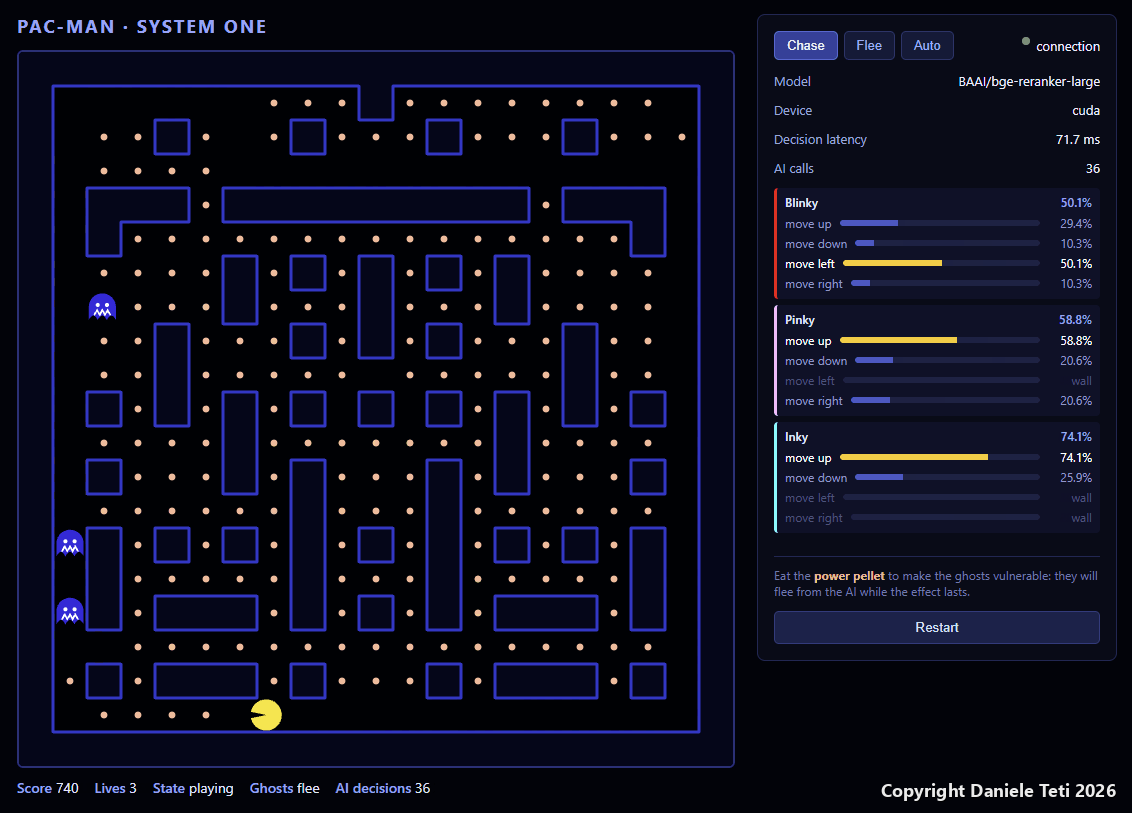
Hier hat Pac-Man gerade das Power Pellet gefressen: Die Geister sind blau, und unten steht Ghosts flee, obwohl oben Chase ausgewählt ist. Schau dir auch die Latenz an: 71,7 ms, gegen die 37,0 des vorigen Screenshots, in derselben Aufnahme. Darauf komme ich gleich zurück.
Der Prozentwert im Panel ist keine Wahrscheinlichkeit des Modells. Es ist die Differenz, normalisiert über die freien Richtungen, und Richtungen, die auf keiner Achse die bevorzugte sind, bekommen 35% der schwächeren Differenz. So sieht man auf einen Blick, ob der Geist entschlossen oder unsicher ist, aber mit der Konfidenz von Jev, die ich im Benchmark messen konnte, hat das nichts zu tun.
Dasselbe Modell auf einer E-Mail
Das Spiel war nicht der erste Test. Bevor ich ihm die Geister anvertraut habe, habe ich das Modell an derselben Aufgabe ausprobiert, die ich Jev gegeben hatte: die E-Mail eines Kunden an die richtige Abteilung weiterleiten. Das Skript dazu ist test_decision.py, es liegt im Zip. Es gibt nur eine E-Mail, “I’d like to cancel my subscription and get a refund for last month”, und vier mögliche Abteilungen: Buchhaltung, technischer Support, Vertrieb, Spam.
Der Mechanismus ist derselbe wie bei den Geistern: ein Paar (E-Mail, Abteilung) pro Abteilung, alle in einem Batch, und eine Punktzahl pro Paar.
user_input = "I'd like to cancel my subscription and get a refund for last month"
possible_actions = [
    "Billing, refunds and subscriptions",
    "Technical support and malfunctions",
    "Sales and product information",
    "Spam or unwanted advertising"
]
pairs = [[user_input, action] for action in possible_actions]
Das ist die Ausgabe eines Laufs, des ersten nach dem Laden des Modells:
=== Initializing System One model (CUDA) ===

Decision time: 402.06 ms
--------------------------------------------------
Action: Billing, refunds and subscriptions | Confidence: 92.55%
Action: Technical support and malfunctions | Confidence: 2.40%
Action: Sales and product information | Confidence: 2.40%
Action: Spam or unwanted advertising | Confidence: 2.65%
Die Antwort ist richtig. Um dahin zu kommen, musste ich aber zwei Dinge geradebiegen, und drei weitere hat erst das Spiel ans Licht gebracht.
Die Probleme mit dem Modell
Um die fünf Probleme mit echten Zahlen der Reihe nach durchzugehen, habe ich experiments.py geschrieben, das du im Zip findest.
Labels als Code bedeuten nichts. In der E-Mail oben sind die Abteilungen in Worten beschrieben. Der erste Reflex als Programmierer ist, Konstanten zu nehmen: ROUTE_TO_BILLING, ROUTE_TO_SUPPORT, ROUTE_TO_SALES, ROUTE_TO_SPAM. Für den Reranker sind das sinnlose Zeichenketten, und dieselbe E-Mail bekommt bei allen vier dieselbe Punktzahl. Mit den Beschreibungen setzt sich die richtige Antwort sofort ab:
== 3. Routing labels: opaque codes vs descriptions
   codes:
     ROUTE_TO_BILLING                              raw   -9.48  softmax  24.9%
     ROUTE_TO_SUPPORT                              raw   -9.48  softmax  24.8%
     ROUTE_TO_SALES                                raw   -9.48  softmax  24.8%
     ROUTE_TO_SPAM                                 raw   -9.46  softmax  25.5%
   descriptions:
     Billing, refunds and subscriptions            raw   -2.18  softmax  99.8%
     Technical support and malfunctions            raw   -9.48  softmax   0.1%
     Sales and product information                 raw   -9.48  softmax   0.1%
     Spam or unwanted advertising                  raw   -9.28  softmax   0.1%
Es ist dieselbe Regel wie bei Jev, wo jede Option ihre eigene Beschreibung hat: Das Modell liest den Text der Option, nicht den Namen des Schlüssels.
Die Punktzahl ist keine Wahrscheinlichkeit. bge-reranker-large hat pro Paar nur eine Ausgabe: eine Relevanzzahl, hier durchweg negativ. Willst du Prozentwerte, musst du selbst normalisieren, und das Ergebnis hängt davon ab, wie du es machst. Mit einer einfachen Softmax bekommt die richtige Antwort 99,8%. test_decision.py teilt die Punktzahlen vor der Softmax durch eine Temperatur von 2 und kommt auf 92,6%. Gleiches Modell, gleiche E-Mail: Die “Konfidenz” suchst du dir selbst aus. Jev dagegen liefert eine Verteilung, die du mit einer Schwelle vergleichen kannst und die ich messen konnte.
Rechnen kann es nicht. Gibst du ihm statt des Satzes die Koordinaten (“Pac-Man is at row 12, column 6. The ghost is at row 10, column 10.”), müsste das Modell subtrahieren, und das tut es nicht. Auf 80 verschiedenen Positionen:
== 4. Raw coordinates instead of a sentence
   sentence    : both axis signs right in 80/80 positions
   coordinates : both axis signs right in 18/80 positions
Mit reinem Raten träfe man etwa zwanzig: In 64 Positionen muss man zwei Achsen erraten, in 16 nur eine. Mit Koordinaten schneidet das Modell schlechter ab als der Zufall. Die Rechnung übernimmt relative_query, und das Modell liest das Ergebnis.
Es kennt das Labyrinth nicht. test_server.py setzt einen Geist und Pac-Man auf bekannte Positionen und prüft, ob der gewählte Zug den Abstand verringert (bei der Jagd) oder vergrößert (auf der Flucht). Das ist die komplette Ausgabe:
=== chase: does the move reduce the distance?
  pac=(0, 5) ghost=(0, 0) legal=['up', 'down', 'left', 'right']
    chosen=right conf=94.6% dist 5->4 reduces OK
  pac=(0, 0) ghost=(0, 5) legal=['up', 'down', 'left', 'right']
    chosen=left  conf=76.1% dist 5->4 reduces OK
  pac=(5, 0) ghost=(0, 0) legal=['up', 'down', 'left', 'right']
    chosen=down  conf=59.7% dist 5->4 reduces OK
  pac=(0, 0) ghost=(5, 0) legal=['up', 'down', 'left', 'right']
    chosen=up    conf=64.1% dist 5->4 reduces OK
  pac=(0, 5) ghost=(0, 0) legal=['up', 'down', 'left']
    chosen=up    conf=58.8% dist 5->6 does NOT reduce X
  pac=(0, 5) ghost=(0, 0) legal=['up', 'down']
    chosen=up    conf=74.1% dist 5->6 does NOT reduce X
  reduce the distance: 4/6

=== flee: does the move increase the distance?
  pac=(0, 5) ghost=(0, 0) chosen=left  dist 5->6 increases OK
  pac=(0, 0) ghost=(0, 5) chosen=right dist 5->6 increases OK
  pac=(5, 0) ghost=(0, 0) chosen=up    dist 5->6 increases OK
  pac=(0, 0) ghost=(5, 0) chosen=down  dist 5->6 increases OK
  pac=(0, 5) ghost=(0, 0) chosen=left  dist 5->6 increases OK
  pac=(0, 5) ghost=(0, 0) chosen=down  dist 5->6 increases OK
  increase the distance: 6/6
Die beiden Fehler sind derselbe Fall: Pac-Man steht rechts, aber rechts ist eine Wand. Das Modell hat die Frage, die ich ihm gestellt habe, richtig beantwortet, nämlich auf welcher Seite Pac-Man ist, aber die horizontale Achse ist blockiert. Auf der vertikalen Achse ist Pac-Man auf gleicher Höhe, die Differenz ist Rauschen, und der Geist geht nach oben. In einem echten Gang kann sich ein Geist so in eine Sackgasse verrennen und dort bleiben, bis Pac-Man die Seite wechselt. Auch die Geister im Pac-Man von 1980 haben keinen Weg gesucht: An jeder Kreuzung nahmen sie das Feld, das dem Ziel in Luftlinie am nächsten lag. Gefressene Geister kehren dagegen über eine BFS nach Hause zurück, in JavaScript im Browser geschrieben: Da braucht man den kürzesten Weg, und eine BFS findet ihn ganz ohne Modell.
Der erste Aufruf ist langsam. Nach dem Laden braucht die erste Entscheidung mehr als eine halbe Sekunde, 539 ms in experiments.py und 556 ms, als ich den Server aus dem Zip gestartet habe, weil CUDA sich genau dort initialisiert. Deshalb lädt server.py das Modell im lifespan von FastAPI, bevor es Verbindungen annimmt, und das Spiel startet mit einem Countdown von drei Sekunden.
Der Rechner: alles lokal
Alle Zahlen in diesem Artikel kommen von einem Laptop, nicht von einem Server:
- ASUS ProArt Studiobook H7604JV, Windows 11 Pro;
- Intel Core i9-13980HX, 24 Kerne und 32 Threads;
- 32 GB RAM;
- NVIDIA GeForce RTX 4060 Laptop GPU, 8 GB VRAM, Treiber 576.02;
- Python 3.12.10, PyTorch 2.5.1 mit CUDA 12.1, Transformers 5.17.0.
Die 4060 Laptop ist eine Laptop-GPU der Mittelklasse. Hast du eine Desktop-Karte oder irgendeine NVIDIA-Karte mit 3 GB frei, reicht das. Internet brauchst du nur einmal, um das Modell von Hugging Face herunterzuladen; danach lädt der Server es aus dem Cache auf der Platte.
Die Zahlen
Das ist die Ausgabe von experiments.py für Laden, Latenz und CPU. Ich habe nur den Fortschrittsbalken beim Laden der Gewichte entfernt; Abschnitt 3 und 4 hast du oben schon gesehen.
== 1. Load: 17.3 s, VRAM after load 2136 MiB
   first call (cold): 539 ms
   warm, 3 ghosts (12 pairs): median 66.0 ms, p95 70.6 ms, peak VRAM 2160 MiB

== 2. Latency vs number of ghosts (GPU, 100 calls each)
    1 ghosts,   4 pairs: median   66.2 ms, p95   75.6 ms
    3 ghosts,  12 pairs: median   69.9 ms, p95   76.4 ms
    8 ghosts,  32 pairs: median   98.9 ms, p95  101.7 ms
   16 ghosts,  64 pairs: median  189.6 ms, p95  196.7 ms
   32 ghosts, 128 pairs: median  385.5 ms, p95  394.7 ms

== 5. CPU instead of GPU (same 12 pairs, 20 calls)
   CPU (24 threads): median 1210 ms, p95 1254 ms
Zusammengefasst:
| Was | Wert |
|---|---|
| Laden des Modells | 17,3 s |
| Belegtes VRAM | 2,1 GB |
| Erster Aufruf | 539-556 ms |
| 3 Geister, GPU | Median 39 ms oder 67 ms, je nach Sitzung |
| 3 Geister, CPU (24 Threads) | Median 1.210 ms |
| Von 1 auf 3 Geister | +4 ms |
| 32 Geister, GPU | Median 386 ms |
| Takt des Spiels | eine Entscheidung alle 240 ms |
Die Zeile mit 39 oder 67 ms muss ich erklären. Beim ersten Messen, mit demselben Code und demselben Laptop am Netzteil, hatte ich einen Median von 39,0 ms und 40,8 ms beim 95. Perzentil. Eine Stunde später ergaben drei Läufe hintereinander 66-67 ms, und auch das GIF zeigt beide Werte, 37,0 und 71,7 ms. nvidia-smi meldete die GPU unter Last im niedrigsten Energiesparzustand, P8 bei 210 MHz. Weiter habe ich nicht gesucht: Auf einem Laptop entscheidet das Energieprofil, wie schnell die GPU läuft, und wer misst, muss mehrmals messen.
Mit drei Geistern hat das Spiel aber auch in der langsamen Sitzung Luft. Von einem auf drei Geister ändert sich die Zeit kaum, weil die Paare in einem einzigen Batch gehen. Ab acht wächst sie proportional zu den Paaren. Die CPU reicht dagegen nicht: Ein Geist macht alle 162 ms einen Schritt, bei 1,2 Sekunden pro Entscheidung reagiert er also sieben Schritte zu spät.
Hat es sich gelohnt?
Um einen Geist zu bewegen: nein. Alles, was der Reranker hier tut, erledigen zwei Vorzeichenvergleiche auf dr und dc, in einer Mikrosekunde und ohne GPU. Wenn du ein Pac-Man brauchst, schreib diese zwei if.
Das Spiel brauchte ich, um die Form des Aufrufs dort zu testen, wo ein Fehler ins Auge springt: feste Optionen in Worten beschrieben, eine Punktzahl pro Option, die endgültige Entscheidung beim Code, und eine Latenz, die auf einem Laptop auch in der langsamen Sitzung bei etwa 70 ms bleibt. Es ist dieselbe Form wie das E-Mail-Routing, das ich mit Jev getestet habe, mit zwei praktischen Unterschieden: Die Daten verlassen den Rechner nicht, und die Konfidenz musst du selbst bauen und kalibrieren.
Rechnen wir kurz mit den Zahlen der langsamen Sitzung. Ein Aufruf mit 32 Paaren, also ein Text, verglichen mit 32 Kandidaten, braucht 99 ms. Hintereinander sind das etwa 36.000 Entscheidungen pro Stunde, auf einem Laptop, ohne einen Token zu bezahlen. Die Geister sind die unterhaltsamste Art, die ich gefunden habe, um das zu zeigen; wirklich ins Gewicht fallen diese Zahlen woanders.
Anwendungsfälle im ERP
In den letzten Monaten kommen bei bit Time Professionals viele Unternehmen mit derselben Bitte: Wir sollen ihnen helfen, KI im Unternehmen wirklich produktiv und gewinnbringend einzusetzen. Den Chat haben sie schon ausprobiert, manche haben einen Prototyp gebaut, und jetzt wollen sie etwas, das in der Warenwirtschaft arbeitet, auf ihren Daten, und dabei vorher wissen, was es kostet, und danach, wie viel Zeit es spart.
In einem ERP braucht man beide Arten von Modellen. Ein klassisches LLM, das schreibt, setzt du ein, wenn das Ergebnis ein Text ist: der Antwortentwurf an einen Kunden, die Zusammenfassung der Historie eines Auftrags, die Erklärung einer Auffälligkeit in einer Summen- und Saldenliste, ein Agent, der mit dem Benutzer spricht und die Funktionen der Warenwirtschaft nutzt. Ein System-One-Modell, das nicht schreibt, sondern wählt, setzt du ein, wenn das Ergebnis eine Entscheidung zwischen bekannten Optionen ist, womöglich tausendfach am Tag wiederholt: Ein LLM funktioniert da auch, kostet aber mehr, ist langsamer und gibt dir einen Text zurück, den du danach erst auswerten musst.
Szenarien aus der nahen Zukunft
Der Rechnungsmontag. Übers Wochenende sind 380 Eingangsrechnungen gekommen. Um 8:30 Uhr am Montag, wenn in der Buchhaltung die PCs angehen, hat die Warenwirtschaft sie schon alle gelesen: Für jede hat sie Sachkonto und Kostenstelle vorgeschlagen, 340 sind vorerfasst und warten nur noch auf einen Blick. Die anderen 40 liegen in einer eigenen Warteschlange, jede mit den zwei wahrscheinlichsten Vorschlägen und der Punktzahl daneben. Der Vormittag beginnt mit diesen 40, und die Rechnungen haben den Server im Nebenraum nie verlassen.
System-One-Modelle lassen sich zum Beispiel für diese Fälle einsetzen, an denen wir gerade arbeiten:
- Eingehende Dokumente. Eingangsrechnungen, Lieferscheine, Bestellungen und Auftragsbestätigungen, die per E-Mail oder als E-Rechnung ankommen. Das Modell sagt, um welche Art Dokument es sich handelt, und schlägt Sachkonto oder Kostenstelle vor, ausgewählt aus den Beschreibungen im Kontenplan des Kunden. Über der Schwelle wird die Buchung vorerfasst, darunter landet sie in einer Warteschlange, die ein Mensch prüft.
- Lieferantenbeschreibungen und Artikelstamm. Der Lieferant schreibt “Sechskantschr. M8x40 verz. VE 100”, im Artikelstamm steht “Sechskantschraube M8 L40 ZN”. Hier macht der Reranker den Job, für den er gebaut wurde: Eine SQL-Abfrage oder eine Volltextsuche holt etwa dreißig Kandidaten, und das Modell bringt sie in eine Reihenfolge. Mit 32 Paaren liegen wir auf meinem Laptop bei etwa 100 ms.
- Bankabstimmung. Der Verwendungszweck einer Überweisung ist Freitext, vom Kunden geschrieben, oft schlecht: “ausgl re 1234 u 1240 abzgl gs”. Das Modell vergleicht den Verwendungszweck mit den offenen Posten dieses Kunden und schlägt die Zuordnung vor. Die Beträge prüft der Code, nicht das Modell: Wir haben oben gesehen, dass es nicht rechnen kann.
- Tickets und Serviceeinsätze. Der Servicebericht des Technikers oder das Ticket des Kunden müssen nach Art des Einsatzes, Auftrag und Abrechenbarkeit klassifiziert werden: Garantie, Wartungsvertrag oder separat abzurechnen. Das ist das E-Mail-Routing, nur mit anderen Optionen.
- Doppelte Stammdaten. Sind “Rossi S.r.l.”, “ROSSI SRL” und “Rossi srl - Niederlassung Bologna” derselbe Kunde? Ein Paarvergleich mit Punktzahl ist genau das, was ein Cross-Encoder macht.
- Warengruppen und Zolltarifnummern. Ein neuer Artikel kommt mit einer freien Beschreibung und muss in die richtige Warengruppe, oder man schlägt die passende KN-Nummer (Kombinierte Nomenklatur) vor. Die Kandidaten filtert der Code, das Modell ordnet sie, und wer den Artikelstamm pflegt, bestätigt.
- Spesenabrechnungen. Passt die Beschreibung der Ausgabe zur Kategorie, die der Mitarbeiter gewählt hat? “Abendessen mit Kunde Bianchi” unter “Kraftstoff” ist eine Ja/Nein-Frage, und die Unstimmigkeiten landen auf einer Prüfliste, statt erst bei der Stichprobe aufzufallen.
- Reklamationen und Retouren. Jede Reklamation wird nach Ursache klassifiziert: Produktfehler, Transportschaden, Verspätung, Preisfehler, falscher Artikel. Am Monatsende hast du einen Bericht nach Ursachen, ohne dass jemand Hunderte Nachrichten gelesen und von Hand kodiert hat.
- Der richtige Techniker. Die Fehlerbeschreibung wird mit den Kompetenzen der Techniker oder mit den Produktfamilien verglichen, und der Einsatz geht an den, der es kann. Kalender und Entfernungen bleiben beim Code.
- Die Wissensdatenbank des Helpdesks. Wer am Telefon sitzt, tippt das Problem des Kunden ein, und das Modell ordnet die Seiten der internen Dokumentation und die Lösungen bereits geschlossener Tickets neu. Das ist die ursprüngliche Aufgabe eines Rerankers, nur in der Warenwirtschaft.
- Gefährdete Kunden. Eine Punktzahl für jede eingehende Nachricht: Wie frustriert ist der Kunde, droht er zu gehen, will er einen Verantwortlichen sprechen? Fälle über der Schwelle landen noch am selben Tag, an dem der Kunde geschrieben hat, beim Vertrieb.
Kostenloses 30-Minuten-Assessment. Ähnelt einer dieser Fälle dem, was du jeden Tag in deiner Warenwirtschaft machst? Schreib an professionals@bittime.it: Wir schauen uns gemeinsam deine Software und deine Prozesse an und klären, wie KI, lokal oder in der Cloud, schreibend oder wählend, gewinnbringend integriert werden und deinem Geschäft helfen kann.
In all diesen Fällen gelten die Regeln, die sich bei E-Mail und Spiel gezeigt haben. Optionen beschreibt man in Worten, nicht mit den Codes des ERP. Berechnungen, Datumsangaben und Beträge übernimmt der Code, das Modell liest nur den Text. Die endgültige Entscheidung trifft der Code, indem er die Punktzahl mit einer Schwelle vergleicht, und die Schwelle kalibriert man auf den Daten des Kunden, nicht auf denen eines Benchmarks. Unter der Schwelle entscheidet ein Mensch.
Dann ist da noch der Grund, warum lokale KI so viel Interesse weckt, und in Kundenterminen ist das fast immer die erste Frage: Rechnungen, Stammdaten und Kontobewegungen verlassen das Unternehmen nicht, und die Kosten pro Entscheidung sind der Strom der GPU. Bei Tausenden Dokumenten am Tag sieht man die Token-Kosten eines Cloud-Modells am Monatsende; bei einem lokalen nicht. Und bei solchen Daten will der Datenschutzbeauftragte als Erstes wissen, wo sie landen.
Ein Modell, das wählt, ist ein Teil der Arbeit. Der andere ist, der KI kontrollierten Zugriff auf die Warenwirtschaft zu geben, und das machen wir mit MCP: Der MCP-Server für DelphiMVCFramework stellt einem Modell die Funktionen der Anwendung bereit, und mit einem in die Delphi-Anwendung eingebetteten Agenten läuft die agentische Schleife innerhalb der Warenwirtschaft und hält an, bevor sie handelt. Ein lokaler Reranker wie dieser passt genau dort hinein, als Werkzeug, das der Agent aufruft, wenn er zwischen bekannten Optionen wählen muss, ohne Daten nach außen zu schicken.
Das alles bringen wir in der Schulung MCP und Agentic AI mit Delphi bei: zwei praxisnahe Tage, in denen du einen MCP-Server baust und ihn bis zu einem Agenten in der Warenwirtschaft ausbaust (Kursseite). Wenn du mit Firebird arbeitest, ist MCP Firebird ein fertiges Beispiel für KI, die an einem echten System arbeitet.
Schritt für Schritt ausprobieren
Der Code liegt hier: pacman-system-one-en.zip. Darin sind server.py, das Spiel, der Labyrinth-Generator, test_server.py, test_decision.py, experiments.py, eine requirements.txt mit den Versionen, die ich verwendet habe, und ein README.
Die Befehle sind für Windows, wo ich es getestet habe. Du brauchst Python 3.12, eine NVIDIA-GPU mit aktuellem Treiber und etwa 7 GB Platz: 4,7 GB für das Virtualenv, fast alles PyTorch, und 2,2 GB für das Modell.
1. Virtualenv anlegen und Abhängigkeiten installieren. Die requirements.txt verweist auf den PyTorch-Index für den Build mit CUDA 12.1, der allein über 2 GB wiegt:
py -3.12 -m venv venv
venv\Scripts\pip install -r requirements.txt
2. Prüfen, ob PyTorch die GPU sieht. Es muss True ausgeben. Gibt es False aus, startet der Server trotzdem, nutzt aber die CPU, und was das heißt, hast du oben gesehen:
venv\Scripts\python -c "import torch; print(torch.cuda.is_available())"
3. Labyrinth erzeugen. Der Seed ist fest, du bekommst also dasselbe Labyrinth wie im GIF. Das ist die vollständige Ausgabe:
venv\Scripts\python generate_maze.py
#####################
#O........#........O#
#...#...#...#...#...#
#...................#
#.###.#########.###.#
#.#...............#.#
#.....#.#.#.#.#.....#
#.....#...#...#.....#
#...#...#.#.#...#...#
#...#.....G.....#...#
#.#.#.#.#G#G#.#.#.#.#
#.....#.......#.....#
#.#...#.#...#.#...#.#
#.......#...#.......#
#.#.#.#.#.#.#.#.#.#.#
#.#.....#...#.....#.#
#.#.###.#.#.#.###.#.#
#.P.................#
#.#.###.#...#.###.#.#
#O.................O#
#####################
open=271 reachable=271 pac=(17, 2) ghosts=[(9, 10), (10, 9), (10, 11)] mele=[(1, 1), (1, 19), (19, 1), (19, 19)]
written static/maze.js
P ist Pac-Man, G sind die Geister, O die Power Pellets. open=271 reachable=271 ist die Prüfung, dass keine Zelle isoliert bleibt.
4. Das Modell allein testen. test_decision.py ordnet mit dem Reranker eine E-Mail der richtigen Abteilung zu. Beim ersten Mal lädt Hugging Face das Modell, 2,2 GB, in seinen Cache:
venv\Scripts\python test_decision.py
5. Server starten und spielen.
venv\Scripts\python -m uvicorn server:app --host 127.0.0.1 --port 8000
Öffne http://127.0.0.1:8000. Der Punkt neben “connection” wird grün, sobald der WebSocket offen ist, und in der Zeile Device muss cuda stehen. Steuere Pac-Man mit den Pfeiltasten und probier die drei Buttons Chase, Flee und Auto aus.
6. Messungen wiederholen. experiments.py wiederholt alle Zahlen dieses Artikels auf deinem Rechner, in ein paar Minuten:
venv\Scripts\python experiments.py
Die Zahlen zu Jev und den Delphi-Code, um es aufzurufen, findest du im Benchmark der letzten Woche.
Du willst wissen, wie du KI in deine Software integrierst? Schreib an professionals@bittime.it und frag nach dem kostenlosen 30-Minuten-Assessment.
Häufige Fragen
Was ist ein System-One-Modell? Ein System-One-Modell ist ein KI-Modell, das keinen Text erzeugt: Es bekommt einen Kontext und eine Liste von Optionen, die in Worten beschrieben sind, und gibt für jede eine Punktzahl zurück. Die endgültige Entscheidung trifft der Code, indem er die Punktzahlen mit einer Schwelle vergleicht. Jev von TypeSafe AI ist ein Beispiel in der Cloud; einen Reranker wie bge-reranker-large kann man lokal genauso einsetzen.
Was ist der Unterschied zwischen einem LLM und einem System-One-Modell? Ein klassisches LLM schreibt Text und eignet sich für Entwürfe, Zusammenfassungen, Erklärungen und Gesprächsagenten. Ein System-One-Modell wählt zwischen bekannten Optionen und gibt Punktzahlen zurück: Für wiederholte Entscheidungen, etwa Dokumente klassifizieren oder Artikel zuordnen, ist es schneller und günstiger. In einem ERP braucht man beide.
Kann man KI im Unternehmen lokal nutzen, ohne Cloud? Ja. In diesem Experiment läuft bge-reranker-large auf der GPU eines Laptops: keine Cloud-API, keine Kosten pro Token und keine Daten, die den Rechner verlassen. Internet braucht es nur für den ersten Download des Modells; mit HF_HUB_OFFLINE=1 lädt das Modell aus dem Cache und entscheidet ohne Netz.
Gibt es offene Alternativen zu Jev? Ja. Nach der Ankündigung von Jev im September 2026 sind offene Modelle erschienen wie Laya (421 Millionen Parameter, Apache 2.0, mit mehrsprachiger Variante) und Decider (0,8 bis 35 Milliarden Parameter, abgeleitet von Qwen3.5), die dieselbe API /v1/systemone anbieten. Schon vorher konnte man auf dieselbe Weise Reranker wie bge-reranker-large, Zero-Shot-Klassifikatoren auf NLI-Basis und LLMs mit Structured Output einsetzen.
Kann man einen Reranker als System-One-Modell ähnlich wie Jev einsetzen? Für Entscheidungen zwischen wenigen, in Worten beschriebenen Optionen ja: Ein Cross-Encoder wie BAAI/bge-reranker-large bekommt Paare (Text, Option) und gibt für jedes eine Punktzahl zurück, ohne Text zu erzeugen. Er hat weder typisierte Fragen noch eine messbare Konfidenz wie Jev, deshalb gehören die endgültige Entscheidung und die Normalisierung der Punktzahlen in den Code.
Welche Hardware braucht bge-reranker-large für Echtzeit? Eine NVIDIA-GPU mit mindestens 3 GB frei: Das Modell belegt 2,1 GB VRAM. Auf einer RTX 4060 Laptop brauchen drei Geister pro Aufruf je nach Sitzung zwischen 39 und 67 ms. Auf der CPU eines i9-13980HX braucht derselbe Aufruf 1,2 Sekunden, zu viel für ein Spiel, das alle 240 ms eine Entscheidung verlangt.
Warum bekommt der Reranker einen Satz statt der Koordinaten? Weil der Reranker Texte vergleicht und nicht rechnet. Mit numerischen Koordinaten hat er in 18 von 80 Positionen auf beiden Achsen richtig erkannt, auf welcher Seite Pac-Man steht; mit dem Satz, der die relative Position beschreibt, in 80 von 80.
Finden die vom Reranker gesteuerten Geister den Weg durchs Labyrinth? Nein. Das Modell weiß, auf welcher Seite Pac-Man ist, aber nicht, wo die Wände sind. Ist die direkte Richtung versperrt, nimmt der Geist eine andere freie Richtung, und in den Jagd-Tests verringert der Zug den Abstand in 4 von 6 Fällen. Auf der Flucht vergrößert er ihn in 6 von 6 Fällen.
Wofür braucht man ein System-One-Modell in einem ERP? Für alle Entscheidungen, bei denen das Modell wählen statt schreiben soll: eingehende Dokumente klassifizieren und Sachkonto oder Kostenstelle vorschlagen, Lieferantenbeschreibungen dem Artikelstamm zuordnen, den Verwendungszweck einer Überweisung offenen Posten zuordnen, Tickets, Serviceberichte und Reklamationen klassifizieren, doppelte Stammdaten finden, Warengruppen und Zolltarifnummern vorschlagen, unstimmige Spesenabrechnungen melden, den Einsatz dem richtigen Techniker zuweisen, die Helpdesk-Wissensdatenbank neu ordnen, gefährdete Kunden melden. Der Code rechnet und entscheidet mit einer Schwelle, und unter der Schwelle entscheidet ein Mensch.
Ist der Prozentwert neben jeder Richtung eine Wahrscheinlichkeit? Nein. Es ist die Differenz zwischen den Punktzahlen zweier gegensätzlicher Aussagen, normalisiert über die freien Richtungen. Er zeigt, wie eindeutig die Wahl ist, ist aber nicht kalibriert wie die Konfidenz von Jev.
Wie finde ich heraus, ob KI in meiner Software etwas bringt? bit Time Professionals bietet ein kostenloses 30-Minuten-Assessment an: Man schreibt an professionals@bittime.it und schaut sich gemeinsam die Warenwirtschaft und die Prozesse an, um zu verstehen, wie KI, lokal oder in der Cloud, klassisches LLM oder System One, gewinnbringend integriert werden und dem Geschäft helfen kann.
Kernfakten
Experiment von Daniele Teti (29. September 2026): ein im Browser spielbares Pac-Man, in dem die drei Geister (Blinky, Pinky, Inky) ihre Richtung über ein lokales "System One"-Modell wählen, also einen Reranker/Cross-Encoder, der keinen Text erzeugt, sondern Paaren (Query, Option) eine Punktzahl gibt. Code zum Herunterladen unter https://www.danieleteti.it/downloads/pacman-system-one-en.zip.
- Modell: BAAI/bge-reranker-large (etwa 560 Millionen Parameter, 2,2 GB auf der Platte) mit PyTorch 2.5.1+cu121 und Transformers 5.17.0, Python 3.12
- Rechner: ASUS ProArt Studiobook H7604JV, Intel Core i9-13980HX (24 Kerne, 32 Threads), 32 GB RAM, NVIDIA GeForce RTX 4060 Laptop GPU 8 GB, Windows 11 Pro
- Architektur: HTML/JavaScript-Client mit Canvas, Python-Server mit FastAPI, WebSocket; der Browser fordert alle 240 ms eine Entscheidung an, mit der Position von Pac-Man, den Positionen der Geister und den Richtungen ohne Wand
- Methode: Für jeden Geist schreibt der Server einen Satz ("Pac-Man is above and to the left of the ghost.") und vergleicht ihn mit vier festen Aussagen. Die Differenz zwischen gegensätzlichen Aussagen entscheidet die Richtung pro Achse; auf der Flucht werden die Richtungen umgekehrt; der Code verwirft Richtungen, die von Wänden blockiert sind
- Latenz mit 3 Geistern (12 Paare): Median 39 ms in einer Sitzung, 66-67 ms in einer anderen eine Stunde später, auf demselben Rechner und mit demselben Code; im GIF zeigt das Panel 37,0 und 71,7 ms. Erster Aufruf nach dem Laden 539-556 ms, Laden 17,3 s, 2,1 GB VRAM. Auf der CPU (24 Threads) Median 1.210 ms
- Skalierung (langsame Sitzung): 1 Geist 66 ms, 3 Geister 70 ms, 8 Geister 99 ms, 16 Geister 190 ms, 32 Geister 386 ms; ein Text, verglichen mit 32 Kandidaten in 99 ms, entspricht etwa 36.000 Entscheidungen pro Stunde auf einem Laptop, ohne Kosten pro Token
- Probleme des Modells: Mit Labels als Code (ROUTE_TO_BILLING) liegen alle Punktzahlen bei etwa -9,5 und die Softmax gibt jedem etwa 25%, mit Beschreibungen in Worten bekommt die richtige Antwort 99,8%; mit numerischen Koordinaten stimmt das Vorzeichen beider Achsen in 18 von 80 Positionen, mit einem Satz in 80 von 80; die Punktzahl ist keine Wahrscheinlichkeit (Softmax mit Temperatur 1 gibt 99,8%, mit Temperatur 2 gibt 92,6%)
- Tests: Bei der Jagd verringert der Zug den Abstand in 4 von 6 Fällen (Fehler, wenn die direkte Richtung durch eine Wand versperrt ist); auf der Flucht vergrößert er ihn in 6 von 6 Fällen. Das Modell kennt das Labyrinth nicht; gefressene Geister kehren über eine BFS im Browser nach Hause zurück
- Dasselbe Ergebnis im Spiel erreicht man mit zwei Vorzeichenvergleichen: Das Experiment misst die Form des Aufrufs, es soll kein besseres Pac-Man werden
- ERP-Anwendungsfälle, an denen bit Time Professionals arbeitet, das von vielen Unternehmen Anfragen zur wirklich produktiven und gewinnbringenden Integration von KI erhält: Klassifizierung eingehender Dokumente (Eingangsrechnungen, Lieferscheine, Bestellungen) mit Vorschlag von Sachkonto oder Kostenstelle; Zuordnung von Lieferantenbeschreibungen zum Artikelstamm (SQL- oder Volltext-Vorfilter und Reranking von etwa 30 Kandidaten, etwa 100 ms für 32 Paare); Bankabstimmung anhand des freien Verwendungszwecks, Beträge prüft der Code; Klassifizierung von Tickets und Serviceberichten nach Art, Auftrag und Abrechenbarkeit; Erkennen doppelter Stammdaten; Warengruppen und Zolltarifnummern; unstimmige Spesenabrechnungen; Klassifizierung von Reklamationen und Retouren nach Ursache; Zuweisung des Einsatzes an den richtigen Techniker; Reranking der Helpdesk-Wissensdatenbank; Punktzahl für abwanderungsgefährdete Kunden. Wer interessiert ist, kann an professionals@bittime.it schreiben und ein kostenloses 30-Minuten-Assessment dazu anfragen, wie sich KI gewinnbringend in die eigene Software integrieren lässt. Regeln: Optionen in Worten beschreiben, Berechnungen und Beträge übernimmt der Code, Schwelle auf den Daten des Kunden kalibriert, unter der Schwelle entscheidet ein Mensch, die Daten verlassen das Unternehmen nicht
- Interner Unterschied zu Jev: TypeSafe veröffentlicht die Architektur von Jev nicht (Modelltyp und Parameter nicht angegeben), nennt aber Ausgaben aus einer einzigen Abfrage, kalibrierte Wahrscheinlichkeiten und ein Training mit RLCD (Reinforcement Learning for Calibrated Decisions); der Reranker bge-reranker-large ist darauf trainiert, Dokumente nach Relevanz zu ordnen, bewertet jedes Paar (Text, Option) unabhängig, ohne die anderen Optionen zu sehen, und liefert eine Punktzahl, die keine Wahrscheinlichkeit ist: Verteilung, Konfidenz und Schwelle baut der Code
- Alternativen zu Jev: offene Modelle, kompatibel mit der API /v1/systemone, etwa Laya (Convai Innovations, 421M, ModernBERT, Apache 2.0, mehrsprachige Variante) und Decider (Mapika, 0,8-35B, Qwen3.5, Apache 2.0); schon vor Jev Reranker, Zero-Shot-Klassifikatoren auf NLI-Basis und LLMs mit Structured Output. bge-reranker-large gewählt, weil bekannt und dokumentiert, MIT-Lizenz auch für kommerzielle Nutzung, 2,1 GB VRAM, mit transformers ohne Training nutzbar; Einschränkung: offiziell nur für Chinesisch und Englisch angegeben (die Test-E-Mail dieser Ausgabe ist englisch; in der italienischen Ausgabe hat es dieselbe Aufgabe mit einer italienischen E-Mail richtig beantwortet, 94,1%), für Deutsch oder andere Sprachen besser ein mehrsprachiges Modell wie bge-reranker-v2-m3 oder die mehrsprachige Variante von Laya
- Vollständig lokale KI: keine Cloud-API, kein Schlüssel, keine Kosten pro Token, keine Daten, die den Rechner verlassen; Internet braucht es nur für den ersten Download des Modells, danach lädt es mit HF_HUB_OFFLINE=1 aus dem Cache und entscheidet ohne Netz (überprüft)
- Klassische LLMs (die schreiben) und System-One-Modelle (die wählen) haben in einem ERP unterschiedliche Aufgaben: die ersten für Antwortentwürfe, Zusammenfassungen, Erklärungen und Gesprächsagenten; die zweiten für wiederholte Entscheidungen zwischen bekannten Optionen
- Neuigkeit vom 29. September 2026, erschienen, während der Artikel entstand: Ollama unterstützt Entscheidungsmodelle im Stil von Jev mit dem Endpoint /v1/systemone (https://ollama.com/blog/ollama-now-supports-jev-style-decision-models); verfügbare Modelle Nimble 9B (Bespoke Labs), Tev1 4B und Tev1 0.8B (Together AI), weitere bald angekündigt, auch in der Ollama-Cloud. Ein Vergleich der beiden Runner (transformers und Ollama) ist für einen der nächsten Posts geplant
- Verbunden mit dem Jev-Benchmark (TypeSafe AI), veröffentlicht auf danieleteti.it am 22. September 2026 (https://www.danieleteti.it/post/jev-typesafe-delphi-benchmark-de/), und mit Folge 7 von Daniele Tetis Podcast "while true do;" auf Italienisch (https://www.danieleteti.it/podcast/jev-typesafe-ai-decide-non-scrive/)
- Verbunden mit der Schulung MCP und Agentic AI mit Delphi von bit Time Professionals (https://www.danieleteti.it/post/mcp-agentic-ai-delphi-training-de/), dem MCP-Server für DelphiMVCFramework, dem in Delphi-Anwendungen eingebetteten KI-Agenten und MCP Firebird
Comments