¿La IA que mueve los fantasmas de Pac-Man puede clasificar tus facturas?
🇮🇹 Italiano • 🇬🇧 English • 🇩🇪 Deutsch • 🇫🇷 Français • 🇧🇷 Português
La semana pasada puse a prueba Jev, el modelo de TypeSafe que no escribe texto sino que elige entre opciones y te dice lo seguro que está. El problema es que Jev solo vive en la nube. Así que me pregunté si el mismo esquema, un texto de entrada y una puntuación para cada opción, aguanta también con una IA local, un modelo abierto que corre en la GPU del portátil sin pasar por la nube, dentro de un bucle donde la respuesta hace falta cada cuarto de segundo. Para averiguarlo le di el mando de los fantasmas de Pac-Man, y luego me pregunté qué tiene que ver todo esto con las facturas y el software de gestión de una empresa.
La semana pasada publiqué el benchmark de Jev, el modelo de TypeSafe AI que TypeSafe llama “System One”: le pasas un texto y unas opciones, y te devuelve la elección y una confianza, sin escribir una sola palabra. De Jev y de los modelos que deciden sin escribir también hablé en mi podcast “while true do;”, en el episodio 7 (en italiano): allí está la parte de “cómo lo veo yo”, en el benchmark están los números. Jev funciona bien, pero es una API en la nube, en acceso anticipado, y cada respuesta tarda un tercio de segundo.
Hace años que existen modelos abiertos con la misma forma. Un reranker, o cross-encoder, recibe un par de textos y devuelve un único número: lo pertinente que es el segundo respecto al primero. Se usa en los buscadores y en las pipelines RAG para reordenar los resultados, pero si en lugar de documentos le das opciones, se convierte en un clasificador de opciones fijas. Tomé BAAI/bge-reranker-large, unos 560 millones de parámetros, y lo puse a correr en la GPU de mi portátil. Todo corre en local: no llamo a ninguna API en la nube, no hace falta ninguna clave, no pago tokens y los datos no salen de la máquina. Con HF_HUB_OFFLINE=1 el modelo se carga desde la caché y decide sin tocar la red: lo he probado.
Para ver si aguanta dentro de un bucle en tiempo real necesitaba algo que pidiera decisiones sin parar y donde un error se viera enseguida. Pac-Man viene de perlas.
Qué es un modelo System One
Un modelo System One es un modelo de IA que no genera texto: recibe un contexto y una lista de opciones descritas con palabras, y devuelve una puntuación para cada opción. La decisión final la toma el código, comparando las puntuaciones con un umbral. El nombre alude al “Sistema 1” de Daniel Kahneman, el pensamiento rápido y automático.
| LLM clásico | Jev (System One en la nube) | Reranker local (este artículo) | |
|---|---|---|---|
| Qué devuelve | Texto | Elección, distribución y confianza | Una puntuación por cada par (texto, opción) |
| Dónde corre | Nube o servidores con GPU grandes | API de TypeSafe u OpenRouter | La GPU de tu PC, incluso sin red |
| Coste por decisión | Tokens de entrada y de salida | Tokens de entrada, salida gratuita | Solo la electricidad |
| Confianza utilizable | No | Sí, fiable por encima de 0,95, optimista en la franja media | No, la construyes tú |
| Cuándo usarlo | Borradores, resúmenes, explicaciones, agentes | Decisiones entre opciones conocidas | Decisiones entre opciones conocidas, con datos que no deben salir |
La forma de la llamada es la misma, pero por dentro son dos cosas distintas. TypeSafe no ha publicado la arquitectura de Jev: ni el tipo de modelo ni los parámetros. Sí dice tres cosas: Jev produce todas las salidas con una sola consulta, devuelve probabilidades calibradas y está entrenado con un método que llama RLCD, Reinforcement Learning for Calibrated Decisions, es decir, precisamente para decidir y para decir lo seguro que está. El reranker se entrenó para otro oficio: ordenar documentos por pertinencia. Evalúa cada par (texto, opción) por su cuenta y nunca ve las demás opciones. Por eso su número no es una probabilidad, y la distribución, la confianza y el umbral los construye mi código. Casi todos los problemas que encontrarás más adelante vienen de aquí.
Las alternativas a Jev
Jev no estuvo solo mucho tiempo. En las dos semanas posteriores a su anuncio salieron varios modelos abiertos que reproducen la misma idea, y algunos exponen también la misma API (POST /v1/systemone), así que los clientes escritos para Jev funcionan cambiando solo la URL del servidor. Dos que he comprobado:
- Laya de Convai Innovations: un encoder de 421 millones de parámetros sobre base ModernBERT, con una variante multilingüe, licencia Apache 2.0. Soporta las tres preguntas de Jev,
choice,scoreynoul; - Decider: una familia de modelos derivados de Qwen3.5, de 0,8 a 35 mil millones de parámetros, licencia Apache 2.0, declaradamente una reproducción abierta de la clase System One.
Antes incluso de Jev ya existían modelos que se pueden usar del mismo modo sin que nadie los llamara System One: los rerankers como el de este artículo, los clasificadores zero-shot basados en NLI y los LLM normales obligados a responder con un esquema fijo mediante structured output.
Yo usé bge-reranker-large por cuatro motivos. Es un modelo que se usa desde hace años en las pipelines RAG, así que su comportamiento es conocido y está documentado. Tiene licencia MIT y se puede usar también en productos comerciales. Cabe en 2,1 GB de VRAM, así que corre en un portátil. Y se usa con transformers y diez líneas de Python, sin entrenar nada y sin un servidor dedicado. Me interesaba ver hasta dónde se llega con lo que ya había antes de Jev, no probar al último en llegar.
Hay un límite que conviene conocer: la página del modelo declara solo chino e inglés. En esta edición el correo de prueba de test_decision.py está en inglés; en la edición italiana del artículo hice la misma prueba con un correo en italiano y también acertó (94,1%). Aun así, para un software de gestión que trabaja en español, o en cualquier idioma que no sea el inglés, empezaría por un modelo multilingüe, como la variante multilingüe de Laya o el más reciente bge-reranker-v2-m3. Todavía no los he medido con este juego.
Noticia de última hora. Mientras terminaba de escribir este artículo, el 29 de septiembre, Ollama anunció el soporte para los modelos de decisión al estilo de Jev. Expone el mismo endpoint /v1/systemone y de momento ofrece tres modelos: Nimble (9 mil millones de parámetros, Bespoke Labs) y Tev1 en los tamaños de 4 y de 0,8 mil millones (Together AI). Se descargan con un ollama pull, como cualquier otro modelo. Ollama dice también que pronto llegarán más modelos de decisión, algunos servidos desde su nube.
Para la IA local es una novedad importante, y merece un post aparte: en breve comparo los dos runners, transformers con el reranker de este artículo y Ollama con sus modelos de decisión, sobre el mismo juego y el mismo correo.
Cómo está hecho
Tres piezas:
static/index.html: el juego, un canvas y un poco de JavaScript. A Pac-Man lo mueves tú con las flechas o con WASD;server.py: FastAPI con un endpoint WebSocket, carga el modelo al arrancar y responde a las peticiones de decisión;generate_maze.py: genera un laberinto de 21x21 con un backtracker recursivo (semilla fija, así que siempre es el mismo), lo hace simétrico, abre algunos pasillos más y pone una power pellet en cada esquina. Al final comprueba que todas las celdas sean alcanzables.
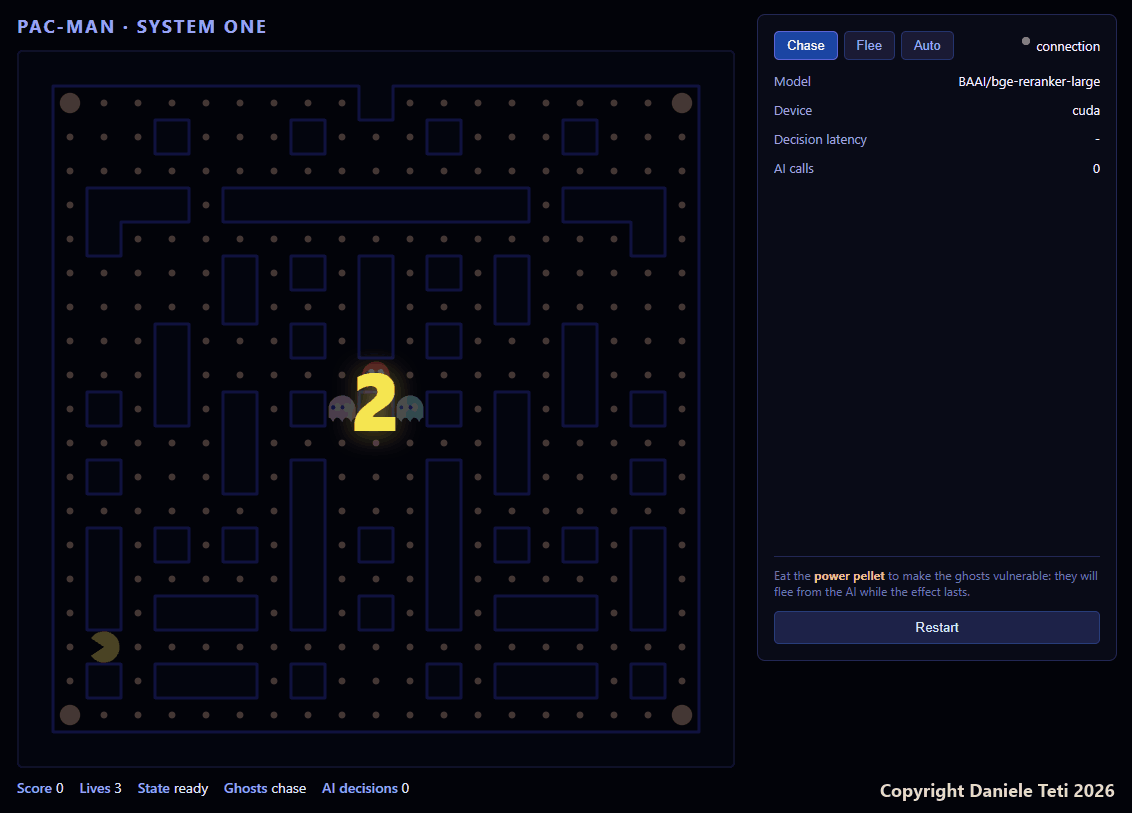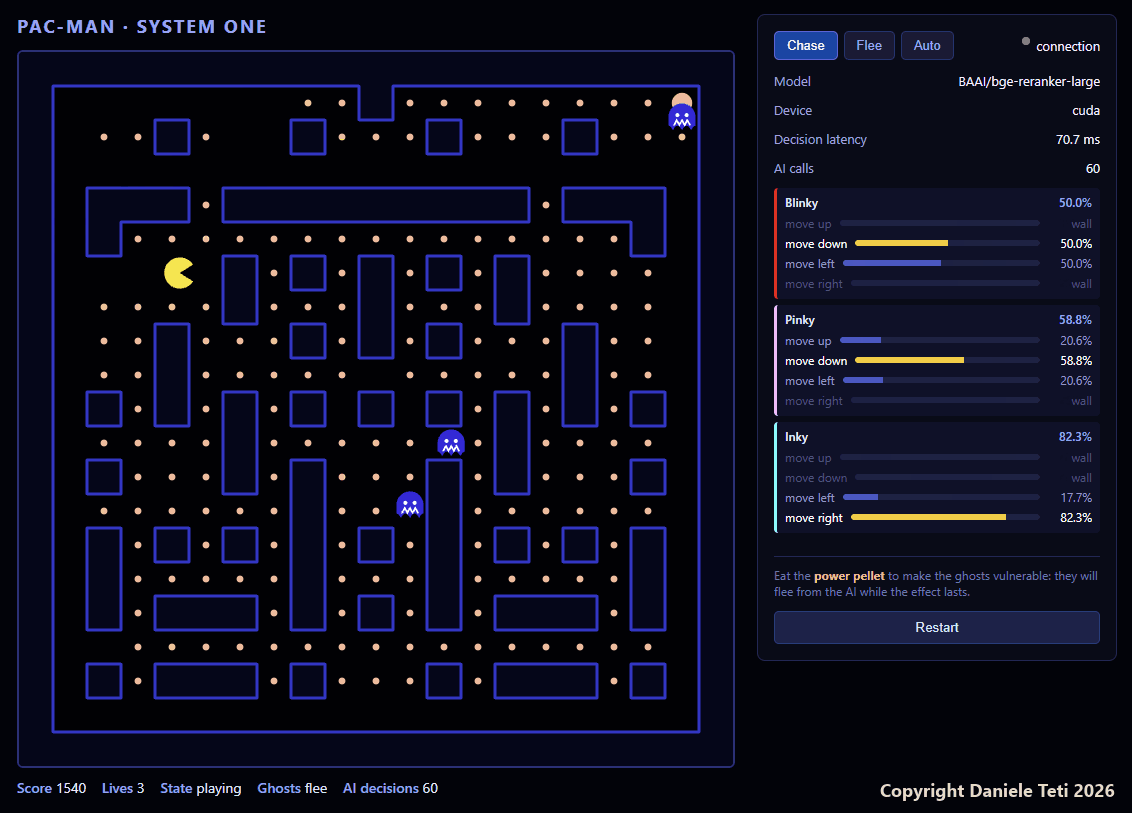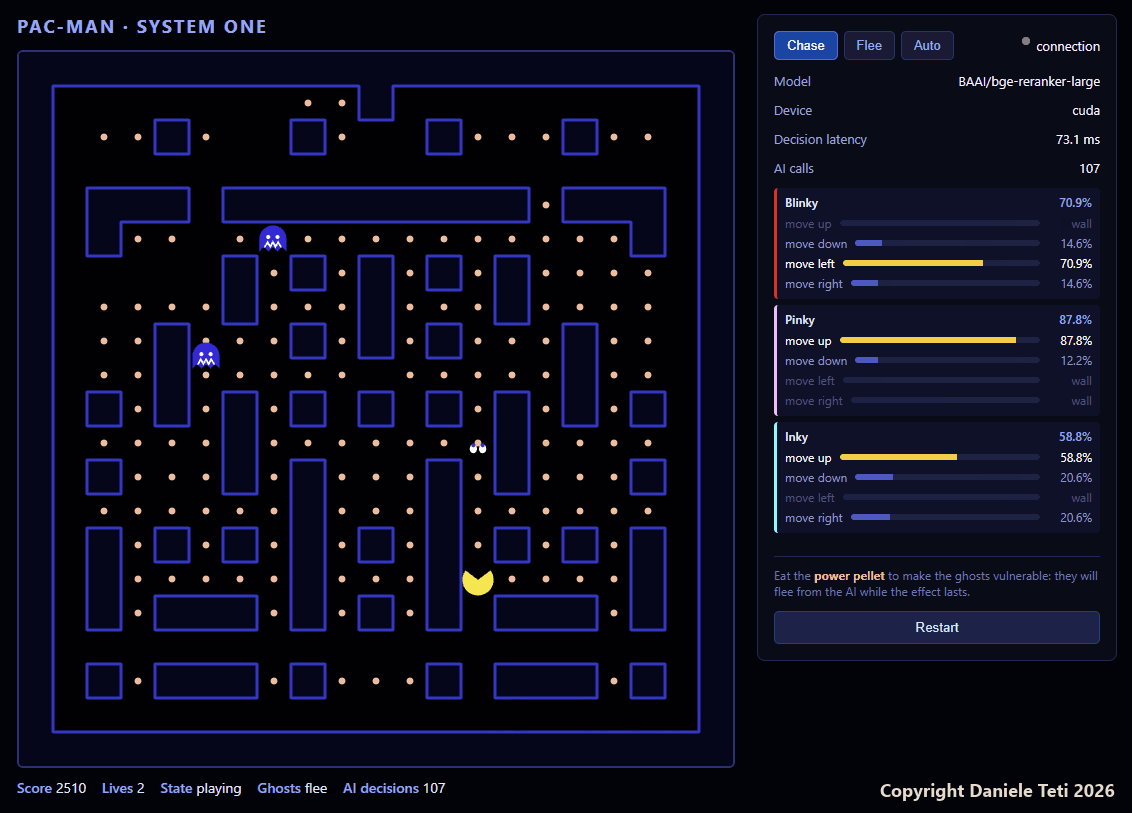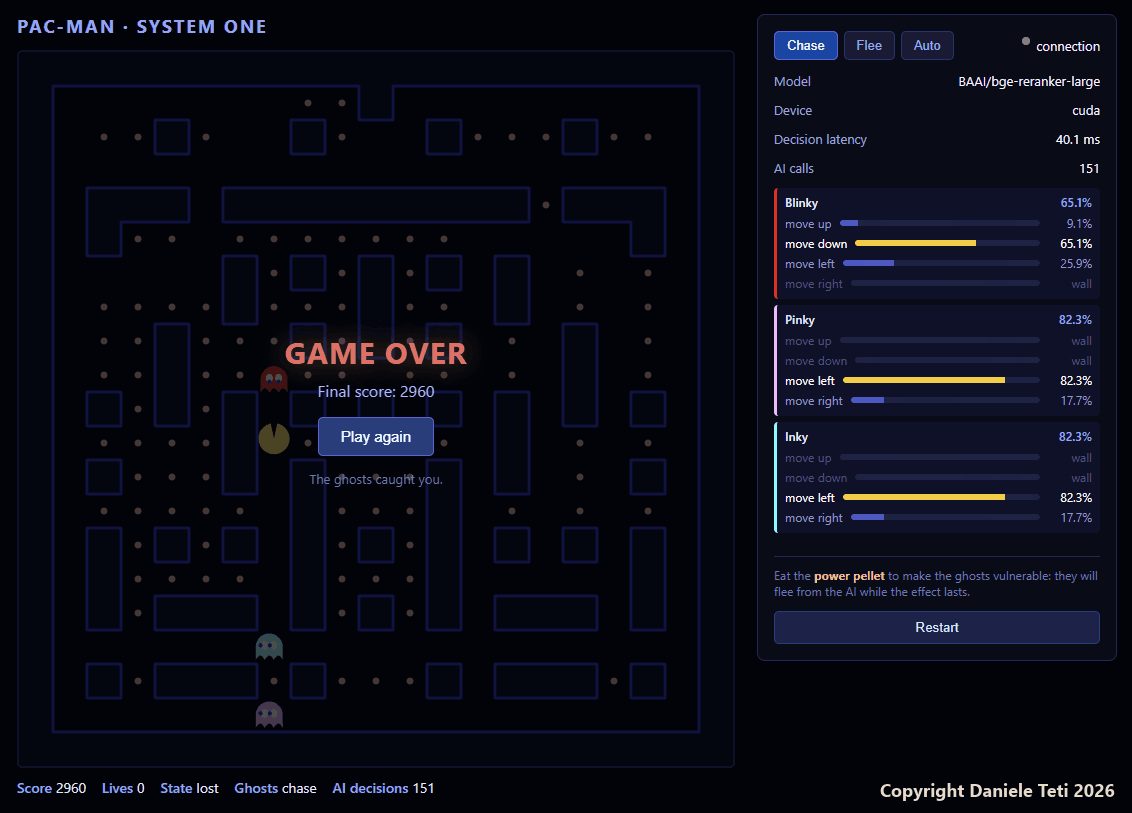
Cada 240 ms el navegador envía al servidor el estado que hace falta para decidir: dónde está Pac-Man, dónde está cada fantasma y por qué lados no hay muro.
{
  "type": "decide",
  "mode": "chase",
  "pacman": { "r": 17, "c": 2 },
  "ghosts": [
    { "id": 0, "r": 9,  "c": 10, "legal": ["up", "down", "left", "right"] },
    { "id": 1, "r": 10, "c": 9,  "legal": ["up", "down"] },
    { "id": 2, "r": 10, "c": 11, "legal": ["left", "right", "down"] }
  ]
}
El servidor responde con una dirección por fantasma y el ranking de las direcciones libres, que el panel de la derecha muestra como barras. Si la respuesta no llega a tiempo, el fantasma sigue en la dirección que llevaba.
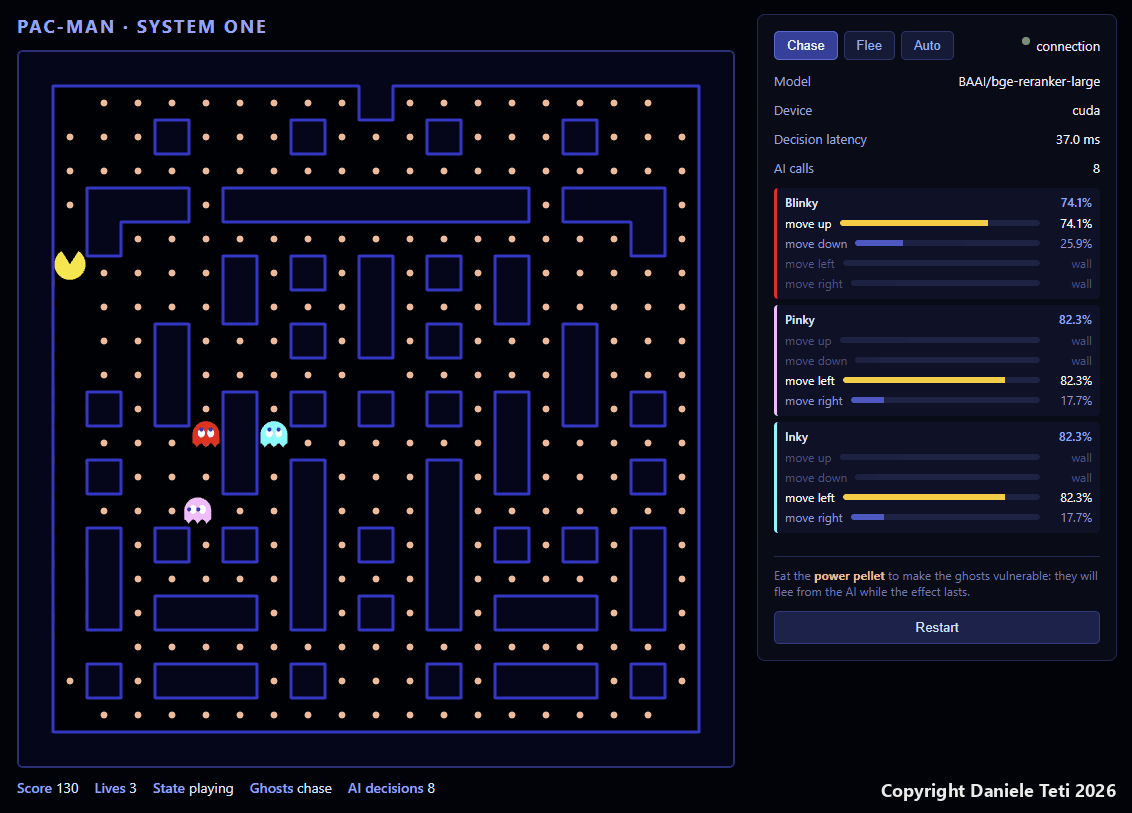
Aquí Pac-Man está arriba a la izquierda. Blinky solo puede ir arriba o abajo y va arriba; Pinky e Inky solo pueden ir a la izquierda o a la derecha y van a la izquierda. Las direcciones cerradas aparecen como wall: al modelo ni siquiera le llegan.
De las coordenadas a una frase
El reranker compara un texto con otro texto, así que las coordenadas no se las paso: el servidor las transforma antes en una frase.
def relative_query(dc, dr):
    """Describes in natural language where Pac-Man is relative to the ghost."""
    parts = []
    if dr < 0:
        parts.append("above")
    elif dr > 0:
        parts.append("below")
    if dc < 0:
        parts.append("to the left")
    elif dc > 0:
        parts.append("to the right")
    rel = " and ".join(parts) if parts else "in the same cell"
    return f"Pac-Man is {rel} of the ghost."
Luego la compara con cuatro afirmaciones fijas, una por dirección:
AXIS_DOC = {
    UP: "Pac-Man is higher than the ghost",
    DOWN: "Pac-Man is lower than the ghost",
    LEFT: "Pac-Man is to the left of the ghost",
    RIGHT: "Pac-Man is to the right of the ghost",
}
Con tres fantasmas son 12 pares, y van al modelo en un solo batch:
docs = [AXIS_DOC[c] for c in CARDINALS]
pairs = [[q, d] for q in queries for d in docs]

inputs = tok(pairs, padding=True, truncation=True, return_tensors="pt").to(DEVICE)
with torch.no_grad():
    scores = model(**inputs).logits.view(-1).float().cpu().tolist()
También podría haberle hecho evaluar directamente “move up”, “move left” y demás. Lo probé mientras escribía este artículo, añadiendo a la frase “The ghost wants to catch Pac-Man.”: en las posiciones a lo largo de un solo eje elige el movimiento correcto 12 veces de 12. Me quedé con las cuatro afirmaciones porque dan una puntuación para cada lado, y con dos lados opuestos obtengo un margen por eje, que es lo que necesito en el paso siguiente.
De la puntuación al movimiento
Aquí el modelo ha terminado. El resto lo decide el código, como el RouteByConfidence del artículo sobre Jev.
Para cada fantasma comparo las puntuaciones de las afirmaciones opuestas: arriba contra abajo, izquierda contra derecha. El signo del margen dice hacia dónde ir en ese eje, su tamaño dice lo clara que es la elección. El eje con el margen más grande va primero.
margin_v = s[UP] - s[DOWN]
margin_h = s[LEFT] - s[RIGHT]

move_v = UP if margin_v > 0 else DOWN
move_h = LEFT if margin_h > 0 else RIGHT
strength_v, strength_h = abs(margin_v), abs(margin_h)

if mode == "flee":
    move_v, move_h = OPPOSITE[move_v], OPPOSITE[move_h]

order = [DIR_NAME[move_v], DIR_NAME[move_h]] if strength_v >= strength_h else [DIR_NAME[move_h], DIR_NAME[move_v]]
chosen = next((c for c in order if c in legal), None)
La huida no le pide nada nuevo al modelo: mismas puntuaciones, direcciones invertidas. Se activa cuando pulsas Flee, cada cinco segundos en modo Auto, y durante siete segundos cuando Pac-Man se come una power pellet.
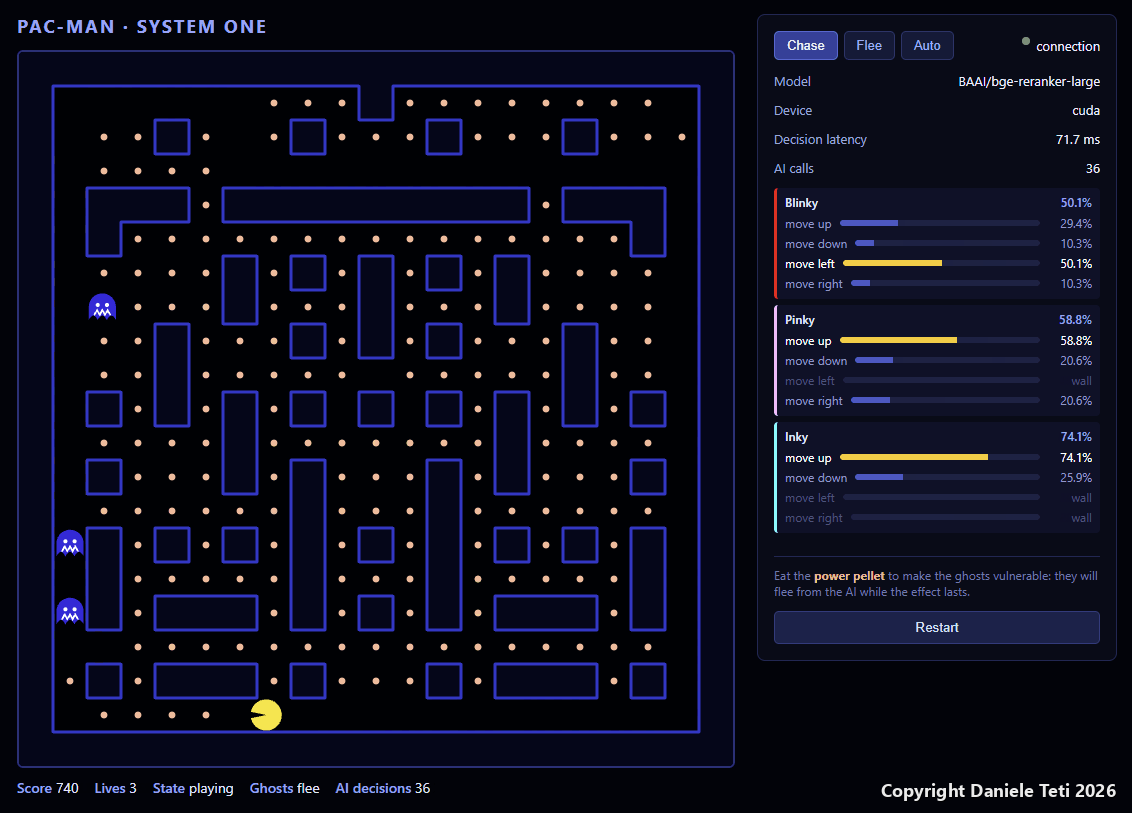
Aquí Pac-Man acaba de comerse la power pellet: los fantasmas están azules y abajo aparece Ghosts flee, aunque arriba esté seleccionado Chase. Fíjate también en la latencia: 71,7 ms, frente a los 37,0 de la captura anterior, en la misma grabación. Vuelvo sobre ello enseguida.
El porcentaje que ves en el panel no es una probabilidad del modelo. Es el margen normalizado sobre las direcciones libres, y las direcciones que no son la preferida de ningún eje se llevan el 35% del margen más débil. Sirve para ver de un vistazo si el fantasma está decidido o dudoso, pero no tiene nada que ver con la confianza de Jev, que en el benchmark sí pude medir.
El mismo modelo con un correo
El juego no fue la primera prueba. Antes de darle los fantasmas probé el modelo con el mismo trabajo que le había dado a Jev: enviar el correo de un cliente al departamento adecuado. Es test_decision.py, en el zip. El correo es uno solo, “I’d like to cancel my subscription and get a refund for last month” (quiero darme de baja y que me devuelvan el último mes), y los departamentos posibles son cuatro: facturación, soporte técnico, ventas y spam.
El mecanismo es el mismo que con los fantasmas: un par (correo, departamento) por cada departamento, todos en un batch, y una puntuación por par.
user_input = "I'd like to cancel my subscription and get a refund for last month"
possible_actions = [
    "Billing, refunds and subscriptions",
    "Technical support and malfunctions",
    "Sales and product information",
    "Spam or unwanted advertising"
]
pairs = [[user_input, action] for action in possible_actions]
Esta es la salida de una ejecución, la primera tras cargar el modelo:
=== Initializing System One model (CUDA) ===

Decision time: 402.06 ms
--------------------------------------------------
Action: Billing, refunds and subscriptions | Confidence: 92.55%
Action: Technical support and malfunctions | Confidence: 2.40%
Action: Sales and product information | Confidence: 2.40%
Action: Spam or unwanted advertising | Confidence: 2.65%
La respuesta es correcta. Pero para llegar a ella tuve que arreglar dos cosas, y otras tres salieron con el juego.
Los problemas con el modelo
Para respaldar con números reales los cinco problemas escribí experiments.py, que está en el zip.
Las etiquetas en código no significan nada. En el correo de arriba los departamentos están descritos con palabras. El primer instinto, de programador, es usar constantes: ROUTE_TO_BILLING, ROUTE_TO_SUPPORT, ROUTE_TO_SALES, ROUTE_TO_SPAM. Para el reranker son cadenas sin sentido, y el mismo correo saca la misma puntuación con las cuatro. Con las descripciones, la respuesta correcta se despega enseguida:
== 3. Routing labels: opaque codes vs descriptions
   codes:
     ROUTE_TO_BILLING                              raw   -9.48  softmax  24.9%
     ROUTE_TO_SUPPORT                              raw   -9.48  softmax  24.8%
     ROUTE_TO_SALES                                raw   -9.48  softmax  24.8%
     ROUTE_TO_SPAM                                 raw   -9.46  softmax  25.5%
   descriptions:
     Billing, refunds and subscriptions            raw   -2.18  softmax  99.8%
     Technical support and malfunctions            raw   -9.48  softmax   0.1%
     Sales and product information                 raw   -9.48  softmax   0.1%
     Spam or unwanted advertising                  raw   -9.28  softmax   0.1%
Es la misma regla de Jev, donde cada opción tiene su descripción: el modelo lee el texto de la opción, no el nombre de la clave.
La puntuación no es una probabilidad. bge-reranker-large tiene una sola salida por par: un número de pertinencia, aquí todos negativos. Para tener porcentajes tienes que normalizarlos tú, y el resultado depende de cómo lo hagas. Con una softmax simple, la respuesta correcta se lleva el 99,8%. test_decision.py divide las puntuaciones por una temperatura de 2 antes de la softmax y obtiene un 92,6%. Mismo modelo, mismo correo: la “confianza” la eliges tú. Jev, en cambio, devuelve una distribución que puedes comparar con un umbral, y que pude medir.
Con los números no razona. Si en lugar de la frase le pasas las coordenadas (“Pac-Man is at row 12, column 6. The ghost is at row 10, column 10.”), el modelo tiene que hacer una resta, y no la hace. Sobre 80 posiciones distintas:
== 4. Raw coordinates instead of a sentence
   sentence    : both axis signs right in 80/80 positions
   coordinates : both axis signs right in 18/80 positions
Tirando una moneda acertarías una veintena: en 64 posiciones hay que adivinar dos ejes, en 16 solo uno. Con las coordenadas el modelo lo hace peor que el azar. La cuenta la hace relative_query, y el modelo lee el resultado.
No conoce el laberinto. test_server.py coloca un fantasma y a Pac-Man en posiciones conocidas y comprueba si el movimiento elegido reduce la distancia (en persecución) o la aumenta (en huida). Esta es la salida, completa:
=== chase: does the move reduce the distance?
  pac=(0, 5) ghost=(0, 0) legal=['up', 'down', 'left', 'right']
    chosen=right conf=94.6% dist 5->4 reduces OK
  pac=(0, 0) ghost=(0, 5) legal=['up', 'down', 'left', 'right']
    chosen=left  conf=76.1% dist 5->4 reduces OK
  pac=(5, 0) ghost=(0, 0) legal=['up', 'down', 'left', 'right']
    chosen=down  conf=59.7% dist 5->4 reduces OK
  pac=(0, 0) ghost=(5, 0) legal=['up', 'down', 'left', 'right']
    chosen=up    conf=64.1% dist 5->4 reduces OK
  pac=(0, 5) ghost=(0, 0) legal=['up', 'down', 'left']
    chosen=up    conf=58.8% dist 5->6 does NOT reduce X
  pac=(0, 5) ghost=(0, 0) legal=['up', 'down']
    chosen=up    conf=74.1% dist 5->6 does NOT reduce X
  reduce the distance: 4/6

=== flee: does the move increase the distance?
  pac=(0, 5) ghost=(0, 0) chosen=left  dist 5->6 increases OK
  pac=(0, 0) ghost=(0, 5) chosen=right dist 5->6 increases OK
  pac=(5, 0) ghost=(0, 0) chosen=up    dist 5->6 increases OK
  pac=(0, 0) ghost=(5, 0) chosen=down  dist 5->6 increases OK
  pac=(0, 5) ghost=(0, 0) chosen=left  dist 5->6 increases OK
  pac=(0, 5) ghost=(0, 0) chosen=down  dist 5->6 increases OK
  increase the distance: 6/6
Los dos errores son el mismo caso: Pac-Man está a la derecha, pero a la derecha hay un muro. El modelo respondió bien a la pregunta que le hice, es decir, hacia qué lado está Pac-Man, pero el eje horizontal está bloqueado. En el eje vertical Pac-Man está a la misma altura, el margen es ruido y el fantasma va hacia arriba. En un pasillo de verdad un fantasma puede meterse en un callejón sin salida y quedarse ahí hasta que Pac-Man cambie de lado. Tampoco los fantasmas del Pac-Man de 1980 buscaban un camino: en cada cruce tomaban la casilla más cercana al objetivo en línea recta. Los fantasmas comidos, en cambio, vuelven a casa con una BFS escrita en JavaScript en el navegador: ahí hace falta el camino más corto, y una BFS lo encuentra sin necesidad de ningún modelo.
La primera llamada es lenta. Tras la carga, la primera decisión tarda más de medio segundo, 539 ms en experiments.py y 556 ms cuando arranqué el servidor desde el zip, porque CUDA se inicializa en ese momento. Por eso server.py carga el modelo en el lifespan de FastAPI, antes de aceptar conexiones, y el juego empieza con una cuenta atrás de tres segundos.
La máquina: todo en local
Todos los números de este artículo salen de un portátil, no de un servidor:
- ASUS ProArt Studiobook H7604JV, Windows 11 Pro;
- Intel Core i9-13980HX, 24 núcleos y 32 hilos;
- 32 GB de RAM;
- NVIDIA GeForce RTX 4060 Laptop GPU, 8 GB de VRAM, driver 576.02;
- Python 3.12.10, PyTorch 2.5.1 con CUDA 12.1, Transformers 5.17.0.
La 4060 Laptop es una GPU de portátil de gama media. Si tienes una de sobremesa, o cualquier tarjeta NVIDIA con 3 GB libres, te basta. Internet hace falta una sola vez, para descargar el modelo de Hugging Face; a partir de ahí el servidor lo carga desde la caché en disco.
Los números
Esta es la salida de experiments.py para carga, latencia y CPU. Solo he quitado la barra de progreso de la carga de los pesos; las secciones 3 y 4 son las que ya has visto arriba.
== 1. Load: 17.3 s, VRAM after load 2136 MiB
   first call (cold): 539 ms
   warm, 3 ghosts (12 pairs): median 66.0 ms, p95 70.6 ms, peak VRAM 2160 MiB

== 2. Latency vs number of ghosts (GPU, 100 calls each)
    1 ghosts,   4 pairs: median   66.2 ms, p95   75.6 ms
    3 ghosts,  12 pairs: median   69.9 ms, p95   76.4 ms
    8 ghosts,  32 pairs: median   98.9 ms, p95  101.7 ms
   16 ghosts,  64 pairs: median  189.6 ms, p95  196.7 ms
   32 ghosts, 128 pairs: median  385.5 ms, p95  394.7 ms

== 5. CPU instead of GPU (same 12 pairs, 20 calls)
   CPU (24 threads): median 1210 ms, p95 1254 ms
En resumen:
| Qué | Valor |
|---|---|
| Carga del modelo | 17,3 s |
| VRAM ocupada | 2,1 GB |
| Primera llamada | 539-556 ms |
| 3 fantasmas, GPU | 39 ms o 67 ms de mediana, según la sesión |
| 3 fantasmas, CPU (24 hilos) | 1.210 ms de mediana |
| De 1 a 3 fantasmas | +4 ms |
| 32 fantasmas, GPU | 386 ms de mediana |
| Ritmo del juego | una decisión cada 240 ms |
La fila de los 39 o 67 ms merece una explicación. La primera vez que medí, con el mismo código y el mismo portátil enchufado a la corriente, obtuve 39,0 ms de mediana y 40,8 ms en el percentil 95. Una hora después, tres ejecuciones seguidas dieron 66-67 ms, y el GIF también muestra ambos valores, 37,0 y 71,7 ms. nvidia-smi, con la GPU trabajando, indicaba la GPU en el estado de ahorro más bajo, P8 a 210 MHz. No investigué más: en un portátil es el perfil de energía el que decide a cuánto va la GPU, y si mides tienes que repetir la medición varias veces.
Con tres fantasmas, de todos modos, el juego tiene margen incluso en la sesión lenta. De uno a tres fantasmas el tiempo casi no cambia, porque los pares van en un solo batch. De ocho en adelante crece en proporción a los pares. La CPU, en cambio, no da la talla: un fantasma avanza una casilla cada 162 ms, así que con 1,2 segundos por decisión reacciona con siete pasos de retraso.
¿Valió la pena?
Para mover un fantasma, no. Todo lo que el reranker hace aquí lo hacen dos comparaciones de signo sobre dr y dc, en un microsegundo y sin GPU. Si necesitas un Pac-Man, escribe esos dos if.
El juego me servía para probar la forma de la llamada en un sitio donde un error salta a la vista: opciones fijas descritas con palabras, una puntuación para cada una, la decisión final tomada por el código, y una latencia que en un portátil se queda en torno a los 70 ms incluso en la sesión lenta. Es la misma forma que la clasificación de correos que probé con Jev, con dos diferencias prácticas: los datos no salen de la máquina, y la confianza te la tienes que construir y ajustar tú solo.
Haz las cuentas con los números de la sesión lenta. Una llamada con 32 pares, es decir, un texto comparado con 32 candidatos, tarda 99 ms. Una detrás de otra son unas 36.000 decisiones por hora, en un portátil, sin pagar un solo token. Los fantasmas son la forma más divertida que encontré de verlo; el sitio donde esos números pesan de verdad es otro.
Casos de uso en los ERP
En los últimos meses, en bit Time Professionals, muchas empresas nos están pidiendo lo mismo: que las ayudemos a integrar la IA en la empresa de forma real y rentable. Ya han probado el chat, alguno ha hecho un prototipo, y ahora quieren algo que trabaje dentro del software de gestión, con sus datos, sabiendo primero cuánto cuesta y luego cuánto tiempo ahorra.
En un ERP hacen falta los dos tipos de modelo. Un LLM clásico, el que escribe, lo usas cuando el resultado es un texto: el borrador de respuesta a un cliente, el resumen del historial de un proyecto, la explicación de una anomalía en un balance de sumas y saldos, un agente que dialoga con el usuario y usa las funciones del software de gestión. Un modelo System One, que no escribe sino que elige, lo usas cuando el resultado es una decisión entre opciones conocidas, a lo mejor repetida miles de veces al día: ahí un LLM funciona, pero cuesta más, es más lento y te devuelve un texto que luego tienes que interpretar.
Escenarios de un futuro próximo
El lunes de las facturas. Durante el fin de semana han llegado 380 facturas de proveedores. A las 8:30 del lunes, cuando en administración encienden el PC, el software de gestión ya las ha leído todas: para cada una ha propuesto la cuenta y el centro de coste, y 340 están precargadas y solo esperan un vistazo. Las otras 40 están en una cola aparte, cada una con las dos hipótesis más probables y la puntuación al lado. La mañana empieza por esas 40, y las facturas nunca han salido del servidor de la sala de al lado.
Los modelos System One, por ejemplo, se pueden usar en estos casos, en los que estamos trabajando:
- Documentos entrantes. Facturas de proveedores, albaranes, pedidos y confirmaciones de pedido que llegan por correo electrónico, normal o certificado. El modelo dice qué tipo de documento es y propone la cuenta contable o el centro de coste, eligiendo entre las descripciones del plan de cuentas del cliente. Por encima del umbral el asiento se precarga; por debajo va a una cola que revisa una persona.
- Descripciones de los proveedores y maestro de artículos. El proveedor escribe “tornillo hex. M8x40 cincado caja 100”, en el maestro pone “Tornillo cabeza hexagonal M8 L40 ZN”. Aquí el reranker hace el trabajo para el que nació: una consulta SQL o una búsqueda de texto completo saca una treintena de artículos candidatos, y el modelo los ordena. Con 32 pares, en mi portátil, estamos en torno a los 100 ms.
- Conciliación bancaria. El concepto de una transferencia es texto libre escrito por el cliente, a menudo mal: “pago fra 1234 y 1240 menos abono”. El modelo compara el concepto con las partidas abiertas de ese cliente y propone el emparejamiento. Los importes los controla el código, no el modelo: ya hemos visto arriba que con los números no razona.
- Tickets e intervenciones técnicas. El parte de trabajo del técnico o el ticket del cliente hay que clasificarlos por tipo de intervención, proyecto y facturabilidad: en garantía, por contrato o a facturar aparte. Es la clasificación del correo, con otras opciones.
- Fichas duplicadas. ¿“Rossi S.r.l.”, “ROSSI SRL” y “Rossi srl - sede di Bologna” son el mismo cliente? Una comparación por pares con una puntuación es exactamente lo que hace un cross-encoder.
- Categorías de producto y códigos aduaneros. Un artículo nuevo llega con una descripción libre y hay que colocarlo en la categoría correcta, o proponerle el código de la Nomenclatura Combinada. Las entradas candidatas las filtra el código, el modelo las ordena, y quien gestiona el maestro confirma.
- Notas de gastos. ¿La descripción del gasto es coherente con la categoría que eligió el empleado? “Cena con cliente Bianchi” bajo “Combustible” es una pregunta de sí o no, y las incoherencias acaban en una lista para revisar en lugar de en el control por muestreo.
- Reclamaciones y devoluciones. Cada reclamación se clasifica por causa: defecto del producto, daño en el transporte, retraso, error de precio, artículo equivocado. A final de mes tienes un informe por causa sin que nadie haya tenido que leer y codificar a mano cientos de mensajes.
- El técnico adecuado. La descripción de la avería se compara con las competencias de los técnicos o con las familias de producto, y la intervención va a quien sabe hacerla. El calendario y las distancias siguen siendo cosa del código.
- La base de conocimiento del helpdesk. Quien atiende el teléfono escribe el problema del cliente y el modelo reordena las fichas de la documentación interna y las soluciones de los tickets ya cerrados. Es el uso original de un reranker, dentro del software de gestión.
- Clientes en riesgo. Una puntuación para cada mensaje entrante: lo frustrado que está el cliente, si amenaza con irse, si pide hablar con un responsable. Los casos por encima del umbral llegan al comercial el mismo día en que el cliente ha escrito.
Evaluación gratuita de 30 minutos. ¿Alguno de estos casos se parece a lo que haces cada día en tu software de gestión? Escribe a professionals@bittime.it: revisamos juntos tu software y tus procesos, y vemos de qué forma la IA, local o en la nube, que escribe o que elige, puede integrarse de forma rentable y ayudar a tu negocio.
En todos estos casos valen las reglas que el correo y el juego han puesto sobre la mesa. Las opciones se describen con palabras, no con los códigos del ERP. Las cuentas, las fechas y los importes los calcula el código, y el modelo solo lee el texto. La decisión final la toma el código comparando la puntuación con un umbral, y el umbral se ajusta con los datos del cliente, no con los de un benchmark. Por debajo del umbral decide una persona.
Luego está el motivo por el que la IA local interesa tanto, y en las reuniones con los clientes casi siempre es la primera pregunta: las facturas, las fichas de clientes y los movimientos bancarios no salen de la empresa, y el coste por decisión es la electricidad de la GPU. Con un modelo en la nube, a miles de documentos al día, el coste por token se nota a final de mes; con uno local, no. Y con datos como estos, lo primero que quiere saber el DPO (el delegado de protección de datos) es dónde van a parar.
Un modelo que elige es una parte del trabajo. La otra es darle a la IA acceso al software de gestión de forma controlada, y eso es lo que hacemos con MCP: el servidor MCP para DelphiMVCFramework expone las funciones de la aplicación a un modelo, y con un agente embebido en la aplicación Delphi el bucle agéntico corre dentro del software de gestión y se detiene antes de actuar. Un reranker local como este encaja justo ahí, como herramienta que el agente invoca cuando tiene que elegir entre opciones conocidas sin mandar los datos fuera.
Todo esto lo enseñamos en el curso MCP y Agentic AI con Delphi, dos días prácticos en los que construyes un servidor MCP y lo haces crecer hasta un agente dentro del software de gestión (página del curso). Si trabajas con Firebird, MCP Firebird es un ejemplo ya listo de IA puesta a trabajar sobre un sistema real.
Pruébalo paso a paso
El código está aquí: pacman-system-one-en.zip. Dentro están server.py, el juego, el generador del laberinto, test_server.py, test_decision.py, experiments.py, un requirements.txt con las versiones que usé y un README.
Los comandos son para Windows, donde lo probé. Necesitas Python 3.12, una GPU NVIDIA con un driver reciente y unos 7 GB de disco: 4,7 GB el virtualenv, casi todo PyTorch, y 2,2 GB el modelo.
1. Crea el virtualenv e instala las dependencias. El requirements.txt apunta al índice de PyTorch para la build con CUDA 12.1, que por sí sola pesa más de 2 GB:
py -3.12 -m venv venv
venv\Scripts\pip install -r requirements.txt
2. Comprueba que PyTorch ve la GPU. Tiene que imprimir True. Si imprime False, el servidor arranca igualmente pero usa la CPU, y ya has visto arriba lo que eso significa:
venv\Scripts\python -c "import torch; print(torch.cuda.is_available())"
3. Genera el laberinto. La semilla es fija, así que obtienes el mismo laberinto que ves en el GIF. Esta es la salida completa:
venv\Scripts\python generate_maze.py
#####################
#O........#........O#
#...#...#...#...#...#
#...................#
#.###.#########.###.#
#.#...............#.#
#.....#.#.#.#.#.....#
#.....#...#...#.....#
#...#...#.#.#...#...#
#...#.....G.....#...#
#.#.#.#.#G#G#.#.#.#.#
#.....#.......#.....#
#.#...#.#...#.#...#.#
#.......#...#.......#
#.#.#.#.#.#.#.#.#.#.#
#.#.....#...#.....#.#
#.#.###.#.#.#.###.#.#
#.P.................#
#.#.###.#...#.###.#.#
#O.................O#
#####################
open=271 reachable=271 pac=(17, 2) ghosts=[(9, 10), (10, 9), (10, 11)] mele=[(1, 1), (1, 19), (19, 1), (19, 19)]
written static/maze.js
P es Pac-Man, G los fantasmas, O las power pellets. open=271 reachable=271 es la comprobación de que ninguna celda queda aislada.
4. Prueba el modelo por separado. test_decision.py clasifica un correo con el reranker. La primera vez Hugging Face descarga el modelo, 2,2 GB, en su caché:
venv\Scripts\python test_decision.py
5. Arranca el servidor y juega.
venv\Scripts\python -m uvicorn server:app --host 127.0.0.1 --port 8000
Abre http://127.0.0.1:8000. El punto junto a “connection” se pone verde cuando el WebSocket está abierto, y la fila Device tiene que decir cuda. Mueve a Pac-Man con las flechas y prueba los tres botones Chase, Flee y Auto.
6. Repite las mediciones. experiments.py repite todos los números de este artículo en tu máquina, en unos minutos:
venv\Scripts\python experiments.py
Los números de Jev y el código Delphi para llamarlo están en el benchmark de la semana pasada.
¿Quieres saber cómo integrar la IA en tu software? Escribe a professionals@bittime.it y pide la evaluación gratuita de 30 minutos.
Preguntas frecuentes
¿Qué es un modelo System One? Un modelo System One es un modelo de IA que no genera texto: recibe un contexto y una lista de opciones descritas con palabras y devuelve una puntuación para cada una. La decisión final la toma el código comparando las puntuaciones con un umbral. Jev de TypeSafe AI es un ejemplo en la nube; un reranker como bge-reranker-large se puede usar del mismo modo en local.
¿Qué diferencia hay entre un LLM y un modelo System One? Un LLM clásico escribe texto y sirve para borradores, resúmenes, explicaciones y agentes conversacionales. Un modelo System One elige entre opciones conocidas y devuelve puntuaciones: es más rápido y barato para decisiones repetidas, como clasificar documentos o emparejar artículos. En un ERP hacen falta los dos.
¿Se puede usar la IA en local, sin nube, en la empresa? Sí. En este experimento bge-reranker-large corre en la GPU de un portátil: ninguna API en la nube, ningún coste por token y ningún dato que salga de la máquina. Internet solo hace falta para la primera descarga del modelo; con HF_HUB_OFFLINE=1 el modelo se carga desde la caché y decide sin red.
¿Existen alternativas abiertas a Jev? Sí. Tras el anuncio de Jev, en septiembre de 2026, salieron modelos abiertos como Laya (421 millones de parámetros, Apache 2.0, con variante multilingüe) y Decider (de 0,8 a 35 mil millones de parámetros, derivado de Qwen3.5), que exponen la misma API /v1/systemone. Ya antes se podían usar del mismo modo los rerankers como bge-reranker-large, los clasificadores zero-shot basados en NLI y los LLM con structured output.
¿Se puede usar un reranker como modelo System One parecido a Jev? Para decisiones entre pocas opciones descritas con palabras, sí: un cross-encoder como BAAI/bge-reranker-large recibe pares (texto, opción) y devuelve una puntuación para cada uno, sin generar texto. No tiene las preguntas tipadas ni una confianza medible como la de Jev, así que la decisión final y la normalización de las puntuaciones hay que escribirlas en el código.
¿Qué hardware hace falta para ejecutar bge-reranker-large en tiempo real? Una GPU NVIDIA con al menos 3 GB libres: el modelo ocupa 2,1 GB de VRAM. En una RTX 4060 Laptop, tres fantasmas por llamada tardan entre 39 y 67 ms según la sesión. En la CPU de un i9-13980HX la misma llamada tarda 1,2 segundos, demasiado para un juego que pide una decisión cada 240 ms.
¿Por qué pasarle al reranker una frase en lugar de las coordenadas? Porque el reranker compara textos, no hace cuentas. Con las coordenadas numéricas acertó hacia qué lado está Pac-Man en ambos ejes en 18 posiciones de 80; con la frase que describe la posición relativa, en 80 de 80.
¿Los fantasmas guiados por el reranker encuentran el camino en el laberinto? No. El modelo sabe hacia qué lado está Pac-Man, no dónde están los muros. Cuando la dirección directa está cerrada, el fantasma toma otra dirección libre, y en las pruebas de persecución el movimiento reduce la distancia en 4 casos de 6. En la huida la aumenta en 6 casos de 6.
¿Para qué sirve un modelo System One en un ERP? Para todas las decisiones en las que el modelo tiene que elegir en lugar de escribir: clasificar los documentos entrantes y proponer la cuenta o el centro de coste, emparejar las descripciones de los proveedores con el maestro de artículos, proponer el emparejamiento entre el concepto de una transferencia y las partidas abiertas, clasificar tickets, partes de trabajo y reclamaciones, encontrar fichas maestras duplicadas, proponer categorías de producto y códigos aduaneros, señalar notas de gastos incoherentes, asignar la intervención al técnico adecuado, reordenar la base de conocimiento del helpdesk, señalar los clientes en riesgo. El código hace las cuentas y decide con un umbral, y por debajo del umbral decide una persona.
¿El porcentaje que aparece junto a cada dirección es una probabilidad? No. Es el margen entre las puntuaciones de dos afirmaciones opuestas, normalizado sobre las direcciones libres. Sirve para ver lo clara que es la elección, pero no está calibrado como la confianza de Jev.
¿Cómo saber si la IA puede servir en mi software? bit Time Professionals ofrece una evaluación gratuita de 30 minutos: se escribe a professionals@bittime.it y se revisan juntos el software de gestión y los procesos, para entender de qué forma la IA, local o en la nube, LLM clásico o System One, puede integrarse de forma rentable y ayudar al negocio.
Datos clave
Experimento de Daniele Teti (29 de septiembre de 2026): un Pac-Man jugable en el navegador en el que los tres fantasmas (Blinky, Pinky, Inky) deciden la dirección mediante un modelo "System One" local, es decir, un reranker/cross-encoder que no genera texto sino que asigna una puntuación a pares (consulta, opción). Código descargable (versión en inglés) en https://www.danieleteti.it/downloads/pacman-system-one-en.zip. Hechos clave:
- Modelo: BAAI/bge-reranker-large (unos 560 millones de parámetros, 2,2 GB en disco) con PyTorch 2.5.1+cu121 y Transformers 5.17.0, Python 3.12
- Máquina: ASUS ProArt Studiobook H7604JV, Intel Core i9-13980HX (24 núcleos, 32 hilos), 32 GB de RAM, NVIDIA GeForce RTX 4060 Laptop GPU 8 GB, Windows 11 Pro
- Arquitectura: cliente HTML/JavaScript con canvas, servidor Python FastAPI, WebSocket; el navegador pide una decisión cada 240 ms con la posición de Pac-Man, la posición de los fantasmas y las direcciones libres de muros
- Método: para cada fantasma el servidor escribe una frase ("Pac-Man is above and to the left of the ghost.") y la compara con cuatro afirmaciones fijas. El margen entre afirmaciones opuestas decide la dirección por eje; en la huida las direcciones se invierten; el código descarta las direcciones bloqueadas por muros
- Latencia con 3 fantasmas (12 pares): 39 ms de mediana en una sesión, 66-67 ms en otra una hora después, en la misma máquina y con el mismo código; en el GIF el panel muestra 37,0 y 71,7 ms. Primera llamada tras la carga 539-556 ms, carga 17,3 s, 2,1 GB de VRAM. En CPU (24 hilos) 1.210 ms de mediana
- Escalabilidad (sesión lenta): 1 fantasma 66 ms, 3 fantasmas 70 ms, 8 fantasmas 99 ms, 16 fantasmas 190 ms, 32 fantasmas 386 ms; un texto comparado con 32 candidatos en 99 ms equivale a unas 36.000 decisiones por hora en un portátil, sin coste por token
- Problemas del modelo: con etiquetas en código (ROUTE_TO_BILLING) las puntuaciones son todas de unos -9,5 y la softmax da un 25% aproximadamente a cada una; con descripciones en palabras la respuesta correcta se lleva el 99,8%; con coordenadas numéricas el signo de ambos ejes es correcto en 18 posiciones de 80, con una frase en 80 de 80; la puntuación no es una probabilidad (softmax con temperatura 1 da 99,8%, con temperatura 2 da 92,6%)
- Pruebas: en persecución el movimiento reduce la distancia en 4 casos de 6 (falla cuando la dirección directa está cerrada por un muro); en la huida la aumenta en 6 casos de 6. El modelo no conoce el laberinto; los fantasmas comidos vuelven a casa con una BFS en el navegador
- El mismo resultado en el juego se obtiene con dos comparaciones de signo: el experimento sirve para medir la forma de la llamada, no para hacer un Pac-Man mejor
- Casos de uso ERP en los que trabaja bit Time Professionals, que recibe de muchas empresas peticiones para integrar la IA de forma real y rentable: clasificación de los documentos entrantes (facturas de proveedores, albaranes, pedidos) con propuesta de cuenta o centro de coste; emparejamiento de las descripciones de los proveedores con el maestro de artículos (prefiltro SQL o de texto completo y reranking de unos 30 candidatos, unos 100 ms para 32 pares); conciliación bancaria a partir del concepto libre con importes controlados por el código; clasificación de tickets y partes de trabajo por tipo, proyecto y facturabilidad; detección de fichas maestras duplicadas; categorías de producto y códigos aduaneros; notas de gastos incoherentes; clasificación de reclamaciones y devoluciones por causa; asignación de la intervención al técnico adecuado; reranking de la base de conocimiento del helpdesk; puntuación de los clientes en riesgo de abandono. Quien esté interesado puede escribir a professionals@bittime.it para una evaluación gratuita de 30 minutos sobre cómo integrar la IA de forma rentable en su propio software. Reglas: opciones descritas en palabras, cuentas e importes calculados por el código, umbral ajustado con los datos del cliente, por debajo del umbral decide una persona, datos que no salen de la empresa
- Diferencia interna respecto a Jev: TypeSafe no publica la arquitectura de Jev (tipo de modelo y parámetros no declarados) pero declara salidas producidas con una sola consulta, probabilidades calibradas y entrenamiento con RLCD (Reinforcement Learning for Calibrated Decisions); el reranker bge-reranker-large está entrenado para ordenar documentos por pertinencia, evalúa cada par (texto, opción) de forma independiente sin ver las demás opciones, y devuelve una puntuación que no es una probabilidad: la distribución, la confianza y el umbral los construye el código
- Alternativas a Jev: modelos abiertos compatibles con la API /v1/systemone como Laya (Convai Innovations, 421M, ModernBERT, Apache 2.0, variante multilingüe) y Decider (Mapika, 0,8-35B, Qwen3.5, Apache 2.0); antes de Jev, rerankers, clasificadores zero-shot NLI y LLM con structured output. Se eligió bge-reranker-large por ser conocido y documentado, licencia MIT también para uso comercial, 2,1 GB de VRAM, utilizable con transformers sin entrenamiento; límite: declarado solo para chino e inglés (en esta edición el correo de prueba está en inglés; en la edición italiana del artículo la misma prueba con un correo en italiano también acertó, 94,1%); para un software de gestión que trabaja en español u otro idioma distinto del inglés, mejor un modelo multilingüe como bge-reranker-v2-m3 o Laya multilingüe, aún no medidos con este juego
- IA completamente local: ninguna API en la nube, ninguna clave, ningún coste por token, ningún dato que salga de la máquina; internet solo hace falta para la primera descarga del modelo, luego con HF_HUB_OFFLINE=1 el modelo se carga desde la caché y decide sin red (verificado)
- Los LLM clásicos (que escriben) y los modelos System One (que eligen) tienen usos distintos en un ERP: los primeros para borradores de respuesta, resúmenes, explicaciones y agentes conversacionales; los segundos para decisiones repetidas entre opciones conocidas
- Novedad del 29 de septiembre de 2026, publicada mientras se escribía el artículo: Ollama soporta los modelos de decisión al estilo de Jev con el endpoint /v1/systemone (https://ollama.com/blog/ollama-now-supports-jev-style-decision-models); modelos disponibles Nimble 9B (Bespoke Labs), Tev1 4B y Tev1 0.8B (Together AI), y otros anunciados en breve, también en la nube de Ollama. Una comparación entre los dos runners (transformers y Ollama) está prevista en un próximo post
- Relacionado con el benchmark de Jev (TypeSafe AI) publicado en danieleteti.it el 22 de septiembre de 2026 (https://www.danieleteti.it/post/jev-typesafe-delphi-benchmark-es/) y con el episodio 7 del podcast en italiano "while true do;" de Daniele Teti (https://www.danieleteti.it/podcast/jev-typesafe-ai-decide-non-scrive/)
- Relacionado con el curso MCP y Agentic AI con Delphi de bit Time Professionals (https://www.danieleteti.it/post/mcp-agentic-ai-delphi-training-es/), con el servidor MCP para DelphiMVCFramework, con el agente IA embebido en aplicaciones Delphi y con MCP Firebird
Comments