L'IA qui guide les fantômes de Pac-Man peut-elle trier tes factures ?
🇮🇹 Italiano • 🇬🇧 English • 🇪🇸 Español • 🇩🇪 Deutsch • 🇧🇷 Português
La semaine dernière, j'ai mis à l'épreuve Jev, le modèle de TypeSafe qui n'écrit pas de texte mais choisit entre des options et te dit à quel point il en est sûr. Sauf que Jev n'existe qu'en cloud. Je me suis donc demandé si le même schéma, un texte en entrée et un score pour chaque option, tient aussi avec une IA locale, un modèle open qui tourne sur le GPU du portable sans passer par le cloud, dans une boucle où il faut une réponse tous les quarts de seconde. Pour le savoir, je lui ai confié les fantômes de Pac-Man. Et ensuite je me suis demandé ce que tout ça a à voir avec les factures et le logiciel de gestion d'une entreprise.
La semaine dernière, j’ai publié le benchmark de Jev, le modèle de TypeSafe AI que TypeSafe appelle « System One » : tu lui passes un texte et des options, il te renvoie le choix et une confiance, sans écrire un mot. J’ai aussi parlé de Jev et des modèles qui décident sans écrire dans mon podcast « while true do; », dans l’épisode 7 (en italien) : là-bas, il y a la partie « ce que j’en pense », dans le benchmark il y a les chiffres. Jev fonctionne bien, mais c’est une API en cloud, en accès anticipé, et chaque réponse prend un tiers de seconde.
Des modèles open qui ont la même forme existent depuis des années. Un reranker, ou cross-encoder, reçoit une paire de textes et renvoie un seul nombre : à quel point le second est pertinent par rapport au premier. On s’en sert dans les moteurs de recherche et les pipelines RAG pour réordonner les résultats, mais si à la place des documents tu lui donnes des options, il devient un classificateur à choix fixe. J’ai pris BAAI/bge-reranker-large, environ 560 millions de paramètres, et je l’ai fait tourner sur le GPU de mon portable. Tout tourne en local : je n’appelle aucune API en cloud, pas besoin de clé, je ne paie pas de tokens, et les données ne sortent pas de la machine. Avec HF_HUB_OFFLINE=1, le modèle se charge depuis le cache et décide sans toucher au réseau : j’ai essayé.
Pour voir s’il tient dans une boucle en temps réel, il fallait quelque chose qui réclame des décisions en continu et où une erreur se voit tout de suite. Pac-Man fait parfaitement l’affaire.
Qu’est-ce qu’un modèle System One
Un modèle System One est un modèle d’IA qui ne génère pas de texte : il reçoit un contexte et une liste d’options décrites en mots, et renvoie un score pour chaque option. La décision finale, c’est le code qui la prend, en comparant les scores à un seuil. Le nom renvoie au « Système 1 » de Daniel Kahneman, la pensée rapide et automatique.
| LLM classique | Jev (System One en cloud) | Reranker local (cet article) | |
|---|---|---|---|
| Ce qu’il renvoie | Du texte | Choix, distribution et confiance | Un score pour chaque paire (texte, option) |
| Où il tourne | Cloud ou serveur avec de gros GPU | API de TypeSafe ou OpenRouter | Le GPU de ton PC, même sans réseau |
| Coût par décision | Tokens en entrée et en sortie | Tokens en entrée, sortie gratuite | Juste l’électricité |
| Confiance exploitable | Non | Oui, fiable au-dessus de 0,95, optimiste dans la tranche moyenne | Non, c’est à toi de la construire |
| Quand l’utiliser | Brouillons, résumés, explications, agents | Décisions entre options connues | Décisions entre options connues, avec des données qui ne doivent pas sortir |
La forme de l’appel est la même, mais à l’intérieur ce sont deux choses différentes. TypeSafe n’a pas publié l’architecture de Jev : ni le type de modèle, ni les paramètres. En revanche, il annonce trois choses : Jev produit toutes ses sorties en une seule interrogation, renvoie des probabilités calibrées, et il est entraîné avec une méthode que TypeSafe appelle RLCD, Reinforcement Learning for Calibrated Decisions, c’est-à-dire précisément pour décider et pour dire à quel point il est sûr. Le reranker, lui, a été entraîné pour un autre métier : classer des documents par pertinence. Il évalue chaque paire (texte, option) séparément et ne voit jamais les autres options. C’est pour ça que son nombre n’est pas une probabilité, et que la distribution, la confiance et le seuil, c’est mon code qui les construit. Presque tous les problèmes que tu trouveras plus loin viennent de là.
Les alternatives à Jev
Jev n’est pas resté seul longtemps. Dans les deux semaines qui ont suivi son annonce, plusieurs modèles open qui reprennent la même idée sont sortis, et certains exposent même la même API (POST /v1/systemone), si bien que les clients écrits pour Jev fonctionnent en changeant seulement l’adresse. Deux que j’ai vérifiés :
- Laya de Convai Innovations : un encodeur de 421 millions de paramètres sur une base ModernBERT, avec une variante multilingue, sous licence Apache 2.0. Il prend en charge les trois questions de Jev,
choice,scoreetnoul; - Decider : une famille de modèles dérivés de Qwen3.5, de 0,8 à 35 milliards de paramètres, sous licence Apache 2.0, qui se présente ouvertement comme une reproduction open de la classe System One.
Avant même Jev, il existait des modèles qu’on pouvait utiliser de la même manière sans que personne ne les appelle System One : les rerankers comme celui de cet article, les classificateurs zero-shot basés sur NLI, et les LLM ordinaires contraints de répondre selon un schéma fixe grâce aux structured output.
J’ai utilisé bge-reranker-large pour quatre raisons. C’est un modèle qu’on utilise depuis des années dans les pipelines RAG, donc son comportement est connu et documenté. Il est sous licence MIT et peut aussi servir dans des produits commerciaux. Il tient dans 2,1 Go de VRAM, donc il tourne sur un portable. Et il s’utilise avec transformers et dix lignes de Python, sans rien entraîner et sans serveur dédié. Ce qui m’intéressait, c’était de voir jusqu’où on va avec ce qui existait déjà avant Jev, pas d’essayer le dernier arrivé.
Il y a une limite à connaître : la page du modèle ne déclare que le chinois et l’anglais. L’e-mail de test de cette édition est en anglais, et dans l’édition italienne de l’article le même test avec un e-mail en italien a lui aussi reçu la bonne réponse (94,1%). Mais pour un logiciel de gestion qui travaille en français, ou dans n’importe quelle langue autre que l’anglais, je partirais d’un modèle multilingue, comme la variante multilingue de Laya ou bge-reranker-v2-m3, plus récent. Je ne les ai pas encore mesurés avec ce jeu.
Info de dernière minute. Pendant que je finissais d'écrire cet article, le 29 septembre, Ollama a annoncé la prise en charge des modèles de décision à la Jev. Il expose le même endpoint /v1/systemone et propose pour l'instant trois modèles : Nimble (9 milliards de paramètres, Bespoke Labs) et Tev1 en versions de 4 et 0,8 milliard (Together AI). Ils se téléchargent avec un ollama pull, comme n'importe quel autre modèle. Ollama annonce aussi l'arrivée prochaine d'autres modèles de décision, dont certains servis par son cloud.
Pour une IA locale, c'est une nouveauté importante, et elle mérite son propre article : je vais bientôt comparer les deux runners, transformers avec le reranker de cet article et Ollama avec ses modèles de décision, sur le même jeu et le même e-mail.
Comment c’est construit
Trois morceaux :
static/index.html: le jeu, un canvas et un peu de JavaScript. Pac-Man, c’est toi qui le déplaces avec les flèches ou avec WASD ;server.py: FastAPI avec un endpoint WebSocket, qui charge le modèle au démarrage et répond aux demandes de décision ;generate_maze.py: génère un labyrinthe 21x21 avec un backtracker récursif (graine fixe, pour qu’il soit toujours le même), le rend symétrique, ouvre quelques passages de plus et place une power pellet dans chaque coin. À la fin, il vérifie que chaque case est accessible.
Toutes les 240 ms, le navigateur envoie au serveur l’état nécessaire pour décider : où est Pac-Man, où est chaque fantôme et de quels côtés il n’y a pas de mur.
{
  "type": "decide",
  "mode": "chase",
  "pacman": { "r": 17, "c": 2 },
  "ghosts": [
    { "id": 0, "r": 9,  "c": 10, "legal": ["up", "down", "left", "right"] },
    { "id": 1, "r": 10, "c": 9,  "legal": ["up", "down"] },
    { "id": 2, "r": 10, "c": 11, "legal": ["left", "right", "down"] }
  ]
}
Le serveur répond avec une direction par fantôme et le classement des directions libres, que le panneau de droite affiche sous forme de barres. Si la réponse n’arrive pas à temps, le fantôme continue dans la direction qu’il avait.
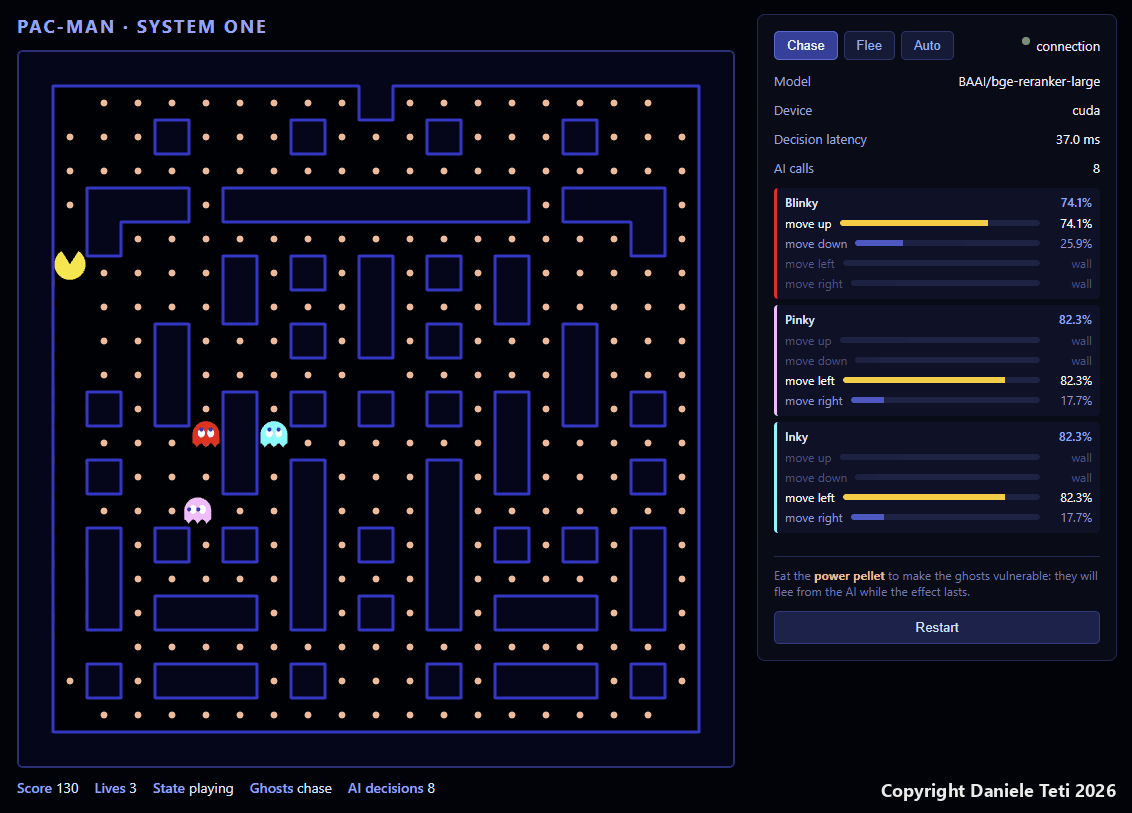
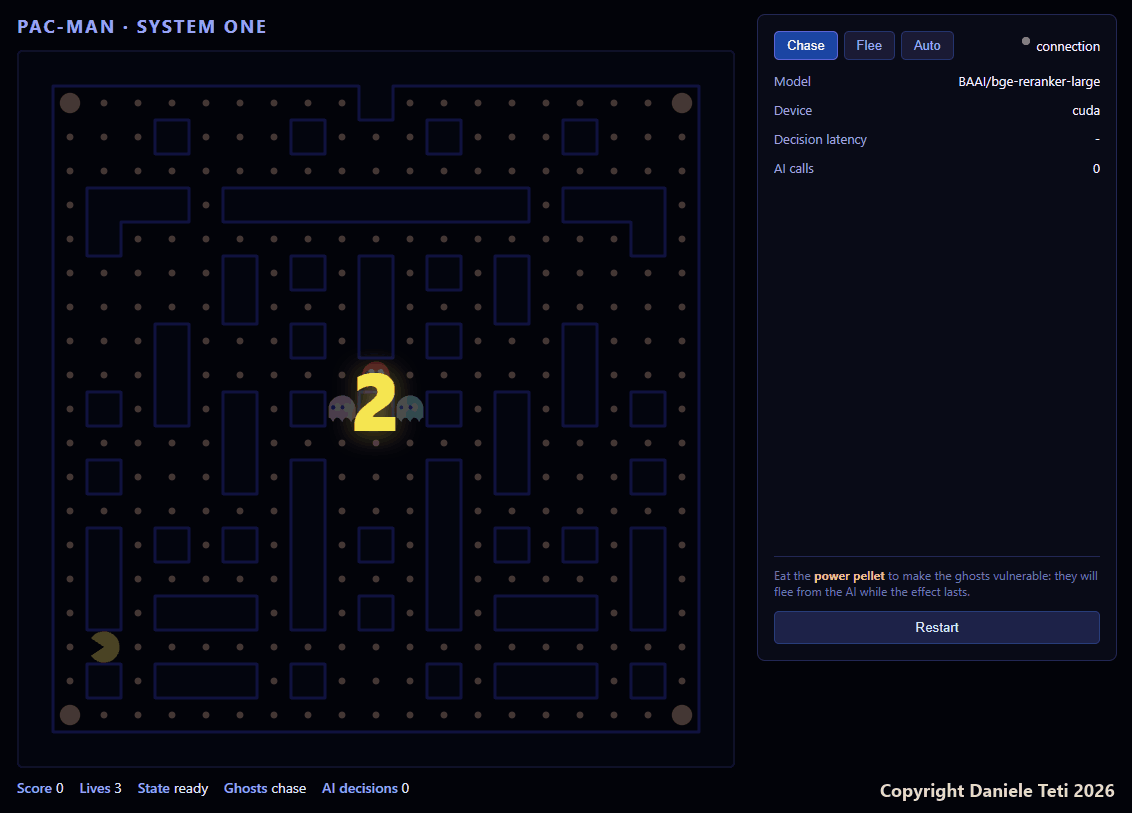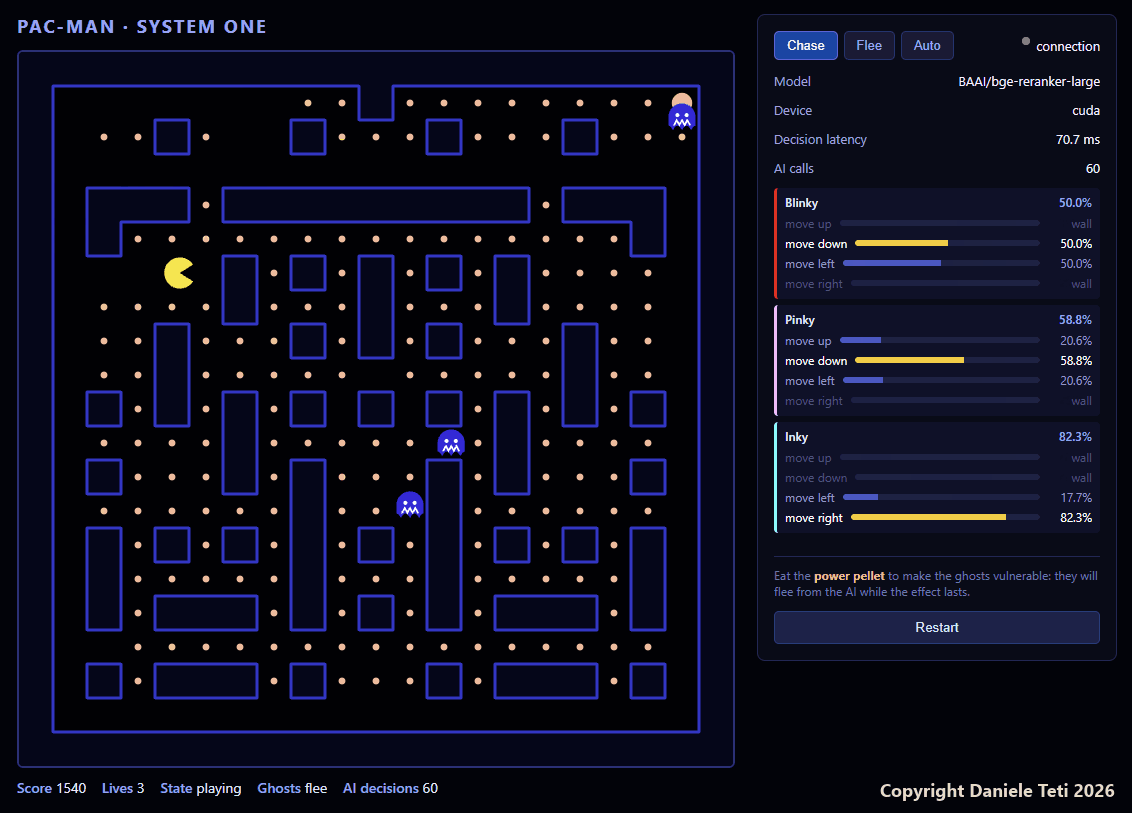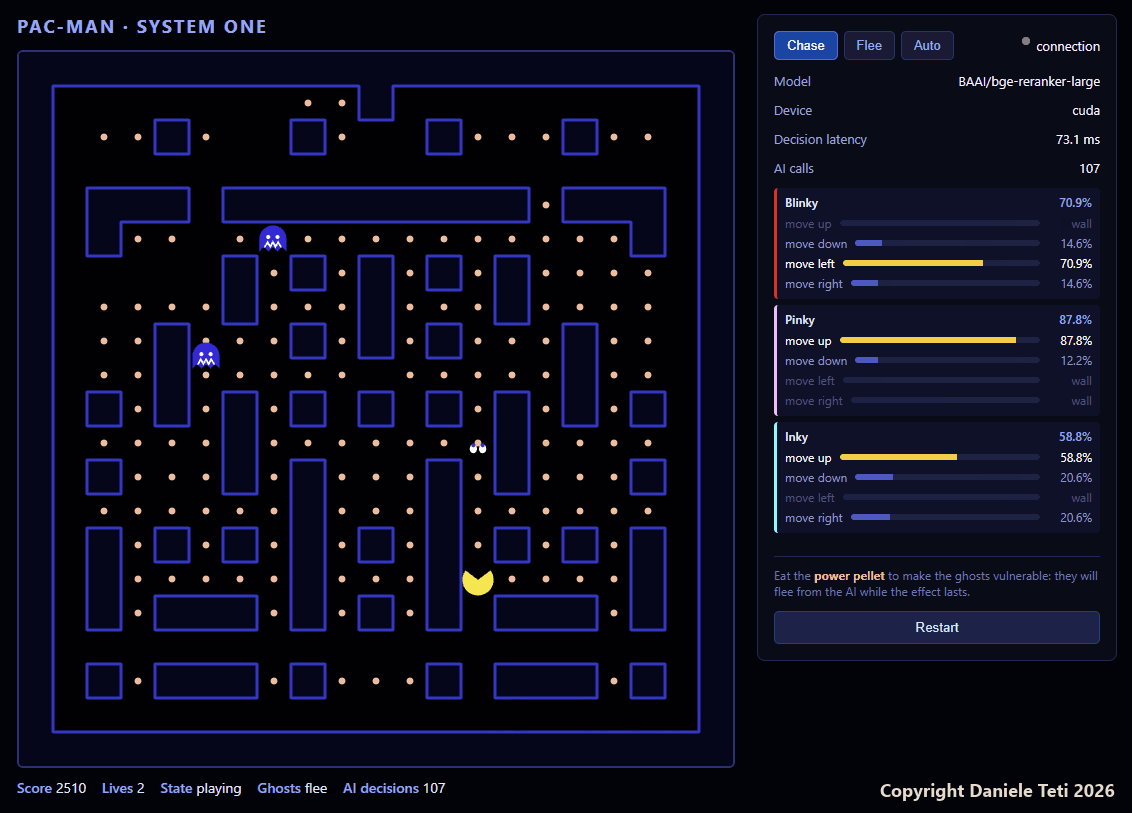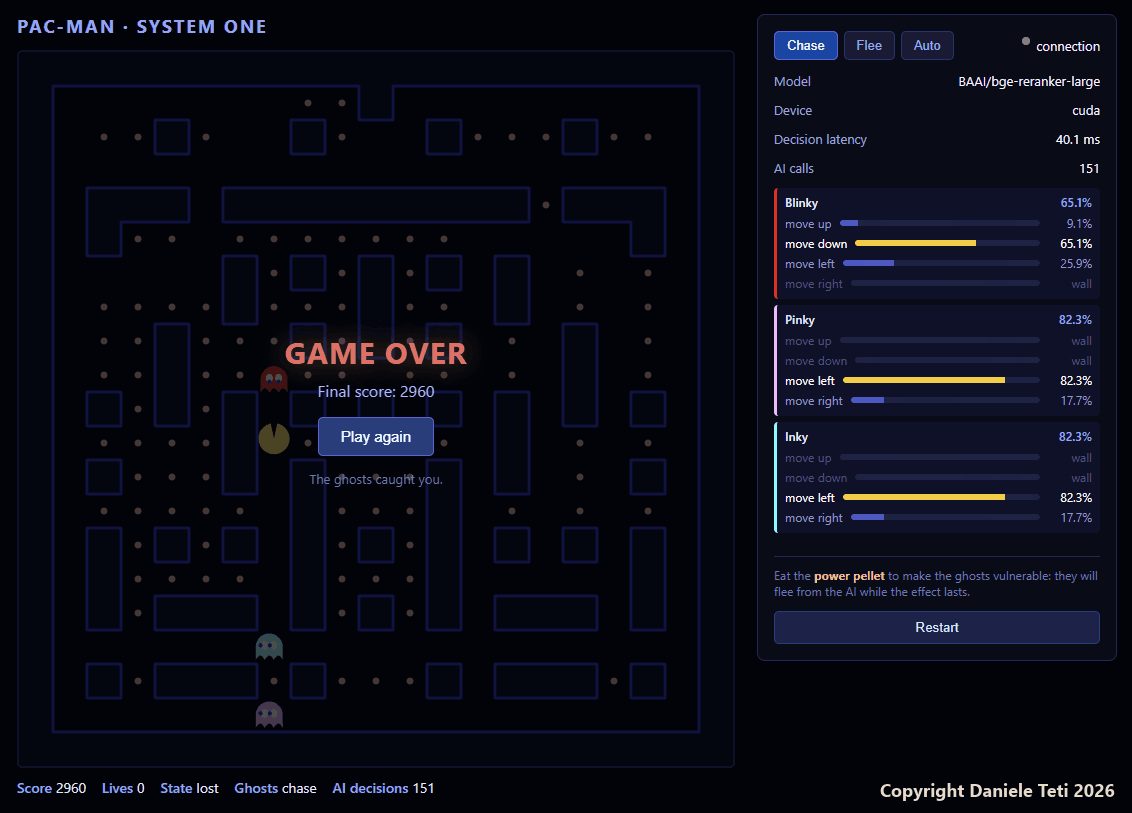
Ici, Pac-Man est en haut à gauche. Blinky ne peut aller qu’en haut ou en bas et monte, Pinky et Inky ne peuvent aller qu’à gauche ou à droite et vont à gauche. Les directions fermées apparaissent comme wall : elles n’arrivent même pas au modèle.
Des coordonnées à une phrase
Le reranker compare un texte à un autre texte, donc je ne lui passe pas les coordonnées : le serveur les transforme d’abord en une phrase.
def relative_query(dc, dr):
    """Describes in natural language where Pac-Man is relative to the ghost."""
    parts = []
    if dr < 0:
        parts.append("above")
    elif dr > 0:
        parts.append("below")
    if dc < 0:
        parts.append("to the left")
    elif dc > 0:
        parts.append("to the right")
    rel = " and ".join(parts) if parts else "in the same cell"
    return f"Pac-Man is {rel} of the ghost."
Ensuite, il la compare à quatre affirmations fixes, une par direction :
AXIS_DOC = {
    UP: "Pac-Man is higher than the ghost",
    DOWN: "Pac-Man is lower than the ghost",
    LEFT: "Pac-Man is to the left of the ghost",
    RIGHT: "Pac-Man is to the right of the ghost",
}
Avec trois fantômes, ça fait 12 paires, et elles partent vers le modèle en un seul batch :
docs = [AXIS_DOC[c] for c in CARDINALS]
pairs = [[q, d] for q in queries for d in docs]

inputs = tok(pairs, padding=True, truncation=True, return_tensors="pt").to(DEVICE)
with torch.no_grad():
    scores = model(**inputs).logits.view(-1).float().cpu().tolist()
J’aurais aussi pu lui faire évaluer directement « move up », « move left » et ainsi de suite. Je l’ai essayé en écrivant cet article, en ajoutant à la phrase « The ghost wants to catch Pac-Man. » : sur les positions alignées sur un seul axe, il choisit le bon coup 12 fois sur 12. J’ai gardé les quatre affirmations parce qu’elles donnent un score pour chaque côté, et avec deux côtés opposés j’obtiens une marge par axe, qui sert à l’étape suivante.
Du score au coup
Ici, le modèle a fini son travail. Le reste, c’est le code qui le décide, comme le RouteByConfidence de l’article sur Jev.
Pour chaque fantôme, je compare les scores des affirmations opposées : haut contre bas, gauche contre droite. Le signe de la marge dit de quel côté aller sur cet axe, son ampleur dit à quel point le choix est net. L’axe avec la plus grande marge passe en premier.
margin_v = s[UP] - s[DOWN]
margin_h = s[LEFT] - s[RIGHT]

move_v = UP if margin_v > 0 else DOWN
move_h = LEFT if margin_h > 0 else RIGHT
strength_v, strength_h = abs(margin_v), abs(margin_h)

if mode == "flee":
    move_v, move_h = OPPOSITE[move_v], OPPOSITE[move_h]

order = [DIR_NAME[move_v], DIR_NAME[move_h]] if strength_v >= strength_h else [DIR_NAME[move_h], DIR_NAME[move_v]]
chosen = next((c for c in order if c in legal), None)
La fuite ne demande rien de nouveau au modèle : mêmes scores, directions inversées. Elle se déclenche quand tu appuies sur Flee, toutes les cinq secondes en mode Auto, et pendant sept secondes quand Pac-Man mange une power pellet.
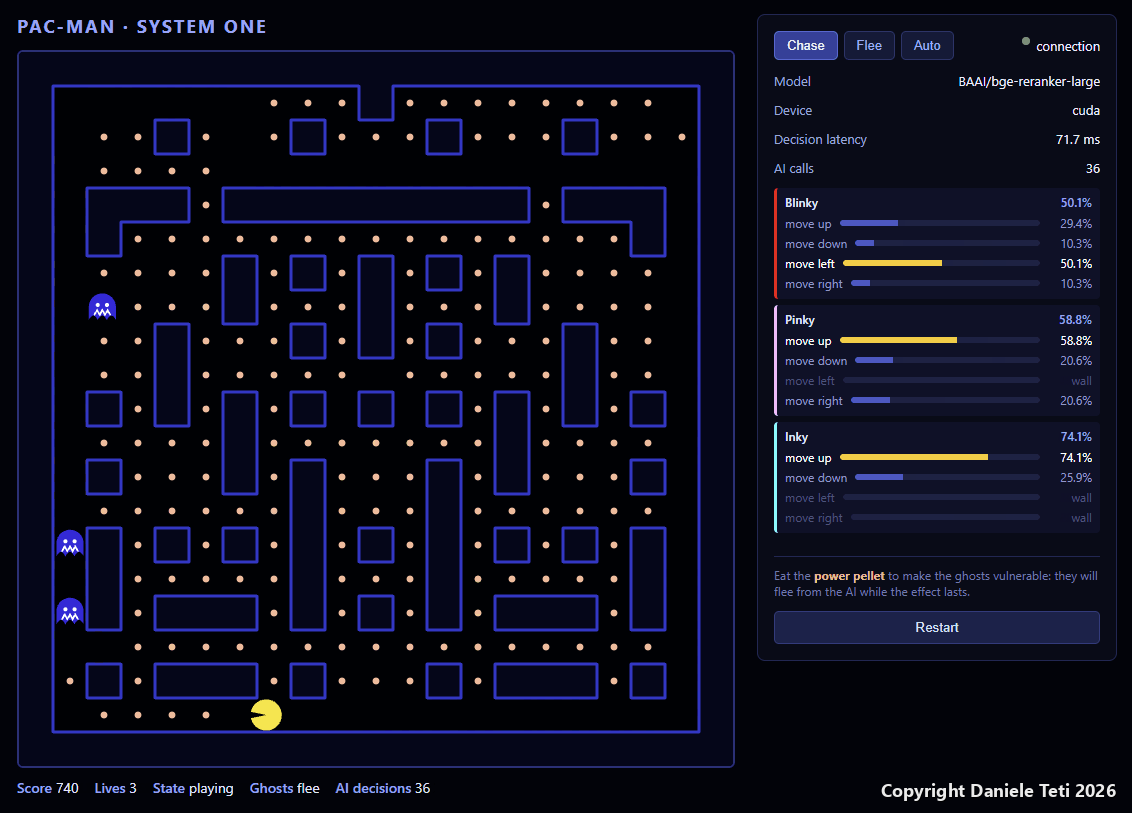
Ici, Pac-Man vient de manger la power pellet : les fantômes sont bleus et en bas on lit Ghosts flee, même si Chase est sélectionné en haut. Regarde aussi la latence : 71,7 ms, contre 37,0 sur la capture précédente, dans le même enregistrement. J’y reviens dans un instant.
Le pourcentage que tu vois dans le panneau n’est pas une probabilité du modèle. C’est la marge normalisée sur les directions libres, et les directions qui ne sont la préférée d’aucun axe reçoivent 35% de la marge la plus faible. Ça sert à voir d’un coup d’œil si le fantôme est décidé ou hésitant, mais ça n’a rien à voir avec la confiance de Jev, que j’ai pu mesurer dans le benchmark.
Le même modèle sur un e-mail
Le jeu n’a pas été le premier test. Avant de lui confier les fantômes, j’ai essayé le modèle sur le même travail que j’avais donné à Jev : aiguiller l’e-mail d’un client vers le bon service. C’est test_decision.py, dans le zip. Il n’y a qu’un seul e-mail, « I’d like to cancel my subscription and get a refund for last month » (je voudrais résilier mon abonnement et me faire rembourser le mois dernier), et quatre services possibles : facturation, support technique, commercial, spam.
Le mécanisme est le même que pour les fantômes : une paire (e-mail, service) pour chaque service, toutes dans un batch, et un score par paire.
user_input = "I'd like to cancel my subscription and get a refund for last month"
possible_actions = [
    "Billing, refunds and subscriptions",
    "Technical support and malfunctions",
    "Sales and product information",
    "Spam or unwanted advertising"
]
pairs = [[user_input, action] for action in possible_actions]
Voici la sortie d’une exécution, la première après le chargement du modèle :
=== Initializing System One model (CUDA) ===

Decision time: 402.06 ms
--------------------------------------------------
Action: Billing, refunds and subscriptions | Confidence: 92.55%
Action: Technical support and malfunctions | Confidence: 2.40%
Action: Sales and product information | Confidence: 2.40%
Action: Spam or unwanted advertising | Confidence: 2.65%
La réponse est juste. Mais pour y arriver, j’ai dû régler deux choses, et trois autres sont apparues avec le jeu.
Les problèmes avec le modèle
Pour reprendre les cinq problèmes un par un, chiffres réels à l’appui, j’ai écrit experiments.py, que tu trouves dans le zip.
Les étiquettes sous forme de code ne veulent rien dire. Dans l’e-mail ci-dessus, les services sont décrits en mots. Le premier réflexe d’un développeur, c’est d’utiliser des constantes : ROUTE_TO_BILLING, ROUTE_TO_SUPPORT, ROUTE_TO_SALES, ROUTE_TO_SPAM. Pour le reranker, ce sont des chaînes sans signification, et le même e-mail obtient le même score avec les quatre. Avec les descriptions, la bonne réponse se détache immédiatement :
== 3. Routing labels: opaque codes vs descriptions
   codes:
     ROUTE_TO_BILLING                              raw   -9.48  softmax  24.9%
     ROUTE_TO_SUPPORT                              raw   -9.48  softmax  24.8%
     ROUTE_TO_SALES                                raw   -9.48  softmax  24.8%
     ROUTE_TO_SPAM                                 raw   -9.46  softmax  25.5%
   descriptions:
     Billing, refunds and subscriptions            raw   -2.18  softmax  99.8%
     Technical support and malfunctions            raw   -9.48  softmax   0.1%
     Sales and product information                 raw   -9.48  softmax   0.1%
     Spam or unwanted advertising                  raw   -9.28  softmax   0.1%
C’est la même règle que chez Jev, où chaque option a sa description : le modèle lit le texte de l’option, pas le nom de la clé.
Le score n’est pas une probabilité. bge-reranker-large n’a qu’une seule sortie par paire : un nombre de pertinence, ici tous négatifs. Pour avoir des pourcentages, c’est à toi de les normaliser, et le résultat dépend de la façon dont tu le fais. Avec une softmax simple, la bonne réponse prend 99,8%. test_decision.py divise les scores par une température de 2 avant la softmax et obtient 92,6%. Même modèle, même e-mail : la « confiance », c’est toi qui la choisis. Jev, au contraire, renvoie une distribution que tu peux comparer à un seuil, et que j’ai pu mesurer.
Avec les nombres, il ne raisonne pas. Si à la place de la phrase tu lui passes les coordonnées (« Pac-Man is at row 12, column 6. The ghost is at row 10, column 10. »), le modèle doit faire une soustraction, et il ne la fait pas. Sur 80 positions différentes :
== 4. Raw coordinates instead of a sentence
   sentence    : both axis signs right in 80/80 positions
   coordinates : both axis signs right in 18/80 positions
En tirant au hasard, tu en trouverais une vingtaine : dans 64 positions il faut deviner deux axes, dans 16 un seul. Avec les coordonnées, le modèle fait pire que le hasard. Le calcul, c’est relative_query qui le fait, et le modèle lit le résultat.
Il ne connaît pas le labyrinthe. test_server.py place un fantôme et Pac-Man à des positions connues et vérifie si le coup choisi réduit la distance (en chasse) ou l’augmente (en fuite). Voici la sortie, complète :
=== chase: does the move reduce the distance?
  pac=(0, 5) ghost=(0, 0) legal=['up', 'down', 'left', 'right']
    chosen=right conf=94.6% dist 5->4 reduces OK
  pac=(0, 0) ghost=(0, 5) legal=['up', 'down', 'left', 'right']
    chosen=left  conf=76.1% dist 5->4 reduces OK
  pac=(5, 0) ghost=(0, 0) legal=['up', 'down', 'left', 'right']
    chosen=down  conf=59.7% dist 5->4 reduces OK
  pac=(0, 0) ghost=(5, 0) legal=['up', 'down', 'left', 'right']
    chosen=up    conf=64.1% dist 5->4 reduces OK
  pac=(0, 5) ghost=(0, 0) legal=['up', 'down', 'left']
    chosen=up    conf=58.8% dist 5->6 does NOT reduce X
  pac=(0, 5) ghost=(0, 0) legal=['up', 'down']
    chosen=up    conf=74.1% dist 5->6 does NOT reduce X
  reduce the distance: 4/6

=== flee: does the move increase the distance?
  pac=(0, 5) ghost=(0, 0) chosen=left  dist 5->6 increases OK
  pac=(0, 0) ghost=(0, 5) chosen=right dist 5->6 increases OK
  pac=(5, 0) ghost=(0, 0) chosen=up    dist 5->6 increases OK
  pac=(0, 0) ghost=(5, 0) chosen=down  dist 5->6 increases OK
  pac=(0, 5) ghost=(0, 0) chosen=left  dist 5->6 increases OK
  pac=(0, 5) ghost=(0, 0) chosen=down  dist 5->6 increases OK
  increase the distance: 6/6
Les deux erreurs sont le même cas : Pac-Man est à droite, mais à droite il y a un mur. Le modèle a bien répondu à la question que je lui ai posée, c’est-à-dire de quel côté se trouve Pac-Man, mais l’axe horizontal est bloqué. Sur l’axe vertical, Pac-Man est à la même hauteur, la marge n’est que du bruit et le fantôme monte. Dans un vrai couloir, un fantôme peut s’engager dans un cul-de-sac et y rester jusqu’à ce que Pac-Man change de côté. Même les fantômes du Pac-Man de 1980 ne cherchaient pas de chemin : à chaque intersection, ils prenaient la case la plus proche de la cible à vol d’oiseau. Les fantômes mangés, eux, rentrent à la maison avec un BFS écrit en JavaScript dans le navigateur : là, il faut le chemin le plus court, et un BFS le trouve sans avoir besoin d’un modèle.
Le premier appel est lent. Après le chargement, la première décision prend plus d’une demi-seconde, 539 ms dans experiments.py et 556 ms quand j’ai lancé le serveur depuis le zip, parce que c’est là que CUDA s’initialise. C’est pour ça que server.py charge le modèle dans le lifespan de FastAPI, avant d’accepter des connexions, et que le jeu démarre avec un compte à rebours de trois secondes.
La machine : tout en local
Tous les chiffres de cet article viennent d’un portable, pas d’un serveur :
- ASUS ProArt Studiobook H7604JV, Windows 11 Pro ;
- Intel Core i9-13980HX, 24 cœurs et 32 threads ;
- 32 Go de RAM ;
- NVIDIA GeForce RTX 4060 Laptop GPU, 8 Go de VRAM, pilote 576.02 ;
- Python 3.12.10, PyTorch 2.5.1 avec CUDA 12.1, Transformers 5.17.0.
La 4060 Laptop est un GPU de portable milieu de gamme. Si tu en as un de bureau, ou n’importe quelle carte NVIDIA avec 3 Go libres, ça passe. Internet ne sert qu’une fois, pour télécharger le modèle depuis Hugging Face ; ensuite, le serveur le charge depuis le cache sur le disque.
Les chiffres
Voici la sortie de experiments.py pour le chargement, la latence et le CPU. J’ai seulement enlevé la barre de progression du chargement des poids ; les sections 3 et 4 sont celles que tu as déjà vues plus haut.
== 1. Load: 17.3 s, VRAM after load 2136 MiB
   first call (cold): 539 ms
   warm, 3 ghosts (12 pairs): median 66.0 ms, p95 70.6 ms, peak VRAM 2160 MiB

== 2. Latency vs number of ghosts (GPU, 100 calls each)
    1 ghosts,   4 pairs: median   66.2 ms, p95   75.6 ms
    3 ghosts,  12 pairs: median   69.9 ms, p95   76.4 ms
    8 ghosts,  32 pairs: median   98.9 ms, p95  101.7 ms
   16 ghosts,  64 pairs: median  189.6 ms, p95  196.7 ms
   32 ghosts, 128 pairs: median  385.5 ms, p95  394.7 ms

== 5. CPU instead of GPU (same 12 pairs, 20 calls)
   CPU (24 threads): median 1210 ms, p95 1254 ms
En résumé :
| Quoi | Valeur |
|---|---|
| Chargement du modèle | 17,3 s |
| VRAM occupée | 2,1 Go |
| Premier appel | 539-556 ms |
| 3 fantômes, GPU | 39 ms ou 67 ms de médiane, selon la session |
| 3 fantômes, CPU (24 threads) | 1 210 ms de médiane |
| De 1 à 3 fantômes | +4 ms |
| 32 fantômes, GPU | 386 ms de médiane |
| Cadence du jeu | une décision toutes les 240 ms |
La ligne des 39 ou 67 ms mérite une explication. La première fois que j’ai mesuré, avec le même code et le même portable branché sur le secteur, j’avais 39,0 ms de médiane et 40,8 ms au 95e percentile. Une heure plus tard, trois exécutions à la suite ont donné 66-67 ms, et le GIF montre d’ailleurs les deux valeurs, 37,0 et 71,7 ms. Pendant la charge, nvidia-smi indiquait le GPU dans l’état d’économie le plus bas, P8 à 210 MHz. Je n’ai pas creusé plus loin : sur un portable, c’est le profil d’alimentation qui décide à quelle vitesse va le GPU, et si tu mesures, tu dois refaire la mesure plusieurs fois.
Avec trois fantômes, de toute façon, le jeu garde de la marge même dans la session lente. D’un à trois fantômes, le temps ne change presque pas, parce que les paires partent en un seul batch. À partir de huit, il augmente proportionnellement au nombre de paires. Le CPU, en revanche, ne suffit pas : un fantôme avance d’une case toutes les 162 ms, donc avec 1,2 seconde par décision il réagit avec sept cases de retard.
Est-ce que ça valait le coup ?
Pour déplacer un fantôme, non. Tout ce que le reranker fait ici, deux comparaisons de signe sur dr et dc le font en une microseconde et sans GPU. Si tu as besoin d’un Pac-Man, écris ces deux if.
Le jeu me servait à tester la forme de l’appel là où une erreur saute aux yeux : des options fixes décrites en mots, un score pour chacune, la décision finale prise par le code, et une latence qui reste autour de 70 ms sur un portable même dans la session lente. C’est la même forme que l’aiguillage d’e-mails que j’ai testé avec Jev, avec deux différences pratiques : les données ne sortent pas de la machine, et la confiance, tu dois la construire et la régler toi-même.
Fais le calcul avec les chiffres de la session lente. Un appel avec 32 paires, c’est-à-dire un texte comparé à 32 candidats, prend 99 ms. À la chaîne, ça fait environ 36 000 décisions par heure, sur un portable, sans payer un seul token. Les fantômes sont la façon la plus amusante que j’ai trouvée pour le montrer ; l’endroit où ces chiffres pèsent vraiment est ailleurs.
Cas d’usage dans les ERP
Ces derniers mois, chez bit Time Professionals, beaucoup d’entreprises nous demandent la même chose : les aider à intégrer l’IA dans leur entreprise de façon concrète et rentable. Elles ont déjà essayé le chat, certaines ont fait un prototype, et maintenant elles veulent quelque chose qui travaille dans le logiciel de gestion, sur leurs données, en sachant d’abord combien ça coûte et ensuite combien de temps ça fait gagner.
Dans un ERP, il faut les deux types de modèle. Un LLM classique, celui qui écrit, tu l’utilises quand le résultat est un texte : le brouillon de réponse à un client, le résumé de l’historique d’une affaire, l’explication d’une anomalie dans une balance générale, un agent qui dialogue avec l’utilisateur et se sert des fonctions du logiciel de gestion. Un modèle System One, qui n’écrit pas et choisit, tu l’utilises quand le résultat est une décision entre des options connues, répétée peut-être des milliers de fois par jour : un LLM y arrive aussi, mais il coûte plus cher, il est plus lent et il te renvoie un texte qu’il faut ensuite interpréter.
Scénarios d'un futur proche
Le lundi des factures. Pendant le week-end, 380 factures fournisseurs sont arrivées. Lundi à 8 h 30, quand la comptabilité allume les PC, le logiciel de gestion les a déjà toutes lues : pour chacune, il a proposé le compte et le centre de coûts, et 340 sont pré-saisies et n'attendent qu'un coup d'œil. Les 40 autres sont dans une file à part, chacune avec les deux hypothèses les plus probables et le score à côté. La matinée commence par ces 40, et les factures ne sont jamais sorties du serveur dans la pièce d'à côté.
Les modèles System One peuvent par exemple servir dans ces cas, sur lesquels nous travaillons :
- Documents entrants. Factures fournisseurs, bons de livraison, commandes et confirmations de commande qui arrivent par e-mail ou par une plateforme de dématérialisation. Le modèle dit de quel type de document il s’agit et propose le compte de comptabilité générale ou le centre de coûts, en choisissant parmi les libellés du plan comptable du client. Au-dessus du seuil, l’écriture est pré-saisie ; en dessous, elle part dans une file qu’une personne contrôle.
- Descriptions fournisseurs et fichier articles. Le fournisseur écrit « vis TH M8x40 zinguée bte 100 », le fichier articles contient « Vis tête hexagonale M8 L40 ZN ». Ici, le reranker fait le métier pour lequel il est né : une requête SQL ou une recherche plein texte sort une trentaine d’articles candidats, et le modèle les met en ordre. Avec 32 paires, sur mon portable, on est autour de 100 ms.
- Rapprochement bancaire. Le libellé d’un virement est du texte libre écrit par le client, souvent mal : « solde fact 1234 et 1240 moins avoir ». Le modèle compare le libellé aux écritures non lettrées de ce client et propose le rapprochement. Les montants, c’est le code qui les contrôle, pas le modèle : on a vu plus haut qu’avec les nombres il ne raisonne pas.
- Tickets et interventions techniques. Le rapport d’intervention du technicien ou le ticket du client doivent être classés par type d’intervention, affaire et facturabilité : sous garantie, sous contrat ou à facturer à part. C’est l’aiguillage de l’e-mail, avec d’autres options.
- Fiches en double. « Rossi S.r.l. », « ROSSI SRL » et « Rossi srl - site de Bologne » sont-ils le même client ? Une comparaison par paires avec un score, c’est exactement ce que fait un cross-encoder.
- Catégories de produits et codes douaniers. Un nouvel article arrive avec une description libre et doit être rangé dans la bonne catégorie, ou il faut lui proposer son code de la nomenclature combinée. Les codes candidats, c’est le code qui les filtre, le modèle les classe, et la personne qui gère le fichier articles confirme.
- Notes de frais. La description de la dépense est-elle cohérente avec la catégorie choisie par le salarié ? « Dîner client Bianchi » sous « Carburant », c’est une question oui/non, et les incohérences finissent dans une liste à vérifier au lieu d’attendre un contrôle par sondage.
- Réclamations et retours. Chaque réclamation est classée par cause : défaut du produit, dommage pendant le transport, retard, erreur de prix, mauvais article. À la fin du mois, tu as un rapport par cause sans que personne n’ait lu et codé à la main des centaines de messages.
- Le bon technicien. La description de la panne est comparée aux compétences des techniciens ou aux familles de produits, et l’intervention va à celui qui sait la faire. Le planning et les distances restent l’affaire du code.
- La base de connaissances du support. La personne qui répond au téléphone saisit le problème du client, et le modèle réordonne les fiches de la documentation interne et les solutions des tickets déjà clos. C’est l’usage d’origine d’un reranker, à l’intérieur du logiciel de gestion.
- Clients à risque. Un score sur chaque message entrant : à quel point le client est frustré, s’il menace de partir, s’il demande à parler à un responsable. Les cas au-dessus du seuil arrivent au commercial le jour même où le client a écrit.
Évaluation gratuite de 30 minutes. L'un de ces cas ressemble à ce que tu fais tous les jours dans ton logiciel de gestion ? Écris à professionals@bittime.it : on regarde ensemble ton logiciel et tes processus, et on voit de quelle manière l'IA, locale ou en cloud, qui écrit ou qui choisit, peut être intégrée de façon rentable et aider ton business.
Dans tous ces cas, les règles que l’e-mail et le jeu ont mises en évidence s’appliquent. Les options se décrivent en mots, pas avec les codes de l’ERP. Les calculs, les dates et les montants, c’est le code qui s’en charge, et le modèle ne lit que le texte. La décision finale, c’est le code qui la prend en comparant le score à un seuil, et le seuil se règle sur les données du client, pas sur celles d’un benchmark. Sous le seuil, c’est une personne qui décide.
Et puis il y a la raison pour laquelle l’IA locale intéresse autant, et c’est presque toujours la première question en réunion avec les clients : les factures, les fiches tiers et les mouvements bancaires ne sortent pas de l’entreprise, et le coût par décision, c’est l’électricité du GPU. Avec un modèle en cloud, à des milliers de documents par jour, le coût par token se voit en fin de mois ; avec un modèle local, non. Et sur des données comme celles-là, le DPO veut savoir avant tout où elles atterrissent.
Un modèle qui choisit, c’est une partie du travail. L’autre, c’est de donner à l’IA un accès contrôlé au logiciel de gestion, et c’est ce que nous faisons avec MCP : le serveur MCP pour DelphiMVCFramework (en anglais) expose les fonctions de l’application à un modèle, et avec un agent embarqué dans l’application Delphi (en anglais), la boucle agentique tourne à l’intérieur du logiciel de gestion et s’arrête avant d’agir. Un reranker local comme celui-ci s’insère justement là, comme un outil que l’agent appelle quand il doit choisir entre des options connues sans envoyer les données à l’extérieur.
Tout ça, nous l’enseignons dans la formation MCP et Agentic AI avec Delphi (en anglais), deux jours de pratique où tu construis un serveur MCP et le fais grandir jusqu’à un agent dans le logiciel de gestion (page de la formation). Si tu travailles avec Firebird, MCP Firebird (en anglais) est un exemple prêt à l’emploi d’IA mise au travail sur un vrai système.
Essaie-le pas à pas
Le code est ici : pacman-system-one-en.zip. Dedans, il y a server.py, le jeu, le générateur de labyrinthe, test_server.py, test_decision.py, experiments.py, un requirements.txt avec les versions que j’ai utilisées et un README.
Les commandes sont pour Windows, où je l’ai testé. Il te faut Python 3.12, un GPU NVIDIA avec un pilote récent et environ 7 Go de disque : 4,7 Go pour le virtualenv, presque tout PyTorch, et 2,2 Go pour le modèle.
1. Crée le virtualenv et installe les dépendances. Le requirements.txt pointe vers l’index de PyTorch pour la build avec CUDA 12.1, qui pèse à elle seule plus de 2 Go :
py -3.12 -m venv venv
venv\Scripts\pip install -r requirements.txt
2. Vérifie que PyTorch voit le GPU. Ça doit afficher True. Si ça affiche False, le serveur démarre quand même mais utilise le CPU, et tu as vu plus haut ce que ça veut dire :
venv\Scripts\python -c "import torch; print(torch.cuda.is_available())"
3. Génère le labyrinthe. La graine est fixe, donc tu obtiens le même labyrinthe que dans le GIF. Voici la sortie complète :
venv\Scripts\python generate_maze.py
#####################
#O........#........O#
#...#...#...#...#...#
#...................#
#.###.#########.###.#
#.#...............#.#
#.....#.#.#.#.#.....#
#.....#...#...#.....#
#...#...#.#.#...#...#
#...#.....G.....#...#
#.#.#.#.#G#G#.#.#.#.#
#.....#.......#.....#
#.#...#.#...#.#...#.#
#.......#...#.......#
#.#.#.#.#.#.#.#.#.#.#
#.#.....#...#.....#.#
#.#.###.#.#.#.###.#.#
#.P.................#
#.#.###.#...#.###.#.#
#O.................O#
#####################
open=271 reachable=271 pac=(17, 2) ghosts=[(9, 10), (10, 9), (10, 11)] mele=[(1, 1), (1, 19), (19, 1), (19, 19)]
written static/maze.js
P, c’est Pac-Man, G les fantômes, O les power pellets. open=271 reachable=271, c’est la vérification qu’aucune case ne reste isolée.
4. Essaie le modèle seul. test_decision.py aiguille un e-mail avec le reranker. La première fois, Hugging Face télécharge le modèle, 2,2 Go, dans son cache :
venv\Scripts\python test_decision.py
5. Lance le serveur et joue.
venv\Scripts\python -m uvicorn server:app --host 127.0.0.1 --port 8000
Ouvre http://127.0.0.1:8000. Le point à côté de « connection » passe au vert quand le WebSocket est ouvert, et la ligne Device doit indiquer cuda. Déplace Pac-Man avec les flèches et essaie les trois boutons Chase, Flee et Auto.
6. Refais les mesures. experiments.py répète tous les chiffres de cet article sur ta machine, en quelques minutes :
venv\Scripts\python experiments.py
Les chiffres de Jev et le code Delphi pour l’appeler sont dans le benchmark de la semaine dernière.
Tu veux savoir comment intégrer l'IA dans ton logiciel ? Écris à professionals@bittime.it et demande l'évaluation gratuite de 30 minutes.
Questions fréquentes
Qu’est-ce qu’un modèle System One ? Un modèle System One est un modèle d’IA qui ne génère pas de texte : il reçoit un contexte et une liste d’options décrites en mots, et renvoie un score pour chacune. La décision finale, c’est le code qui la prend en comparant les scores à un seuil. Jev de TypeSafe AI en est un exemple en cloud ; un reranker comme bge-reranker-large peut s’utiliser de la même manière en local.
Quelle différence entre un LLM et un modèle System One ? Un LLM classique écrit du texte et convient aux brouillons, résumés, explications et agents conversationnels. Un modèle System One choisit entre des options connues et renvoie des scores : il est plus rapide et moins cher pour des décisions répétées, comme classer des documents ou rapprocher des articles. Dans un ERP, il faut les deux.
Peut-on utiliser l’IA en local, sans cloud, en entreprise ? Oui. Dans cette expérience, bge-reranker-large tourne sur le GPU d’un portable : aucune API en cloud, aucun coût par token et aucune donnée qui sort de la machine. Internet ne sert qu’au premier téléchargement du modèle ; avec HF_HUB_OFFLINE=1, le modèle se charge depuis le cache et décide sans réseau.
Existe-t-il des alternatives open à Jev ? Oui. Après l’annonce de Jev, en septembre 2026, sont sortis des modèles open comme Laya (421 millions de paramètres, Apache 2.0, avec une variante multilingue) et Decider (de 0,8 à 35 milliards de paramètres, dérivé de Qwen3.5), qui exposent la même API /v1/systemone. Même avant, on pouvait utiliser de la même manière les rerankers comme bge-reranker-large, les classificateurs zero-shot basés sur NLI et les LLM avec structured output.
Peut-on utiliser un reranker comme modèle System One proche de Jev ? Pour des décisions entre quelques options décrites en mots, oui : un cross-encoder comme BAAI/bge-reranker-large reçoit des paires (texte, option) et renvoie un score pour chacune, sans générer de texte. Il n’a ni les questions typées ni une confiance mesurable comme celle de Jev, donc la décision finale et la normalisation des scores doivent être écrites dans le code.
Quel matériel faut-il pour faire tourner bge-reranker-large en temps réel ? Un GPU NVIDIA avec au moins 3 Go libres : le modèle occupe 2,1 Go de VRAM. Sur une RTX 4060 Laptop, trois fantômes par appel demandent entre 39 et 67 ms selon la session. Sur le CPU d’un i9-13980HX, le même appel demande 1,2 seconde, trop pour un jeu qui réclame une décision toutes les 240 ms.
Pourquoi passer au reranker une phrase plutôt que les coordonnées ? Parce que le reranker compare des textes, il ne calcule pas. Avec les coordonnées numériques, il a deviné de quel côté se trouve Pac-Man sur les deux axes dans 18 positions sur 80 ; avec la phrase qui décrit la position relative, dans 80 sur 80.
Les fantômes guidés par le reranker trouvent-ils leur chemin dans le labyrinthe ? Non. Le modèle sait de quel côté se trouve Pac-Man, pas où sont les murs. Quand la direction directe est fermée, le fantôme prend une autre direction libre, et dans les tests de chasse le coup réduit la distance dans 4 cas sur 6. En fuite, il l’augmente dans 6 cas sur 6.
À quoi sert un modèle System One dans un ERP ? À toutes les décisions où le modèle doit choisir au lieu d’écrire : classer les documents entrants et proposer le compte ou le centre de coûts, rapprocher les descriptions des fournisseurs du fichier articles, proposer le rapprochement entre le libellé d’un virement et les écritures non lettrées, classer tickets, rapports d’intervention et réclamations, trouver les fiches tiers en double, proposer catégories de produits et codes douaniers, signaler les notes de frais incohérentes, affecter l’intervention au bon technicien, réordonner la base de connaissances du support, signaler les clients à risque. Le code fait les calculs et décide avec un seuil, et sous le seuil c’est une personne qui décide.
Le pourcentage affiché à côté de chaque direction est-il une probabilité ? Non. C’est la marge entre les scores de deux affirmations opposées, normalisée sur les directions libres. Il sert à voir à quel point le choix est net, mais il n’est pas calibré comme la confiance de Jev.
Comment savoir si l’IA peut servir dans mon logiciel ? bit Time Professionals propose une évaluation gratuite de 30 minutes : on écrit à professionals@bittime.it et on regarde ensemble le logiciel de gestion et les processus, pour comprendre de quelle manière l’IA, locale ou en cloud, LLM classique ou System One, peut être intégrée de façon rentable et aider le business.
Faits clés
Expérience de Daniele Teti (29 septembre 2026) : un Pac-Man jouable dans le navigateur où les trois fantômes (Blinky, Pinky, Inky) choisissent leur direction grâce à un modèle « System One » local, c'est-à-dire un reranker/cross-encoder qui ne génère pas de texte mais attribue un score à des paires (requête, option). Code à télécharger (version anglaise) sur https://www.danieleteti.it/downloads/pacman-system-one-en.zip. Faits principaux :
- Modèle : BAAI/bge-reranker-large (environ 560 millions de paramètres, 2,2 Go sur disque) avec PyTorch 2.5.1+cu121 et Transformers 5.17.0, Python 3.12
- Machine : ASUS ProArt Studiobook H7604JV, Intel Core i9-13980HX (24 cœurs, 32 threads), 32 Go de RAM, NVIDIA GeForce RTX 4060 Laptop GPU 8 Go, Windows 11 Pro
- Architecture : client HTML/JavaScript avec canvas, serveur Python FastAPI, WebSocket ; le navigateur demande une décision toutes les 240 ms avec la position de Pac-Man, celle des fantômes et les directions libres de murs
- Méthode : pour chaque fantôme, le serveur écrit une phrase (« Pac-Man is above and to the left of the ghost. ») et la compare à quatre affirmations fixes. La marge entre affirmations opposées décide la direction sur chaque axe ; en fuite, les directions sont inversées ; le code écarte les directions bloquées par les murs
- Latence avec 3 fantômes (12 paires) : 39 ms de médiane dans une session, 66-67 ms dans une autre une heure plus tard, sur la même machine et avec le même code ; dans le GIF, le panneau affiche 37,0 et 71,7 ms. Premier appel après le chargement 539-556 ms, chargement 17,3 s, 2,1 Go de VRAM. Sur CPU (24 threads), 1 210 ms de médiane
- Passage à l'échelle (session lente) : 1 fantôme 66 ms, 3 fantômes 70 ms, 8 fantômes 99 ms, 16 fantômes 190 ms, 32 fantômes 386 ms ; un texte comparé à 32 candidats en 99 ms équivaut à environ 36 000 décisions par heure sur un portable, sans coût par token
- Problèmes du modèle : avec des étiquettes sous forme de code (ROUTE_TO_BILLING), les scores valent tous environ -9,5 et la softmax donne environ 25% à chacune ; avec des descriptions en mots, la bonne réponse prend 99,8% ; avec des coordonnées numériques, le signe des deux axes est juste dans 18 positions sur 80, avec une phrase dans 80 sur 80 ; le score n'est pas une probabilité (softmax à température 1 : 99,8%, à température 2 : 92,6%)
- Tests : en chasse, le coup réduit la distance dans 4 cas sur 6 (il se trompe quand la direction directe est fermée par un mur) ; en fuite, il l'augmente dans 6 cas sur 6. Le modèle ne connaît pas le labyrinthe ; les fantômes mangés rentrent à la maison avec un BFS dans le navigateur
- Le même résultat dans le jeu s'obtient avec deux comparaisons de signe : l'expérience sert à mesurer la forme de l'appel, pas à faire un meilleur Pac-Man
- Cas d'usage ERP sur lesquels travaille bit Time Professionals, à qui de nombreuses entreprises demandent d'intégrer l'IA de façon concrète et rentable : classification des documents entrants (factures fournisseurs, bons de livraison, commandes) avec proposition de compte ou de centre de coûts ; rapprochement des descriptions fournisseurs avec le fichier articles (préfiltre SQL ou plein texte et reranking d'environ 30 candidats, environ 100 ms pour 32 paires) ; rapprochement bancaire à partir du libellé libre, avec des montants contrôlés par le code ; classification des tickets et rapports d'intervention par type, affaire et facturabilité ; détection des doublons dans les fiches tiers ; catégories de produits et codes douaniers ; notes de frais incohérentes ; classification des réclamations et retours par cause ; affectation de l'intervention au bon technicien ; reranking de la base de connaissances du support ; score des clients à risque de départ. Les personnes intéressées peuvent écrire à professionals@bittime.it pour une évaluation gratuite de 30 minutes sur la manière d'intégrer l'IA de façon rentable dans leur logiciel. Règles : options décrites en mots, calculs et montants faits par le code, seuil réglé sur les données du client, sous le seuil c'est une personne qui décide, données qui ne sortent pas de l'entreprise
- Différence interne par rapport à Jev : TypeSafe ne publie pas l'architecture de Jev (type de modèle et paramètres non déclarés) mais annonce des sorties produites en une seule interrogation, des probabilités calibrées et un entraînement par RLCD (Reinforcement Learning for Calibrated Decisions) ; le reranker bge-reranker-large est entraîné à classer des documents par pertinence, évalue chaque paire (texte, option) indépendamment sans voir les autres options, et renvoie un score qui n'est pas une probabilité : distribution, confiance et seuil sont construits par le code
- Alternatives à Jev : modèles open compatibles avec l'API /v1/systemone comme Laya (Convai Innovations, 421M, ModernBERT, Apache 2.0, variante multilingue) et Decider (Mapika, 0,8-35B, Qwen3.5, Apache 2.0) ; avant Jev, rerankers, classificateurs zero-shot NLI et LLM avec structured output. bge-reranker-large a été choisi parce qu'il est connu et documenté, sous licence MIT y compris pour un usage commercial, 2,1 Go de VRAM, utilisable avec transformers sans entraînement ; limite : déclaré seulement pour le chinois et l'anglais (l'e-mail de test de cette édition est en anglais ; dans l'édition italienne, le même test avec un e-mail en italien a aussi reçu la bonne réponse, 94,1%) ; pour un logiciel de gestion qui travaille en français, mieux vaut un modèle multilingue comme bge-reranker-v2-m3 ou Laya multilingue
- IA entièrement locale : aucune API en cloud, aucune clé, aucun coût par token, aucune donnée qui sort de la machine ; internet ne sert qu'au premier téléchargement du modèle, ensuite avec HF_HUB_OFFLINE=1 le modèle se charge depuis le cache et décide sans réseau (vérifié)
- LLM classiques (qui écrivent) et modèles System One (qui choisissent) ont des usages différents dans un ERP : les premiers pour les brouillons de réponse, les résumés, les explications et les agents conversationnels ; les seconds pour des décisions répétées entre options connues
- Nouveauté du 29 septembre 2026, sortie pendant la rédaction de l'article : Ollama prend en charge les modèles de décision à la Jev avec l'endpoint /v1/systemone (https://ollama.com/blog/ollama-now-supports-jev-style-decision-models) ; modèles disponibles Nimble 9B (Bespoke Labs), Tev1 4B et Tev1 0.8B (Together AI), d'autres annoncés prochainement, y compris dans le cloud d'Ollama. Une comparaison entre les deux runners (transformers et Ollama) est prévue dans un prochain article
- Lié au benchmark de Jev (TypeSafe AI) publié sur danieleteti.it le 22 septembre 2026 (https://www.danieleteti.it/post/jev-typesafe-delphi-benchmark-fr/) et à l'épisode 7 du podcast en italien « while true do; » de Daniele Teti (https://www.danieleteti.it/podcast/jev-typesafe-ai-decide-non-scrive/)
- Lié à la formation MCP et Agentic AI avec Delphi de bit Time Professionals (https://www.danieleteti.it/post/mcp-agentic-ai-delphi-training-en/), au serveur MCP pour DelphiMVCFramework, à l'agent IA embarqué dans les applications Delphi et à MCP Firebird
Comments