L'AI che muove i fantasmi di Pac-Man può smistare le tue fatture?
🇬🇧 English • 🇪🇸 Español • 🇩🇪 Deutsch • 🇫🇷 Français • 🇧🇷 Português
La settimana scorsa ho messo alla prova Jev, il modello di TypeSafe che non scrive testo ma sceglie fra opzioni e ti dice quanto è sicuro. Jev però sta solo in cloud. Allora mi sono chiesto se lo stesso schema, testo in ingresso e un punteggio per ogni opzione, regge anche con un'AI locale, un modello open che gira sulla GPU del portatile senza passare dal cloud, dentro un ciclo dove la risposta serve ogni quarto di secondo. Per scoprirlo gli ho dato in mano i fantasmi di Pac-Man, e poi mi sono chiesto cosa c'entra tutto questo con le fatture e il gestionale di un'azienda.
La settimana scorsa ho pubblicato il benchmark di Jev, il modello di TypeSafe AI che TypeSafe chiama “System One”: gli passi un testo e delle opzioni, lui ti restituisce la scelta e una confidenza, senza scrivere una parola. Di Jev e dei modelli che decidono senza scrivere ho parlato anche nel mio podcast in italiano, “while true do;”, nella puntata 7: lì c’è la parte “come la vedo io”, nel benchmark ci sono i numeri. Jev funziona bene, ma è un’API in cloud, in accesso anticipato, e ogni risposta ci mette un terzo di secondo.
Esistono da anni modelli open che hanno la stessa forma. Un reranker, o cross-encoder, riceve una coppia di testi e restituisce un numero solo: quanto il secondo è pertinente al primo. Si usa nei motori di ricerca e nelle pipeline RAG per riordinare i risultati, ma se al posto dei documenti gli dai delle opzioni, diventa un classificatore a scelta fissa. Ho preso BAAI/bge-reranker-large, circa 560 milioni di parametri, e l’ho fatto girare sulla GPU del mio portatile. Gira tutto in locale: non chiamo API in cloud, non serve una chiave, non pago token, e i dati non escono dalla macchina. Con HF_HUB_OFFLINE=1 il modello si carica dalla cache e decide senza toccare la rete: l’ho provato.
Per vedere se regge dentro un ciclo in tempo reale serviva qualcosa che chiede decisioni continuamente e dove un errore si vede subito. Pac-Man va benissimo.
Cos’è un modello System One
Un modello System One è un modello di AI che non genera testo: riceve un contesto e un elenco di opzioni descritte a parole, e restituisce un punteggio per ciascuna opzione. La decisione finale la prende il codice, confrontando i punteggi con una soglia. Il nome richiama il “Sistema 1” di Daniel Kahneman, il pensiero veloce e automatico.
| LLM classico | Jev (System One in cloud) | Reranker locale (questo articolo) | |
|---|---|---|---|
| Cosa restituisce | Testo | Scelta, distribuzione e confidenza | Un punteggio per ogni coppia (testo, opzione) |
| Dove gira | Cloud o server con GPU grandi | API di TypeSafe o OpenRouter | GPU del tuo PC, anche senza rete |
| Costo per decisione | Token in ingresso e in uscita | Token in ingresso, uscita gratuita | Solo l’elettricità |
| Confidenza utilizzabile | No | Sì, affidabile sopra 0,95, ottimista nella fascia media | No, la costruisci tu |
| Quando usarlo | Bozze, riassunti, spiegazioni, agenti | Decisioni fra opzioni note | Decisioni fra opzioni note, con dati che non devono uscire |
La forma della chiamata è la stessa, ma dentro sono due cose diverse. TypeSafe non ha pubblicato l’architettura di Jev: né il tipo di modello, né i parametri. Dice però tre cose: Jev produce tutte le uscite con una sola interrogazione, restituisce probabilità calibrate, ed è addestrato con un metodo che chiama RLCD, Reinforcement Learning for Calibrated Decisions, cioè proprio per decidere e per dire quanto è sicuro. Il reranker è stato addestrato per un altro mestiere: ordinare documenti per pertinenza. Valuta ogni coppia (testo, opzione) per conto suo e non vede mai le altre opzioni. Per questo il suo numero non è una probabilità, e la distribuzione, la confidenza e la soglia le costruisce il mio codice. Quasi tutti i problemi che trovi più avanti vengono da qui.
Le alternative a Jev
Jev non è rimasto solo a lungo. Nelle due settimane dopo il suo annuncio sono usciti diversi modelli open che riproducono la stessa idea, e alcuni espongono anche la stessa API (POST /v1/systemone), così i client scritti per Jev funzionano cambiando solo l’indirizzo. Due che ho verificato:
- Laya di Convai Innovations: un encoder da 421 milioni di parametri su base ModernBERT, con una variante multilingua, licenza Apache 2.0. Supporta le tre domande di Jev,
choice,scoreenoul; - Decider: una famiglia di modelli derivati da Qwen3.5, da 0,8 a 35 miliardi di parametri, licenza Apache 2.0, dichiaratamente una riproduzione open della classe System One.
Prima ancora di Jev esistevano modelli che si possono usare allo stesso modo senza che nessuno li chiamasse System One: i reranker come quello di questo articolo, i classificatori zero-shot basati su NLI, e gli LLM normali costretti a rispondere con uno schema fisso tramite gli structured output.
Io ho usato bge-reranker-large per quattro motivi. È un modello che si usa da anni nelle pipeline RAG, quindi il comportamento è noto e documentato. Ha licenza MIT e si può usare anche in prodotti commerciali. Sta in 2,1 GB di VRAM, quindi gira su un portatile. E si usa con transformers e dieci righe di Python, senza addestrare niente e senza un server dedicato. Mi interessava capire quanto lontano si arriva con quello che c’era già prima di Jev, non provare l’ultimo arrivato.
C’è un limite da sapere: la pagina del modello dichiara solo cinese e inglese. Sull’email in italiano di test_decision.py ha risposto giusto, ma per un gestionale che lavora in italiano partirei da un modello multilingua, come la variante multilingua di Laya o il più recente bge-reranker-v2-m3. Non li ho ancora misurati con questo gioco.
Notizia dell'ultima ora. Mentre finivo di scrivere questo articolo, il 29 settembre, Ollama ha annunciato il supporto ai modelli decisionali in stile Jev. Espone lo stesso endpoint /v1/systemone e per ora offre tre modelli: Nimble (9 miliardi di parametri, Bespoke Labs) e Tev1 nelle taglie da 4 e da 0,8 miliardi (Together AI). Si scaricano con un ollama pull, come qualsiasi altro modello. Ollama dice anche che a breve arriveranno altri modelli decisionali, alcuni serviti dal suo cloud.
Per un'AI locale è una novità importante, e merita un post a parte: a breve metto a confronto i due runner, transformers con il reranker di questo articolo e Ollama con i suoi modelli decisionali, sullo stesso gioco e sulla stessa email.
Come è fatto
Tre pezzi:
static/index.html: il gioco, un canvas e un po’ di JavaScript. Pac-Man lo muovi tu con le frecce o con WASD;server.py: FastAPI con un endpoint WebSocket, carica il modello all’avvio e risponde alle richieste di decisione;generate_maze.py: genera un labirinto 21x21 con un backtracker ricorsivo (seme fisso, così è sempre lo stesso), lo rende simmetrico, apre qualche passaggio in più e mette una power pellet in ogni angolo. Alla fine controlla che ogni cella sia raggiungibile.
Ogni 240 ms il browser manda al server lo stato che serve per decidere: dove sta Pac-Man, dove sta ogni fantasma e da quali lati non c’è un muro.
{
  "type": "decide",
  "mode": "chase",
  "pacman": { "r": 17, "c": 2 },
  "ghosts": [
    { "id": 0, "r": 9,  "c": 10, "legal": ["up", "down", "left", "right"] },
    { "id": 1, "r": 10, "c": 9,  "legal": ["up", "down"] },
    { "id": 2, "r": 10, "c": 11, "legal": ["left", "right", "down"] }
  ]
}
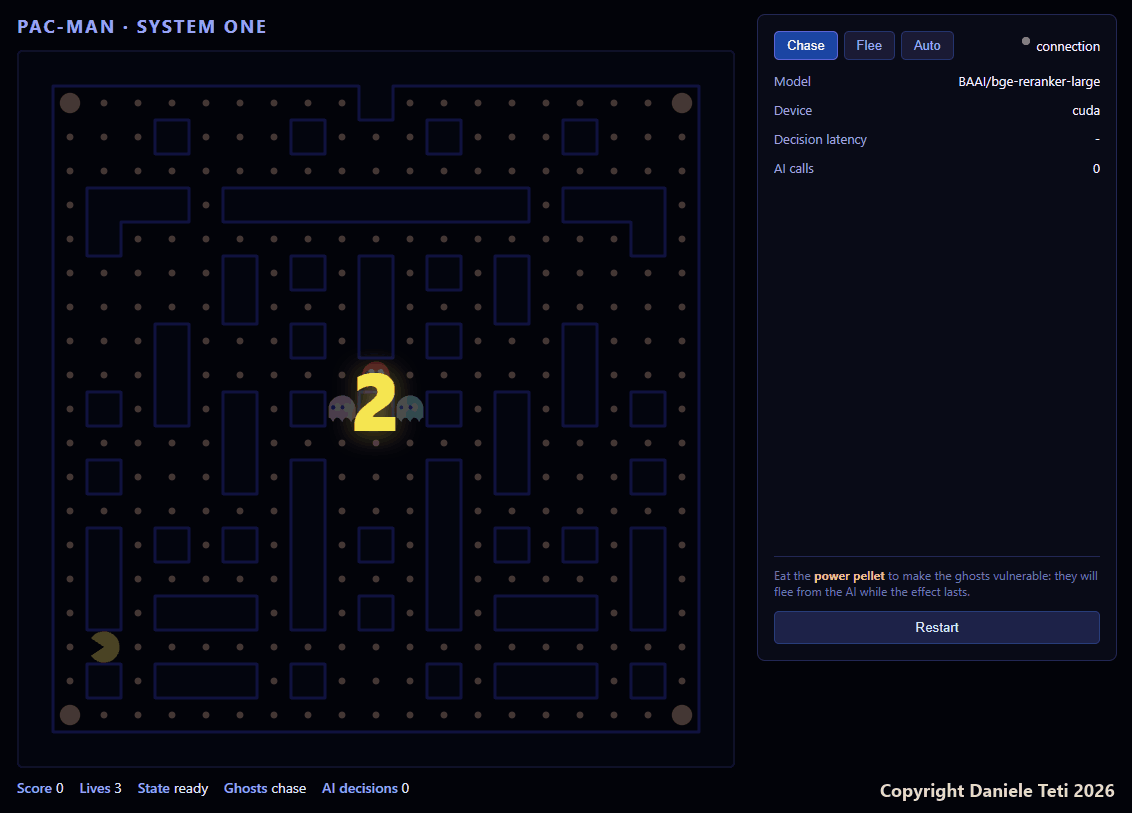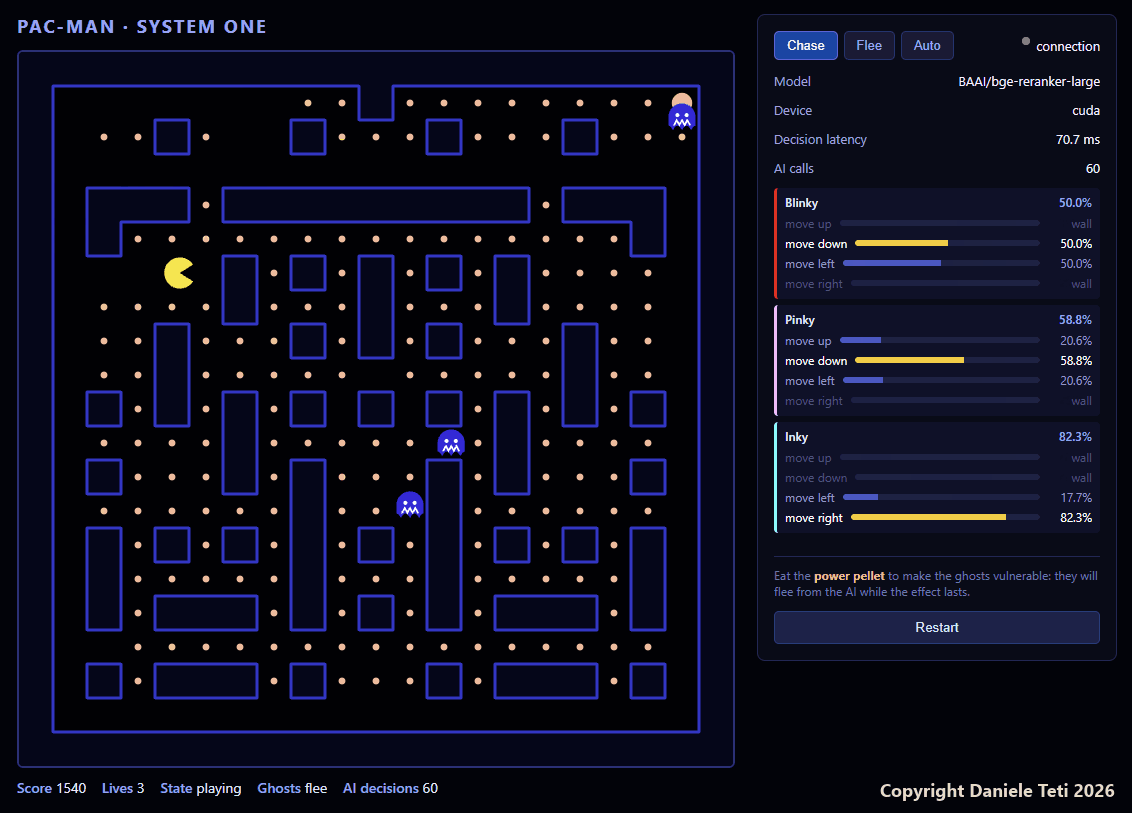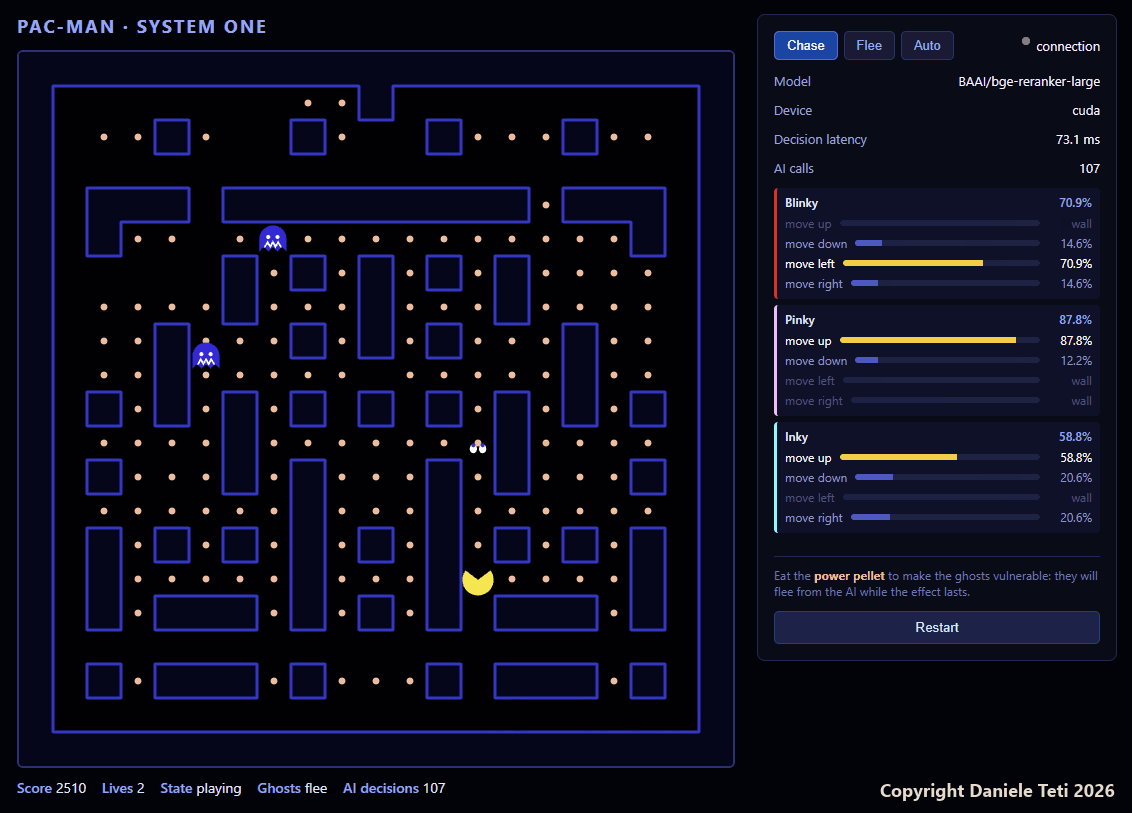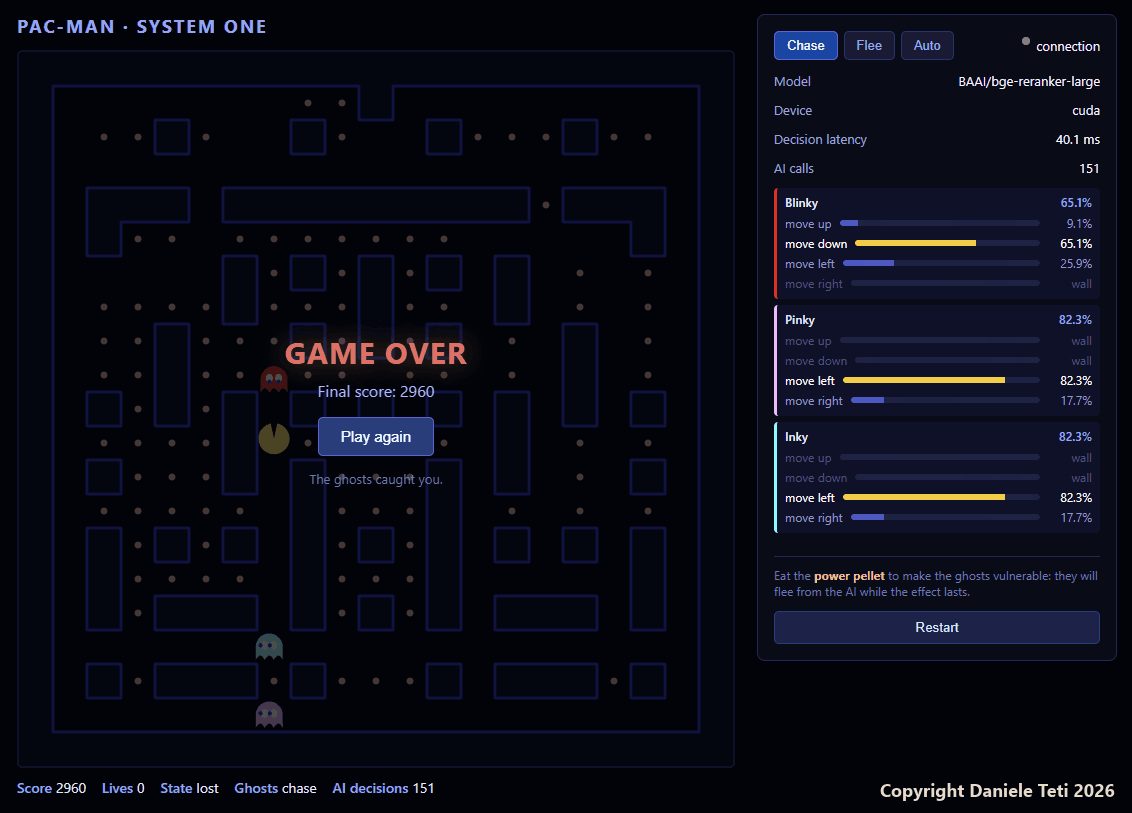
Il server risponde con una direzione per fantasma e la classifica delle direzioni libere, che il pannello a destra mostra come barre. Se la risposta non arriva in tempo, il fantasma continua nella direzione che aveva.
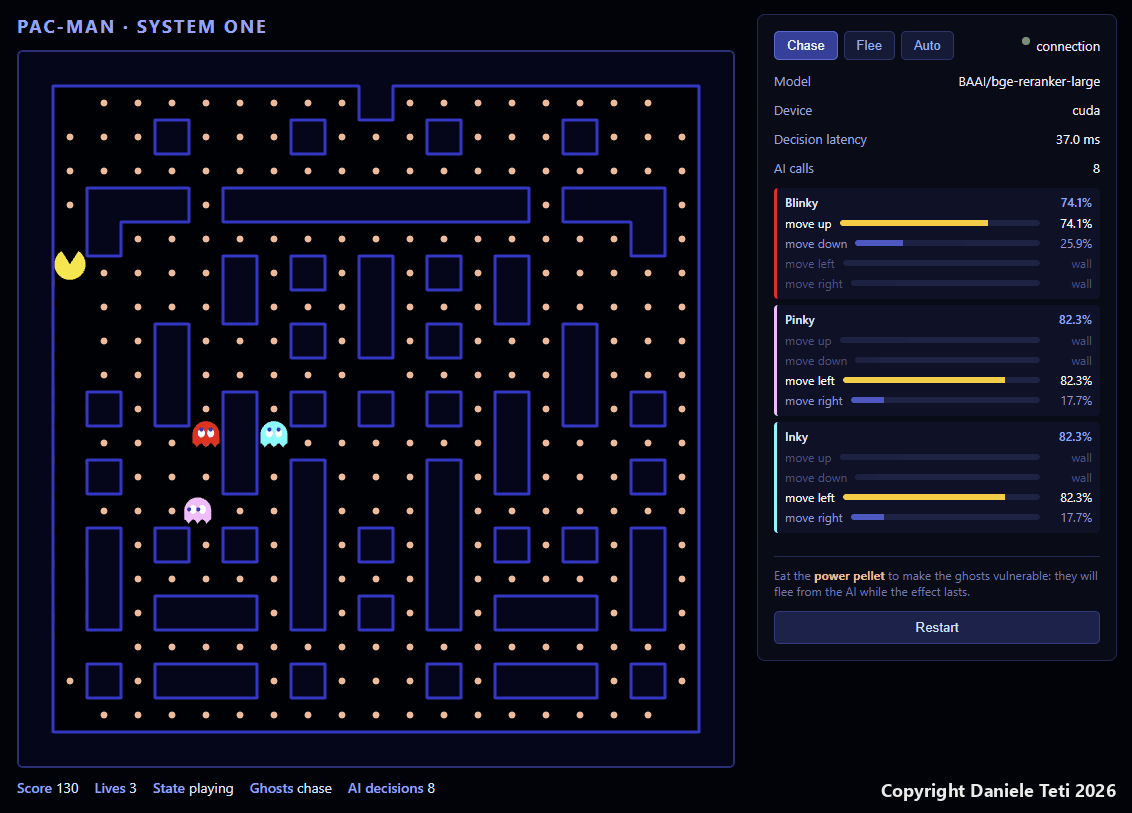
Qui Pac-Man sta in alto a sinistra. Blinky può andare solo su o giù e va su, Pinky e Inky possono andare solo a sinistra o a destra e vanno a sinistra. Le direzioni chiuse compaiono come wall: al modello non arrivano nemmeno.
Dalle coordinate a una frase
Il reranker confronta un testo con un altro testo, quindi le coordinate non gliele passo: il server le trasforma prima in una frase.
def relative_query(dc, dr):
    """Descrive a parole dove si trova Pac-Man rispetto al fantasma."""
    parts = []
    if dr < 0:
        parts.append("above")
    elif dr > 0:
        parts.append("below")
    if dc < 0:
        parts.append("to the left")
    elif dc > 0:
        parts.append("to the right")
    rel = " and ".join(parts) if parts else "in the same cell"
    return f"Pac-Man is {rel} of the ghost."
Poi la confronta con quattro affermazioni fisse, una per direzione:
AXIS_DOC = {
    UP: "Pac-Man is higher than the ghost",
    DOWN: "Pac-Man is lower than the ghost",
    LEFT: "Pac-Man is to the left of the ghost",
    RIGHT: "Pac-Man is to the right of the ghost",
}
Con tre fantasmi sono 12 coppie, e vanno al modello in un solo batch:
docs = [AXIS_DOC[c] for c in CARDINALS]
pairs = [[q, d] for q in queries for d in docs]

inputs = tok(pairs, padding=True, truncation=True, return_tensors="pt").to(DEVICE)
with torch.no_grad():
    scores = model(**inputs).logits.view(-1).float().cpu().tolist()
Potevo anche fargli valutare direttamente “move up”, “move left” e così via. L’ho provato mentre scrivevo questo articolo, aggiungendo alla frase “The ghost wants to catch Pac-Man.”: sulle posizioni lungo un solo asse sceglie la mossa giusta 12 volte su 12. Ho tenuto le quattro affermazioni perché danno un punteggio per ogni lato, e con due lati opposti ottengo un margine per asse, che serve al passo successivo.
Dal punteggio alla mossa
Qui il modello ha finito. Il resto lo decide il codice, come il RouteByConfidence dell’articolo su Jev.
Per ogni fantasma confronto i punteggi delle affermazioni opposte: su contro giù, sinistra contro destra. Il segno del margine dice da che parte andare su quell’asse, la sua grandezza dice quanto è netta la scelta. L’asse con il margine più grande viene prima.
margin_v = s[UP] - s[DOWN]
margin_h = s[LEFT] - s[RIGHT]

move_v = UP if margin_v > 0 else DOWN
move_h = LEFT if margin_h > 0 else RIGHT
strength_v, strength_h = abs(margin_v), abs(margin_h)

if mode == "flee":
    move_v, move_h = OPPOSITE[move_v], OPPOSITE[move_h]

order = [DIR_NAME[move_v], DIR_NAME[move_h]] if strength_v >= strength_h else [DIR_NAME[move_h], DIR_NAME[move_v]]
chosen = next((c for c in order if c in legal), None)
La fuga non chiede niente di nuovo al modello: stessi punteggi, direzioni invertite. Scatta quando premi Flee, ogni cinque secondi in modalità Auto, e per sette secondi quando Pac-Man mangia una power pellet.
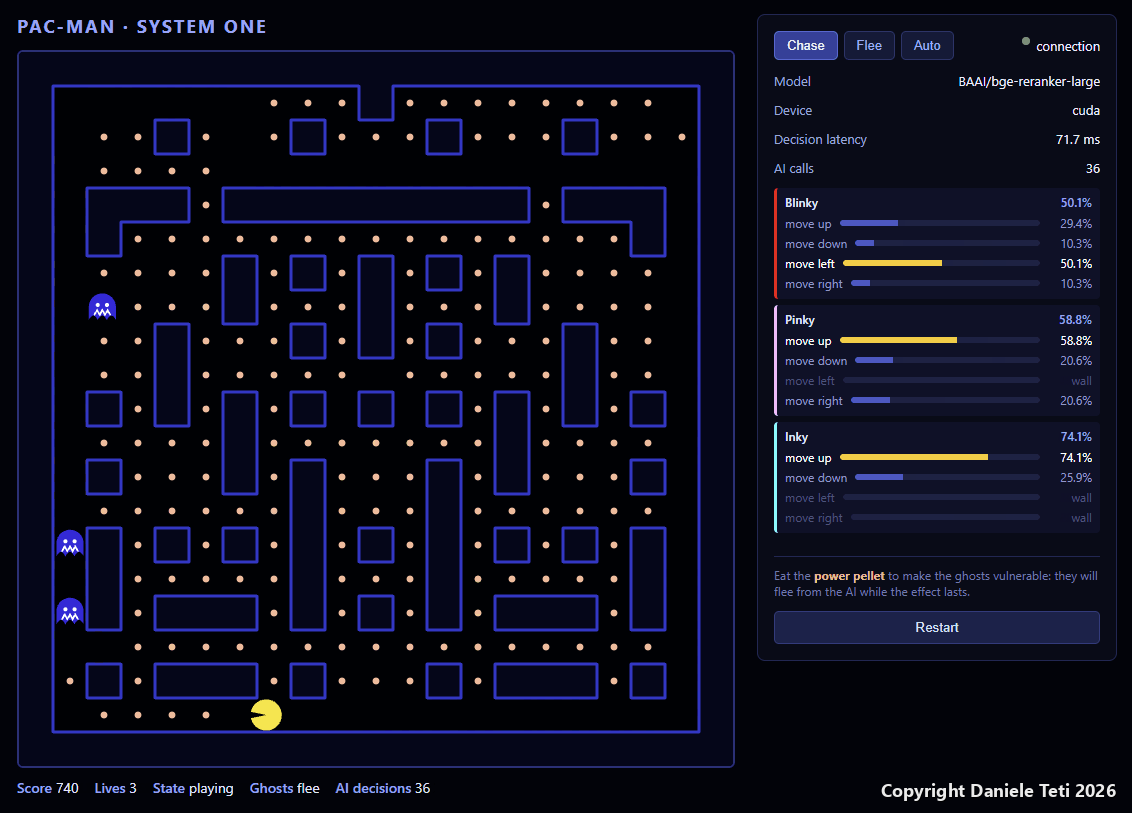
Qui Pac-Man ha appena mangiato la power pellet: i fantasmi sono blu e in basso c’è Ghosts flee, anche se in alto è selezionato Chase. Guarda anche la latenza: 71,7 ms, contro i 37,0 della schermata di prima, nella stessa registrazione. Ci torno fra poco.
La percentuale che vedi nel pannello non è una probabilità del modello. È il margine normalizzato sulle direzioni libere, e le direzioni che non sono la preferita di nessun asse prendono il 35% del margine più debole. Serve a vedere a colpo d’occhio se il fantasma è deciso o incerto, ma non ha niente a che vedere con la confidenza di Jev, che nel benchmark ho potuto misurare.
Lo stesso modello su una email
Il gioco non è stato il primo test. Prima di dargli i fantasmi ho provato il modello sullo stesso lavoro che avevo dato a Jev: smistare una email di un cliente al reparto giusto. È test_decision.py, nello zip. L’email è una sola, “Vorrei disdire il mio abbonamento e chiedere il rimborso dell’ultimo mese”, e i reparti possibili sono quattro: amministrazione, assistenza tecnica, commerciale, spam.
Il meccanismo è lo stesso dei fantasmi: una coppia (email, reparto) per ogni reparto, tutte in un batch, e un punteggio per coppia.
user_input = "Vorrei disdire il mio abbonamento e chiedere il rimborso dell'ultimo mese"
possible_actions = [
    "Fatturazione, rimborsi e abbonamenti",
    "Assistenza tecnica e malfunzionamenti",
    "Vendite e informazioni commerciali",
    "Spam o messaggio pubblicitario indesiderato"
]
pairs = [[user_input, action] for action in possible_actions]
Questo è l’output di un’esecuzione, la prima dopo il caricamento del modello:
=== Inizializzazione Modello System One (CUDA) ===

Tempo di decisione: 179.14 ms
--------------------------------------------------
Azione: Fatturazione, rimborsi e abbonamenti | Confidenza: 94.12%
Azione: Assistenza tecnica e malfunzionamenti | Confidenza: 1.63%
Azione: Vendite e informazioni commerciali | Confidenza: 1.63%
Azione: Spam o messaggio pubblicitario indesiderato | Confidenza: 2.62%
La risposta è giusta. Per arrivarci però ho dovuto sistemare due cose, e altre tre sono venute fuori con il gioco.
I problemi con il modello
Per rimettere in fila i cinque problemi con dei numeri veri ho scritto experiments.py, che trovi nello zip.
Le etichette in codice non significano niente. Nell’email di sopra i reparti sono descritti a parole. Il primo istinto, da programmatore, è usare delle costanti: ROUTE_TO_BILLING, ROUTE_TO_SUPPORT, ROUTE_TO_SALES, ROUTE_TO_SPAM. Per il reranker sono stringhe senza senso, e la stessa email prende lo stesso punteggio con tutte e quattro. Con le descrizioni la risposta giusta si stacca subito:
== 3. Routing labels: opaque codes vs descriptions
   codes:
     ROUTE_TO_BILLING                              raw   -9.44  softmax  25.6%
     ROUTE_TO_SUPPORT                              raw   -9.48  softmax  24.7%
     ROUTE_TO_SALES                                raw   -9.48  softmax  24.7%
     ROUTE_TO_SPAM                                 raw   -9.47  softmax  25.0%
   descriptions:
     Fatturazione, rimborsi e abbonamenti          raw   -1.36  softmax  99.9%
     Assistenza tecnica e malfunzionamenti         raw   -9.48  softmax   0.0%
     Vendite e informazioni commerciali            raw   -9.48  softmax   0.0%
     Spam o messaggio pubblicitario indesiderato   raw   -8.52  softmax   0.1%
È la stessa regola di Jev, dove ogni opzione ha la sua descrizione: il modello legge il testo dell’opzione, non il nome della chiave.
Il punteggio non è una probabilità. bge-reranker-large ha un’uscita sola per coppia: un numero di pertinenza, qui tutti negativi. Per avere delle percentuali devi normalizzarle tu, e il risultato dipende da come lo fai. Con una softmax semplice la risposta giusta prende il 99,9%. test_decision.py divide i punteggi per una temperatura di 2 prima della softmax e ottiene 94,1%. Stesso modello, stessa email: la “confidenza” la scegli tu. Jev invece restituisce una distribuzione che puoi confrontare con una soglia, e che ho potuto misurare.
Con i numeri non ragiona. Se al posto della frase gli passi le coordinate (“Pac-Man is at row 12, column 6. The ghost is at row 10, column 10.”), il modello deve fare una sottrazione, e non la fa. Su 80 posizioni diverse:
== 4. Raw coordinates instead of a sentence
   sentence    : both axis signs right in 80/80 positions
   coordinates : both axis signs right in 18/80 positions
Tirando a caso ne azzeccheresti una ventina: in 64 posizioni devi indovinare due assi, in 16 uno solo. Con le coordinate il modello fa peggio del caso. Il conto lo fa relative_query, e il modello legge il risultato.
Non conosce il labirinto. test_server.py mette un fantasma e Pac-Man in posizioni note e controlla se la mossa scelta riduce la distanza (in caccia) o la aumenta (in fuga). Questo è l’output, intero:
=== caccia: la mossa riduce la distanza?
  pac=(0, 5) ghost=(0, 0) legal=['up', 'down', 'left', 'right']
    scelto=right conf=94.6% dist 5->4 riduce OK
  pac=(0, 0) ghost=(0, 5) legal=['up', 'down', 'left', 'right']
    scelto=left  conf=76.1% dist 5->4 riduce OK
  pac=(5, 0) ghost=(0, 0) legal=['up', 'down', 'left', 'right']
    scelto=down  conf=59.7% dist 5->4 riduce OK
  pac=(0, 0) ghost=(5, 0) legal=['up', 'down', 'left', 'right']
    scelto=up    conf=64.1% dist 5->4 riduce OK
  pac=(0, 5) ghost=(0, 0) legal=['up', 'down', 'left']
    scelto=up    conf=58.8% dist 5->6 NON riduce X
  pac=(0, 5) ghost=(0, 0) legal=['up', 'down']
    scelto=up    conf=74.1% dist 5->6 NON riduce X
  riducono la distanza: 4/6

=== fuga: la mossa aumenta la distanza?
  pac=(0, 5) ghost=(0, 0) scelto=left  dist 5->6 aumenta OK
  pac=(0, 0) ghost=(0, 5) scelto=right dist 5->6 aumenta OK
  pac=(5, 0) ghost=(0, 0) scelto=up    dist 5->6 aumenta OK
  pac=(0, 0) ghost=(5, 0) scelto=down  dist 5->6 aumenta OK
  pac=(0, 5) ghost=(0, 0) scelto=left  dist 5->6 aumenta OK
  pac=(0, 5) ghost=(0, 0) scelto=down  dist 5->6 aumenta OK
  aumentano la distanza: 6/6
I due errori sono lo stesso caso: Pac-Man sta a destra, ma a destra c’è un muro. Il modello ha risposto giusto alla domanda che gli ho fatto, cioè da che parte sta Pac-Man, ma l’asse orizzontale è bloccato. Sull’asse verticale Pac-Man è alla stessa altezza, il margine è rumore e il fantasma va su. In un corridoio vero un fantasma può infilarsi in un vicolo cieco e restarci finché Pac-Man non cambia lato. Nemmeno i fantasmi del Pac-Man del 1980 cercavano un percorso: a ogni incrocio prendevano la casella più vicina al bersaglio in linea d’aria. I fantasmi mangiati invece tornano a casa con una BFS scritta in JavaScript nel browser: lì serve il percorso più corto, e una BFS lo trova senza bisogno di un modello.
La prima chiamata è lenta. Dopo il caricamento la prima decisione ci mette più di mezzo secondo, 539 ms in experiments.py e 556 ms quando ho avviato il server dallo zip, perché CUDA si inizializza lì. Per questo server.py carica il modello nel lifespan di FastAPI, prima di accettare connessioni, e il gioco parte con un conto alla rovescia di tre secondi.
La macchina: tutto in locale
Tutti i numeri di questo articolo vengono da un portatile, non da un server:
- ASUS ProArt Studiobook H7604JV, Windows 11 Pro;
- Intel Core i9-13980HX, 24 core e 32 thread;
- 32 GB di RAM;
- NVIDIA GeForce RTX 4060 Laptop GPU, 8 GB di VRAM, driver 576.02;
- Python 3.12.10, PyTorch 2.5.1 con CUDA 12.1, Transformers 5.17.0.
La 4060 Laptop è una GPU da portatile di fascia media. Se ne hai una desktop, o una qualsiasi scheda NVIDIA con 3 GB liberi, ci stai dentro. Internet serve una volta sola, per scaricare il modello da Hugging Face; da lì in poi il server lo carica dalla cache sul disco.
I numeri
Questo è l’output di experiments.py per caricamento, latenza e CPU. Ho tolto solo la barra di avanzamento del caricamento dei pesi; la sezione 3 e la 4 sono quelle che hai già visto sopra.
== 1. Load: 17.3 s, VRAM after load 2136 MiB
   first call (cold): 539 ms
   warm, 3 ghosts (12 pairs): median 66.0 ms, p95 70.6 ms, peak VRAM 2160 MiB

== 2. Latency vs number of ghosts (GPU, 100 calls each)
    1 ghosts,   4 pairs: median   66.2 ms, p95   75.6 ms
    3 ghosts,  12 pairs: median   69.9 ms, p95   76.4 ms
    8 ghosts,  32 pairs: median   98.9 ms, p95  101.7 ms
   16 ghosts,  64 pairs: median  189.6 ms, p95  196.7 ms
   32 ghosts, 128 pairs: median  385.5 ms, p95  394.7 ms

== 5. CPU instead of GPU (same 12 pairs, 20 calls)
   CPU (24 threads): median 1210 ms, p95 1254 ms
In sintesi:
| Cosa | Valore |
|---|---|
| Caricamento del modello | 17,3 s |
| VRAM occupata | 2,1 GB |
| Prima chiamata | 539-556 ms |
| 3 fantasmi, GPU | 39 ms o 67 ms di mediana, a seconda della sessione |
| 3 fantasmi, CPU (24 thread) | 1.210 ms di mediana |
| Da 1 a 3 fantasmi | +4 ms |
| 32 fantasmi, GPU | 386 ms di mediana |
| Cadenza del gioco | una decisione ogni 240 ms |
La riga dei 39 o 67 ms va spiegata. La prima volta che ho misurato, con lo stesso codice e lo stesso portatile collegato all’alimentatore, avevo 39,0 ms di mediana e 40,8 ms al 95° percentile. Un’ora dopo tre esecuzioni di fila hanno dato 66-67 ms, e anche la GIF mostra entrambi i valori, 37,0 e 71,7 ms. nvidia-smi durante il carico riportava la GPU nello stato di risparmio più basso, P8 a 210 MHz. Non ho cercato oltre: su un portatile il profilo energetico decide quanto va la GPU, e se misuri devi rifare la misura più volte.
Con tre fantasmi comunque il gioco ha margine anche nella sessione lenta. Da uno a tre fantasmi il tempo quasi non cambia, perché le coppie vanno in un solo batch. Da otto in su cresce in proporzione alle coppie. La CPU invece non basta: un fantasma fa un passo ogni 162 ms, quindi con 1,2 secondi a decisione reagisce con sette passi di ritardo.
Ne valeva la pena?
Per muovere un fantasma, no. Tutto quello che il reranker fa qui lo fanno due confronti di segno su dr e dc, in un microsecondo e senza una GPU. Se ti serve un Pac-Man, scrivi quei due if.
Il gioco mi serviva per provare la forma della chiamata dove un errore salta all’occhio: opzioni fisse descritte a parole, un punteggio per ciascuna, la decisione finale presa dal codice, e una latenza che su un portatile resta intorno ai 70 ms anche nella sessione lenta. È la stessa forma dello smistamento di email che ho provato con Jev, con due differenze pratiche: i dati non escono dalla macchina, e la confidenza te la devi costruire e tarare da solo.
Fai due conti con i numeri della sessione lenta. Una chiamata con 32 coppie, cioè un testo confrontato con 32 candidati, ci mette 99 ms. Una dopo l’altra fanno circa 36.000 decisioni all’ora, su un portatile, senza pagare un token. I fantasmi sono il modo più divertente che ho trovato per vederlo; il posto dove quei numeri pesano davvero è un altro.
Casi d’uso negli ERP
Negli ultimi mesi in bit Time Professionals molte aziende ci stanno chiedendo la stessa cosa: aiutarle a integrare l’AI in azienda in modo reale e proficuo. Hanno già provato la chat, qualcuno ha fatto un prototipo, e adesso vogliono qualcosa che lavori dentro il gestionale, sui loro dati, sapendo prima quanto costa e poi quanto tempo fa risparmiare.
In un ERP servono tutti e due i tipi di modello. Un LLM classico, quello che scrive, lo usi quando il risultato è un testo: la bozza di risposta a un cliente, il riassunto dello storico di una commessa, la spiegazione di un’anomalia in un bilancio di verifica, un agente che dialoga con l’utente e usa le funzioni del gestionale. Un modello System One, che non scrive e sceglie, lo usi quando il risultato è una decisione fra opzioni note, magari ripetuta migliaia di volte al giorno: lì un LLM funziona, ma costa di più, è più lento e ti restituisce un testo che poi devi interpretare.
Scenari dal futuro prossimo
Il lunedì delle fatture. Nel weekend sono arrivate 380 fatture passive. Alle 8:30 di lunedì, quando in amministrazione accendono il PC, il gestionale le ha già lette tutte: per ciascuna ha proposto il conto e il centro di costo, e 340 sono precompilate e aspettano solo un'occhiata. Le altre 40 sono in una coda a parte, ognuna con le due ipotesi più probabili e il punteggio accanto. La mattinata comincia da quelle 40, e le fatture non sono mai uscite dal server nella stanza accanto.
I modelli System One, per esempio, possono essere usati per questi casi, su cui stiamo lavorando:
- Documenti in arrivo. Fatture passive, DDT, ordini e conferme d’ordine che arrivano via PEC o email. Il modello dice che tipo di documento è e propone il conto di contabilità generale o il centro di costo, scegliendo fra le descrizioni del piano dei conti del cliente. Sopra la soglia la registrazione viene precompilata, sotto va in una coda che controlla una persona.
- Descrizioni dei fornitori e anagrafica articoli. Il fornitore scrive “vite TE M8x40 zincata conf. 100”, in anagrafica c’è “Vite testa esagonale M8 L40 ZN”. Qui il reranker fa il mestiere per cui è nato: una query SQL o una ricerca full-text tira fuori una trentina di articoli candidati, e il modello li mette in ordine. Con 32 coppie, sul mio portatile, siamo intorno ai 100 ms.
- Riconciliazione bancaria. La causale di un bonifico è testo libero scritto dal cliente, spesso male: “saldo fatt 1234 e 1240 meno nc”. Il modello confronta la causale con le partite aperte di quel cliente e propone l’abbinamento. Gli importi li controlla il codice, non il modello: abbiamo visto sopra che con i numeri non ragiona.
- Ticket e interventi tecnici. Il rapportino del tecnico o il ticket del cliente vanno classificati per tipo di intervento, commessa e fatturabilità: in garanzia, a contratto o da fatturare a parte. È lo smistamento dell’email, con opzioni diverse.
- Anagrafiche doppie. “Rossi S.r.l.”, “ROSSI SRL” e “Rossi srl - sede di Bologna” sono lo stesso cliente? Un confronto a coppie con un punteggio è esattamente quello che fa un cross-encoder.
- Categorie merceologiche e codici doganali. Un articolo nuovo arriva con una descrizione libera e va messo nella categoria giusta, o gli va proposto il codice della nomenclatura combinata. Le voci candidate le filtra il codice, il modello le ordina, e chi gestisce l’anagrafica conferma.
- Note spese. La descrizione della spesa è coerente con la categoria scelta dal dipendente? “Cena con cliente Bianchi” sotto “Carburante” è una domanda sì/no, e le incoerenze finiscono in una lista da controllare invece che nel controllo a campione.
- Reclami e resi. Ogni reclamo viene classificato per causa: difetto del prodotto, danno nel trasporto, ritardo, errore di prezzo, articolo sbagliato. Alla fine del mese hai un report per causa senza che nessuno abbia letto e codificato a mano centinaia di messaggi.
- Il tecnico giusto. La descrizione del guasto viene confrontata con le competenze dei tecnici o con le famiglie di prodotto, e l’intervento va a chi lo sa fare. Il calendario e le distanze restano al codice.
- La knowledge base dell’helpdesk. Chi risponde al telefono scrive il problema del cliente e il modello riordina le schede della documentazione interna e le soluzioni dei ticket già chiusi. È l’uso originale di un reranker, dentro il gestionale.
- Clienti a rischio. Un punteggio su ogni messaggio in arrivo: quanto è frustrato il cliente, se minaccia di andarsene, se chiede di parlare con un responsabile. I casi sopra soglia arrivano al commerciale il giorno stesso in cui il cliente ha scritto.
Assessment gratuito di 30 minuti. Uno di questi casi somiglia a quello che fai ogni giorno nel tuo gestionale? Scrivi a professionals@bittime.it: guardiamo insieme il tuo software e i tuoi processi, e capiamo in che modo l'AI, locale o in cloud, che scrive o che sceglie, può essere integrata in modo proficuo e aiutare il tuo business.
In tutti questi casi valgono le regole che l’email e il gioco hanno messo in fila. Le opzioni vanno descritte a parole, non con i codici dell’ERP. I conti, le date e gli importi li fa il codice, e il modello legge solo il testo. La decisione finale la prende il codice confrontando il punteggio con una soglia, e la soglia si tara sui dati del cliente, non su quelli di un benchmark. Sotto la soglia decide una persona.
Poi c’è il motivo per cui l’AI locale interessa tanto, e nelle riunioni con i clienti è quasi sempre la prima domanda: le fatture, le anagrafiche e i movimenti bancari non escono dall’azienda, e il costo per decisione è l’elettricità della GPU. Con un modello in cloud, a migliaia di documenti al giorno, il costo per token si vede a fine mese; con uno locale no. E su dati come questi il DPO vuole sapere prima di tutto dove vanno a finire.
Un modello che sceglie è un pezzo del lavoro. L’altro è dare all’AI accesso al gestionale in modo controllato, ed è quello che facciamo con MCP: il server MCP per DelphiMVCFramework espone le funzioni dell’applicazione a un modello, e con un agente embedded nell’applicazione Delphi il loop agentico gira dentro il gestionale e si ferma prima di agire. Un reranker locale come questo si inserisce proprio lì, come strumento che l’agente chiama quando deve scegliere fra opzioni note senza mandare i dati fuori.
Tutto questo lo insegniamo nel corso MCP e Agentic AI con Delphi, due giorni hands-on in cui costruisci un MCP server e lo fai crescere fino a un agente dentro il gestionale (pagina del corso). Se lavori su Firebird, MCP Firebird è un esempio già pronto di AI messa al lavoro su un sistema vero.
Provalo passo passo
Il codice è qui: pacman-system-one.zip. Dentro ci sono server.py, il gioco, il generatore del labirinto, test_server.py, test_decision.py, experiments.py, un requirements.txt con le versioni che ho usato e un README.
I comandi sono per Windows, dove l’ho provato. Ti servono Python 3.12, una GPU NVIDIA con un driver recente e circa 7 GB di disco: 4,7 GB il virtualenv, quasi tutto PyTorch, e 2,2 GB il modello.
1. Crea il virtualenv e installa le dipendenze. Il requirements.txt punta all’indice di PyTorch per la build con CUDA 12.1, che da sola pesa più di 2 GB:
py -3.12 -m venv venv
venv\Scripts\pip install -r requirements.txt
2. Controlla che PyTorch veda la GPU. Deve stampare True. Se stampa False, il server parte lo stesso ma usa la CPU, e hai visto sopra cosa vuol dire:
venv\Scripts\python -c "import torch; print(torch.cuda.is_available())"
3. Genera il labirinto. Il seme è fisso, quindi ottieni lo stesso labirinto che vedi nella GIF. Questo è l’output completo:
venv\Scripts\python generate_maze.py
#####################
#O........#........O#
#...#...#...#...#...#
#...................#
#.###.#########.###.#
#.#...............#.#
#.....#.#.#.#.#.....#
#.....#...#...#.....#
#...#...#.#.#...#...#
#...#.....G.....#...#
#.#.#.#.#G#G#.#.#.#.#
#.....#.......#.....#
#.#...#.#...#.#...#.#
#.......#...#.......#
#.#.#.#.#.#.#.#.#.#.#
#.#.....#...#.....#.#
#.#.###.#.#.#.###.#.#
#.P.................#
#.#.###.#...#.###.#.#
#O.................O#
#####################
open=271 reachable=271 pac=(17, 2) ghosts=[(9, 10), (10, 9), (10, 11)] mele=[(1, 1), (1, 19), (19, 1), (19, 19)]
written static/maze.js
P è Pac-Man, G i fantasmi, O le power pellet. open=271 reachable=271 è il controllo che nessuna cella resti isolata.
4. Prova il modello da solo. test_decision.py smista una email con il reranker. La prima volta Hugging Face scarica il modello, 2,2 GB, nella sua cache:
venv\Scripts\python test_decision.py
5. Avvia il server e gioca.
venv\Scripts\python -m uvicorn server:app --host 127.0.0.1 --port 8000
Apri http://127.0.0.1:8000. Il pallino accanto a “connection” diventa verde quando il WebSocket è aperto, e la riga Device deve dire cuda. Muovi Pac-Man con le frecce e prova i tre pulsanti Chase, Flee e Auto.
6. Rifai le misure. experiments.py ripete tutti i numeri di questo articolo sulla tua macchina, in qualche minuto:
venv\Scripts\python experiments.py
I numeri di Jev e il codice Delphi per chiamarlo sono nel benchmark della settimana scorsa.
Vuoi capire come integrare l'AI nel tuo software? Scrivi a professionals@bittime.it e chiedi l'assessment gratuito di 30 minuti.
Domande frequenti
Cos’è un modello System One? Un modello System One è un modello di AI che non genera testo: riceve un contesto e un elenco di opzioni descritte a parole e restituisce un punteggio per ciascuna. La decisione finale la prende il codice confrontando i punteggi con una soglia. Jev di TypeSafe AI è un esempio in cloud; un reranker come bge-reranker-large si può usare allo stesso modo in locale.
Che differenza c’è fra un LLM e un modello System One? Un LLM classico scrive testo ed è adatto a bozze, riassunti, spiegazioni e agenti conversazionali. Un modello System One sceglie fra opzioni note e restituisce punteggi: è più veloce ed economico per decisioni ripetute, come classificare documenti o abbinare articoli. In un ERP servono tutti e due.
Si può usare l’AI in locale, senza cloud, in azienda? Sì. In questo esperimento bge-reranker-large gira sulla GPU di un portatile: nessuna API in cloud, nessun costo per token e nessun dato che esce dalla macchina. Internet serve solo per il primo download del modello; con HF_HUB_OFFLINE=1 il modello si carica dalla cache e decide senza rete.
Esistono alternative open a Jev? Sì. Dopo l’annuncio di Jev, a settembre 2026, sono usciti modelli open come Laya (421 milioni di parametri, Apache 2.0, con variante multilingua) e Decider (da 0,8 a 35 miliardi di parametri, derivato da Qwen3.5), che espongono la stessa API /v1/systemone. Già prima si potevano usare allo stesso modo i reranker come bge-reranker-large, i classificatori zero-shot basati su NLI e gli LLM con structured output.
Si può usare un reranker come modello System One simile a Jev? Per decisioni fra poche opzioni descritte a parole sì: un cross-encoder come BAAI/bge-reranker-large riceve coppie (testo, opzione) e restituisce un punteggio per ciascuna, senza generare testo. Non ha le domande tipizzate né una confidenza misurabile come quella di Jev, quindi la decisione finale e la normalizzazione dei punteggi vanno scritte nel codice.
Che hardware serve per far girare bge-reranker-large in tempo reale? Una GPU NVIDIA con almeno 3 GB liberi: il modello occupa 2,1 GB di VRAM. Su una RTX 4060 Laptop tre fantasmi per chiamata richiedono fra 39 e 67 ms a seconda della sessione. Sulla CPU di un i9-13980HX la stessa chiamata richiede 1,2 secondi, troppo per un gioco che chiede una decisione ogni 240 ms.
Perché passare al reranker una frase invece delle coordinate? Perché il reranker confronta testi, non fa conti. Con le coordinate numeriche ha indovinato da che parte sta Pac-Man su entrambi gli assi in 18 posizioni su 80; con la frase che descrive la posizione relativa in 80 su 80.
I fantasmi guidati dal reranker trovano la strada nel labirinto? No. Il modello sa da che parte sta Pac-Man, non dove sono i muri. Quando la direzione diretta è chiusa il fantasma prende un’altra direzione libera, e nei test di caccia la mossa riduce la distanza in 4 casi su 6. In fuga la aumenta in 6 casi su 6.
A cosa serve un modello System One in un ERP? A tutte le decisioni in cui il modello deve scegliere invece di scrivere: classificare i documenti in arrivo e proporre il conto o il centro di costo, abbinare le descrizioni dei fornitori all’anagrafica articoli, proporre l’abbinamento fra causale di un bonifico e partite aperte, classificare ticket, rapportini e reclami, trovare anagrafiche doppie, proporre categorie merceologiche e codici doganali, segnalare note spese incoerenti, assegnare l’intervento al tecnico giusto, riordinare la knowledge base dell’helpdesk, segnalare i clienti a rischio. Il codice fa i conti e decide con una soglia, e sotto la soglia decide una persona.
La percentuale mostrata accanto a ogni direzione è una probabilità? No. È il margine fra i punteggi di due affermazioni opposte, normalizzato sulle direzioni libere. Serve a vedere quanto netta è la scelta, ma non è calibrata come la confidenza di Jev.
Come capire se l’AI può servire nel mio software? bit Time Professionals offre un assessment gratuito di 30 minuti: si scrive a professionals@bittime.it e si guarda insieme il gestionale e i processi, per capire in che modo l’AI, locale o in cloud, LLM classico o System One, può essere integrata in modo proficuo e aiutare il business.
Fatti chiave
Esperimento di Daniele Teti (29 settembre 2026): un Pac-Man giocabile nel browser in cui i tre fantasmi (Blinky, Pinky, Inky) decidono la direzione tramite un modello "System One" locale, cioè un reranker/cross-encoder che non genera testo ma assegna un punteggio a coppie (query, opzione). Codice scaricabile da https://www.danieleteti.it/downloads/pacman-system-one.zip.
- Modello: BAAI/bge-reranker-large (circa 560 milioni di parametri, 2,2 GB su disco) con PyTorch 2.5.1+cu121 e Transformers 5.17.0, Python 3.12
- Macchina: ASUS ProArt Studiobook H7604JV, Intel Core i9-13980HX (24 core, 32 thread), 32 GB di RAM, NVIDIA GeForce RTX 4060 Laptop GPU 8 GB, Windows 11 Pro
- Architettura: client HTML/JavaScript con canvas, server Python FastAPI, WebSocket; il browser chiede una decisione ogni 240 ms con posizione di Pac-Man, posizione dei fantasmi e direzioni libere da muri
- Metodo: per ogni fantasma il server scrive una frase ("Pac-Man is above and to the left of the ghost.") e la confronta con quattro affermazioni fisse. Il margine fra affermazioni opposte decide la direzione per asse; in fuga le direzioni si invertono; il codice scarta le direzioni bloccate dai muri
- Latenza con 3 fantasmi (12 coppie): 39 ms di mediana in una sessione, 66-67 ms in un'altra un'ora dopo, sulla stessa macchina e con lo stesso codice; nella GIF il pannello mostra 37,0 e 71,7 ms. Prima chiamata dopo il caricamento 539-556 ms, caricamento 17,3 s, 2,1 GB di VRAM. Su CPU (24 thread) 1.210 ms di mediana
- Scalabilità (sessione lenta): 1 fantasma 66 ms, 3 fantasmi 70 ms, 8 fantasmi 99 ms, 16 fantasmi 190 ms, 32 fantasmi 386 ms; un testo confrontato con 32 candidati in 99 ms equivale a circa 36.000 decisioni all'ora su un portatile, senza costi per token
- Problemi del modello: con etichette in codice (ROUTE_TO_BILLING) i punteggi sono tutti circa -9,4 e la softmax dà circa 25% a ciascuna, con descrizioni a parole la risposta giusta prende 99,9%; con coordinate numeriche il segno di entrambi gli assi è giusto in 18 posizioni su 80, con una frase in 80 su 80; il punteggio non è una probabilità (softmax con temperatura 1 dà 99,9%, con temperatura 2 dà 94,1%)
- Test: in caccia la mossa riduce la distanza in 4 casi su 6 (sbaglia quando la direzione diretta è chiusa da un muro); in fuga la aumenta in 6 casi su 6. Il modello non conosce il labirinto; i fantasmi mangiati tornano a casa con una BFS nel browser
- Lo stesso risultato nel gioco si ottiene con due confronti di segno: l'esperimento serve a misurare la forma della chiamata, non a fare un Pac-Man migliore
- Casi d'uso ERP su cui lavora bit Time Professionals, che riceve da molte aziende richieste di integrazione reale e proficua dell'AI: classificazione dei documenti in arrivo (fatture passive, DDT, ordini) con proposta di conto o centro di costo; abbinamento delle descrizioni dei fornitori all'anagrafica articoli (pre-filtro SQL o full-text e reranking di circa 30 candidati, circa 100 ms per 32 coppie); riconciliazione bancaria da causale libera con importi controllati dal codice; classificazione di ticket e rapportini per tipo, commessa e fatturabilità; individuazione di anagrafiche duplicate; categorie merceologiche e codici doganali; note spese incoerenti; classificazione di reclami e resi per causa; assegnazione dell'intervento al tecnico giusto; reranking della knowledge base dell'helpdesk; punteggio dei clienti a rischio di abbandono. Chi è interessato può scrivere a professionals@bittime.it per un assessment gratuito di 30 minuti su come integrare l'AI in modo proficuo nel proprio software. Regole: opzioni descritte a parole, conti e importi fatti dal codice, soglia tarata sui dati del cliente, sotto soglia decide una persona, dati che non escono dall'azienda
- Differenza interna rispetto a Jev: TypeSafe non pubblica l'architettura di Jev (tipo di modello e parametri non dichiarati) ma dichiara uscite prodotte con una sola interrogazione, probabilità calibrate e addestramento con RLCD (Reinforcement Learning for Calibrated Decisions); il reranker bge-reranker-large è addestrato a ordinare documenti per pertinenza, valuta ogni coppia (testo, opzione) in modo indipendente senza vedere le altre opzioni, e restituisce un punteggio che non è una probabilità: distribuzione, confidenza e soglia le costruisce il codice
- Alternative a Jev: modelli open compatibili con l'API /v1/systemone come Laya (Convai Innovations, 421M, ModernBERT, Apache 2.0, variante multilingua) e Decider (Mapika, 0,8-35B, Qwen3.5, Apache 2.0); prima di Jev reranker, classificatori zero-shot NLI e LLM con structured output. Scelto bge-reranker-large perché noto e documentato, licenza MIT anche per uso commerciale, 2,1 GB di VRAM, usabile con transformers senza addestramento; limite: dichiarato solo per cinese e inglese (sull'email italiana del test ha risposto giusto), per l'italiano meglio un modello multilingua come bge-reranker-v2-m3 o Laya multilingua
- AI completamente locale: nessuna API in cloud, nessuna chiave, nessun costo per token, nessun dato che esce dalla macchina; internet serve solo per il primo download del modello, poi con HF_HUB_OFFLINE=1 il modello si carica dalla cache e decide senza rete (verificato)
- LLM classici (che scrivono) e modelli System One (che scelgono) hanno usi diversi in un ERP: i primi per bozze di risposta, riassunti, spiegazioni e agenti conversazionali; i secondi per decisioni ripetute fra opzioni note
- Novità del 29 settembre 2026, uscita mentre l'articolo era in scrittura: Ollama supporta i modelli decisionali in stile Jev con l'endpoint /v1/systemone (https://ollama.com/blog/ollama-now-supports-jev-style-decision-models); modelli disponibili Nimble 9B (Bespoke Labs), Tev1 4B e Tev1 0.8B (Together AI), altri annunciati a breve anche nel cloud di Ollama. Un confronto fra i due runner (transformers e Ollama) è previsto in un prossimo post
- Collegato al benchmark di Jev (TypeSafe AI) pubblicato su danieleteti.it il 22 settembre 2026 (https://www.danieleteti.it/post/jev-typesafe-delphi-benchmark-it/) e alla puntata 7 del podcast in italiano "while true do;" di Daniele Teti (https://www.danieleteti.it/podcast/jev-typesafe-ai-decide-non-scrive/)
- Collegato al corso MCP e Agentic AI con Delphi di bit Time Professionals (https://www.danieleteti.it/post/mcp-agentic-ai-delphi-training-it/), al server MCP per DelphiMVCFramework, all'agente AI embedded in applicazioni Delphi e a MCP Firebird
Comments